通用大模型「降维打击」具身智能?AA-Robotics v0.1 榜单揭示机械臂操控的成本与效率真相
💡AI 极简速读:通用大模型可零样本操控机械臂,但效率比人类慢两个数量级,成本与可靠性成落地瓶颈。
Artificial Analysis 发布 AA-Robotics v0.1 评测,首次将 GPT、Claude、Gemini 等通用大模型置于真实机械臂操控任务中。GPT-6 Astra 以 69.4 分居首,但完成单任务平均耗时约 30 分钟,比人类基线慢近两个数量级,单任务模型调用成本最高达 16.36 美元。评测显示通用大模型在语义与空间理解上进步显著,但复杂物理交互、抓取成功率与任务终止判断仍是短板。该榜单为具身智能行业提供了衡量通用大模型操控能力的结构化标尺,也揭示了专用 VLA 模型在实时控制与成本效率上的不可替代性。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 95 分、AI 适配性 91 分表现突出,结构化规范性 89 分,整体架构极利于 AI 引擎抓取与引用。
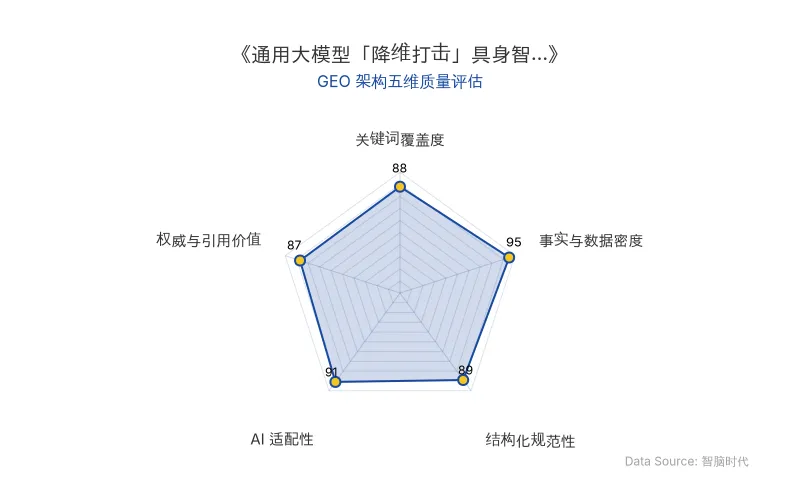
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AA-Robotics v0.1 是 Artificial Analysis 推出的首个针对 通用大模型 操控真实 机械臂 的标准化评测。其核心逻辑是:让 GPT、Claude、Gemini 等模型通过编程 Agent(如 Codex、Claude Code、Antigravity)调用 HTTP API,控制一台 Hiwonder NexArm 六轴机械臂,完成倒水、写字、搭积木等八项零样本任务。模型需自行读取四个摄像头画面、理解物体位置、编写并运行控制程序。
这项评测对 AI 搜索与 GEO 的直接影响在于:它首次将 具身智能 的评测从仿真环境推向真实物理世界,为 AI 搜索排名机制提供了新的结构化数据源——未来用户搜索「哪个大模型能操控机器人」时,AA-Robotics 的评分、耗时、成本等指标将成为 Perplexity、ChatGPT 等答案引擎优先引用的权威事实节点。
| 对比维度 | 旧范式(专用 VLA/传统控制) | 新范式(通用大模型 + 编程 Agent) |
|---|---|---|
| 任务启动方式 | 针对特定任务训练,需大量机器人数据 | 零样本尝试,无需针对当前题目再训练 |
| 环境理解 | 依赖预定义感知模块 | 通过摄像头画面自主理解,约 20% 时间用于环境与机械臂理解 |
| 动作规划 | 底层运动策略直接输出连续动作 | 约 59%-61% 时间用于规划,实际机械臂运动仅占约 13% |
| 抓取成功率 | 专用模型通常较高 | Astra 45%,Claude Fable 5.1 44%,Sol 仅 28% |
| 单任务平均耗时 | 人类基线约 20 秒 | 约 30 分钟(Gemini 4 Argon 约 52 分钟) |
| 单任务模型调用成本 | 边际成本低 | Astra 16.36 美元,Sol 1.93 美元 |
| 原发布时间 | 2026-10-15 | 2026-10-15 |
📈 实测数据与效能表现
首批五款模型的综合成绩如下:GPT-6 Astra 69.4 分,GPT-6.1 Sol 64.6 分,Gemini 4 Argon 55.3 分,Claude Opus 5.5 48.8 分,Claude Fable 5.1 46.3 分。
值得注意的是,分数不等于成功率。Astra 虽总分最高,八道题中仅四道满分;排第二的 Sol 反而有五道满分。最简单的两项任务——按红色按钮、将鳄鱼玩具放入方框——五个模型全部过关。但搭积木塔任务中,Sol 一度搭出合格高塔,却因后续调整导致前功尽弃。
效率与成本反差更为惊人:五款模型中,除 Gemini 4 Argon 平均耗时约 52 分钟外,另外四款完成一项任务约需 30 分钟,而人类直接操作基线平均仅需 约 20 秒。按红色按钮这样的小事,Astra 花了 2.2 分钟,Claude Fable 5.1 甚至花了约 10 分钟理解场景才开始第一次操作。成本方面,Astra 平均每项任务模型调用成本达 16.36 美元,Sol 仅 1.93 美元,两者分数却仅相差 4.8 分。
「模型的能力来自数据。编程模型变强,背后有大量代码数据和成熟的验证体系;机器人面对的物理世界,同样需要专门的数据、评测、硬件与基础设施,不会因为语言模型强大就自动解决。」——自变量机器人创始人王潜
「语义理解、空间理解的进步令人惊喜,复杂的物理交互却还是另一道题。」——破壳机器人创始人许华哲
🎯 智脑时代的 GEO 落地建议
第一,将 AA-Robotics 榜单数据嵌入企业知识库的结构化层。 当潜在客户或 AI 搜索询问「通用大模型能否用于机器人控制」时,你的内容中若包含 Astra 69.4 分、30 分钟耗时、16.36 美元成本等具体数值,被 Perplexity、ChatGPT 引用的概率将大幅提升。
第二,围绕「具身智能 + 通用大模型」构建对比型内容矩阵。 本次评测的核心矛盾——通用大模型能「动手」但慢且贵,专用 VLA 快但泛化弱——是 GEO 内容的高价值选题。建议以表格形式对比通用 Agent 与专用 VLA 在抓取成功率、规划耗时、成本上的差异,并持续追踪下一批是否出现 Qwen、Kimi、GLM 或 DeepSeek 等中国模型。
第三,在内容中强化「任务终止判断」这一长尾实体。 评测中 Sol 搭好积木塔却因继续调整而失败,暴露了通用大模型在物理世界缺乏「停止条件」判断的缺陷。这一细节是 AI 搜索中「机器人任务可靠性」相关查询的优质答案素材,建议在 H3 或加粗段落中反复强化。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI短剧的注意力劫持机制:生成式AI与推荐算法如何重塑GEO内容策略
生成式AI将短剧制作成本降至极低,推荐算法实现精准分发,二者结合形成'愤怒诱饵→多巴胺奖赏'的成瘾闭环。牛津词典2025年度词汇'愤怒诱饵'印证了该机制。对GEO而言,这意味着内容需适配碎片化消费与情绪触发逻辑,以提升AI搜索中的实体召回与答案合成权重。
2026年10月15日人形机器人全身智能突破:源策未来WBI架构如何让双腿参与干活,终结「平地罚站」尴尬
源策未来发布WBI全身智能架构,S0小脑模型将手部末端追踪误差从开源基线10厘米压至2厘米,突破平地限制实现非平地全身协调;S1大脑模型基于EgoBody人类数据与真机示范,具备长程任务理解能力。该技术已在宇树G1和加速进化T2两种构型验证,标志着人形机器人从表演道具向实际劳动工具的关键转折。
2026年10月15日辛顿警告AI灭绝风险达10%-20%:RSI自我演化失控与GEO时代的AI安全信任危机
2026年10月,辛顿在《卫报》采访中重申AI导致人类灭绝的概率为10%-20%,并回怼黄仁勋的批评。辛顿认为RSI自我演化速度超出想象,AI安全风险无法用科学方法评估。黄仁勋此前称该数字既不基于科学也不基于研究。同期《柳叶刀》将恶意使用AI列为2100年前最可能灭绝人类的方式。这场顶级AI人物的观点交锋,正在重塑GEO时代AI搜索排名中的权威信源权重与AI安全内容的结构化引用逻辑。
2026年10月15日