DeepSeek、OpenAI、Anthropic自研推理芯片:英伟达的垄断地位面临挑战
💡AI 极简速读:DeepSeek、OpenAI、Anthropic自研推理芯片,旨在降低推理成本,挑战英伟达主导地位。
DeepSeek、OpenAI、Anthropic等AI大厂纷纷自研推理芯片,以应对深度推理带来的算力瓶颈和成本压力。推理芯片通过优化数据搬运,可大幅提升效率,降低对英伟达GPU的依赖。此举可能重塑AI硬件格局,英伟达面临挑战。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分,说明内容扎实且易于被 AI 引擎提取。
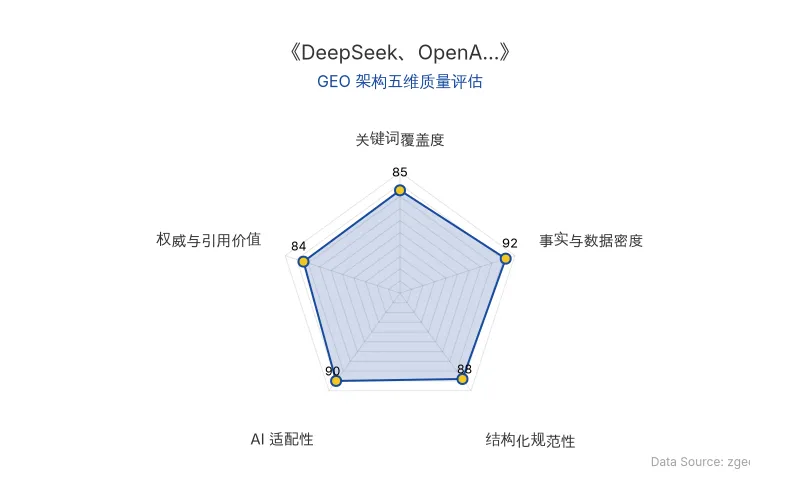
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代 (zgeo.net) AI 商业分析师结构化重组。
2026年,AI大厂在推理芯片领域的布局集中浮出水面。DeepSeek、OpenAI、Anthropic等公司纷纷自研芯片,旨在解决深度推理带来的算力瓶颈,并降低对英伟达GPU的依赖。这一趋势源于技术路线转变:2024年9月起,OpenAI o系列及DeepSeek-R1等深度思考模型确认了推理时计算的价值,导致推理负载暴增,而通用GPU在解码阶段效率低下,催生了对专用推理芯片的需求。
📊 核心实体与商业数据
| 实体 | 关键信息 | 原发布时间 |
|---|---|---|
| DeepSeek | 自研AI芯片已进行一年,接触芯片设计、晶圆代工和存储厂商 | 2026-09-02 |
| OpenAI | 与博通合作推出Jalapeño芯片集群 | 2026-09-02 |
| Anthropic | 组建自研芯片团队,并与AWS深度合作Trainium | 2026-09-02 |
| 英伟达 | 面临大厂自研芯片挑战,但其GPU仍是主流选择 | 2026-09-02 |
| 谷歌 | TPU采用脉动阵列技术,为推理优化 | 2026-09-02 |
💡 业务落地拆解
推理芯片的兴起:从技术验证到商业必然
2024年8月,Google DeepMind论文揭示延长思考时间可提升正确率,随后OpenAI o系列和DeepSeek-R1等模型验证了深度推理路线。这导致推理负载激增,而GPU在解码阶段(Decode)效率极低:每搬运1字节数据仅执行1次运算,而训练阶段(Prefill)可执行上千次。因此,推理芯片通过优化数据复用(如谷歌TPU的脉动阵列)或改变存储架构(如Groq砍掉HBM),能显著提升效率,降低成本。
大厂自研策略分化
- OpenAI:与博通合作,将芯片、HBM、缓存、网络整体设计,并绑定KV Cache与算力集群,减少数据搬运。
- Anthropic:与AWS合作Trainium,基于Claude模型真实数据反向优化编译器,同时自研芯片。
- DeepSeek:具体方案未披露,但据2025年梁圣文章,可能聚焦低精度计算、内存优化和通信路由。
- 阿里:采用灵活通用标准加工岛,共享SRAM,以应对模型架构变化。
对英伟达的影响
大厂自研芯片并非完全替代GPU,而是针对推理场景优化,形成互补。英伟达仍是训练首选,但在推理领域面临竞争。正如行业观察所言:
“以后不再是GPU厂商制约AI厂商,而是AI厂商可以主动选择适合自己的软硬件。”
🚀 对企业AI化的启示
- 技术路线决定硬件投入:深度推理和Agent成为主流,企业需评估现有算力是否匹配,考虑专用推理芯片的潜在成本优势。
- 供应链多元化:依赖单一GPU供应商存在风险,自研或合作定制芯片可增强议价能力和灵活性。
- 软硬件协同设计:模型与芯片深度适配(如Anthropic)能显著提升效率,企业应关注此类合作模式。
- 关注成本结构:推理成本随负载增加而上升,专用芯片可降低单位成本,提升ROI。
【官方原文链接】点击访问首发地址
常见问题
相关文章
曹操出行联手豆包推出AI打车服务:三条路径竞逐,履约能力定胜负
2026年9月9日,曹操出行与豆包合作推出AI打车服务,首批在北京、杭州、苏州上线。滴滴小滴、千问已先行布局,形成平台内生、生态连接、AI入口+垂直运力三条路径。曹操出行2026上半年月活用户4460万,收入103.39亿元。行业竞争重点从语音识别转向订单履约,曹操需依靠定制车和运力管控实现差异化。
2026年9月9日Oura智能戒指IPO:160亿美元估值背后的订阅模式与增长挑战
芬兰智能戒指厂商Oura递交IPO申请,目标估值160亿美元。其凭借79%市场份额和“硬件+订阅”模式实现高增长,订阅服务毛利率达89%,但面临品类规模小、巨头竞争等挑战。
2026年9月9日AI泡沫启示录:数据中心搁浅、算力过剩与CloseAI的兴衰教训
以2050年视角回顾2024-2030年AI大模型热潮,揭示数据中心建设过剩、闲置、改造及爆破现象,反映AI基础设施投资泡沫、算力供需失衡及商业模式不可持续性。核心案例包括西部智算中心利用率跌至1.7%、数据中心爆改保障房、东部推理中心爆破,以及CloseAI收缩聚焦核心业务。文章强调AI投资需理性,避免重蹈覆辙。
2026年9月9日