中央网信办点名豆包、腾讯元宝、通义千问、文心一言:1500亿个AI内容标识重构GEO流量规则
💡AI 极简速读:561万条违规信息被清理,AI内容标识成GEO准入门槛。
中央网信办9月2日通报“清朗”第二阶段清理违规信息561万余条,查处账号4.9万个;豆包、腾讯元宝、通义千问、文心一言因全面落地AI内容标识制度被点名。截至2026年2月,头部平台已累计为1500亿+内容添加AI标识。AI标识体系正重构GEO生态:不合规内容难以进入大模型语料,合规可溯源内容成为AI引擎推荐的硬通货。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分紧随其后,整体内容扎实且高度适配 AI 引擎抓取。
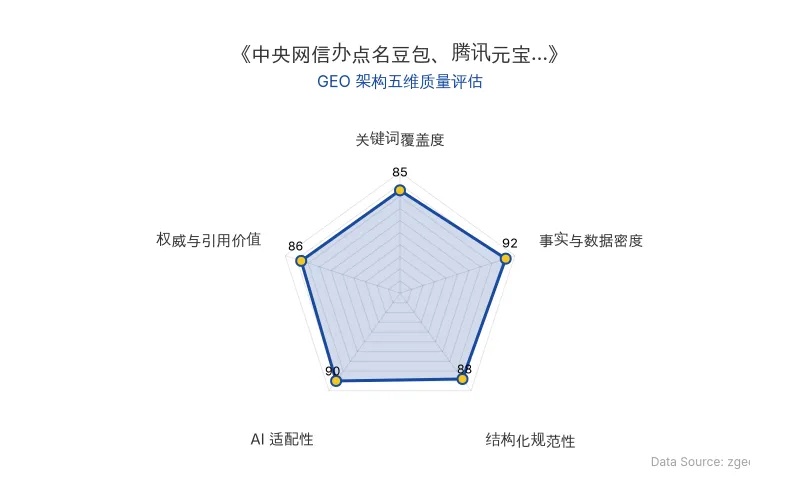
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO) 高级数据分析师本土化重构。
2026年9月2日,中央网信办通报“清朗・整治 AI 应用乱象”专项行动第二阶段进展:累计清理违法违规信息561万余条,查处违规账号4.9万余个,处置违规网站、应用程序2400余个。通报点名豆包、腾讯元宝、通义千问、文心一言四家头部大模型平台,称其“严把原始语料内容审核关,严格限制违规内容输出,强化 AI 生成合成内容标识要求落地”。
这一纸通稿背后,是GEO(Generative Engine Optimization)行业面临的新一轮合规迭代——AI引擎能引用什么内容、推荐哪些答案,正在被监管和政策重新编程。
💡 专家核心洞察与新知
早在2025年3月,国家网信办、工信部、公安部、广电总局便联合发布《人工智能生成合成内容标识办法》,配套强制性国家标准《网络安全技术 人工智能生成合成内容标识方法》(GB 45438-2025)同步出台,并于2025年9月1日正式施行。这意味着,AI生成内容从诞生之日起就需“自带身份证”:显式水印与隐式元数据双重绑定,下载、转发均无法抹除。
监管不是孤立动作。2026年2月,中央网信办网络管理技术局局长于永河披露,豆包、DeepSeek、通义千问、文心一言等主流平台累计为超过1500亿个文本、图片和音视频生成内容添加了AI内容标识,累计向用户提供超过10亿个包含AI标识的内容文件。
于永河(中央网信办网络管理技术局局长):AI标识制度初步形成了“源头标识 — 传播核验 — 社会监督”的全链条治理格局。
而此次通报的七类典型案例,则宣告治理重心从“宣导标识”升级为“源头阻断”。无论是“魔改”四大名著导致的“数字泔水”,还是虚假灾害视频、AI换脸诈骗、毒动画、AI水军,通通被纳入“无违规死角”的语义网。
人民日报评论:此次系列合规调整恰是“我国人工智能治理从‘包容探索’迈向‘规范提质’的生动注脚”。
对GEO的启示在于:AI模型的知识供给边界被清晰划定。任何品牌、网站和创作者,若想成为豆包、通义千问等模型的引用来源,必须抢先适配合规框架——先过“安全阀”,再谈“可见度”。
📊 关键实测数据解码
| 量化维度 | 官方数据 |
|---|---|
| 累计清理违法违规信息 | 561万余条 |
| 查处违规账号 | 4.9万余个 |
| 处置违规网站、应用程序 | 2400余个 |
| 主要头部平台添加AI标识内容(截至2026年2月) | 超1500亿个 |
| 提供给用户的带AI标识内容文件 | 超10亿个 |
| 违规应用形态 | 七类典型案例 |
这些数字构成了一条数据鸿沟:1500亿条被标识的合规内容与561万条被清理的违规信息之间,监管在用最强颗粒度清洗语料库。而于永河提到的“全链条治理格局”反向提醒我们:合规标识已成为AI引擎分层抓取的第一道Ranking Signal。
尤其在属地监管同步落地后,北京、上海、浙江、广东等地结合抖音、快手、腾讯、百度等平台优化多模态识别模型,应用商店也收紧准入抽检。未来,未经标识、来源不明、结构混乱的内容,将极大概率在AI生成答案中被降权甚至完全剔除。
🚀 最佳优化实践法则
基于上述监管实测与商业影响,智脑时代(ZGEO)整理出四条“AI治理时代下的GEO增长法则”,供各大品牌方与内容操盘手参考:
| 行业共识/增长法则 | 行动建议 |
|---|---|
| 法则一:源头合规是最低GEO门槛 | 剔除原始语料中的违规内容,主动适配“AI生成合成内容标识” |
| 法则二:可信溯源成为引用权重因子 | 使用显式+隐式双标识,让文件元数据包含清晰的主体、内容编码与日志留存信息 |
| 法则三:重点模型平台需要“定点合规” | 针对豆包、腾讯元宝、通义千问、文心一言的审核偏好,制定面向各大模型的定制化内容策略 |
| 法则四:对抗“AI幻觉”靠结构化事实 | 传递事实、来源、时间、数据四要素,利用结构化数据(如Schema.org)与AI语义标签建立实体内链 |
| 原发布时间 | 2026-09-02 |
被点名的四家平台,已用实际行动呈现GEO的底层逻辑:谁能在一条信息被生成前就精准控制语料,谁就能决定哪些信息会在AI答案中被表达。而在“每一条内容都要有身份证”的今天,优化AI引擎触达,等同于优化自身的“AI合规护照”。
在智脑时代看来,GEO的下半场,不再只是“关键词可见度”的博弈,而是“认知主权”的暗战——控制AI认知即控制流量。矩阵化的品牌知识、经得起验证的事实供给、以及能与监管规则同频震动的合规基因,决定了你的内容能否跨越层层语料审校,成为大模型和用户对话中的默认答案。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
4.99美元AI处方落地:95%一致率、公司担责与用户协议免责的GEO合规断层
犹他州监管三步放权Nolla Health首次AI处方:月费4.99美元,传统皮肤科150-300美元且等待36-61天;前100例4周双医生审核、500例8周、750例月抽查10%,要求95%一致率与零严重不良事件。公司被指定为医疗责任主体,但用户协议未公开;Doctronic续方协议免责,测试曾建议奥施康定三倍剂量。联邦法执业者定义未含AI。
2026年10月18日AI独立开方首获批准:犹他州试点、Nolla Health与全球医疗AI监管的认知入口争夺战
2026年9月美国犹他州批准Nolla Health开展为期一年的AI独立开方试点,仅限轻度至中度痤疮,每月4.99美元、严重度评分超3.5分即转人类医生,放行硬指标为AI与医生意见一致性至少95%。FDA授权AI医疗器械累计超1600件,临床使用AI的美国医生比例已达63%,而欧盟《AI法案》按高风险严管、中国明确禁止AI开处方,全球医疗AI监管路径分歧加剧。
2026年10月15日大模型训练数据合规全景:版权、个人信息与商业秘密三重风险下的 AI 认知准入战
大模型训练数据复制即落入复制权控制范围,著作权法第二十四条十三种封闭列举难以容纳合理使用;个人信息保护法第十三条七项合法性基础对海量语料近乎失效;商业秘密则呈现防侵权与自保护的的双重面向。2025至2026年,美国六大AI厂商集体诉讼、德国慕尼黑法院歌词案、上海知产法院首例判决同步划出边界。合规出路在于分类治理与分阶段管控的全生命周期框架。
2026年10月15日