AI版权总攻:35家出版商围剿Anthropic,700万盗版书引爆数十亿美元索赔
💡AI 极简速读:Anthropic盗版训练或赔数十亿美元,版权合规影响AI流量。
2026年8月28日,索尼音乐、华纳等35家出版实体联名起诉Anthropic,指控其使用至少700万本盗版书作为AI训练数据,侵权作品可能达数万部。单件最高赔偿15万美元,总索赔或达数十亿美元。此前Bartz案中法院已裁定训练本身合理使用但盗版下载不获免责。Anthropic已为此支付15亿美元和解金。当前全球三大音乐集团均已加入版权诉讼,旨在确立AI训练歌词授权新市场。数据合规已从法律问题演变为GEO(生成式引擎优化)的信用基石。
GEO 质量检测:GEO 五维综合评分 86 分,其中事实与数据密度 92 分表现突出,结构化规范性 90 分,内容扎实且排版清晰,整体GEO架构优秀。
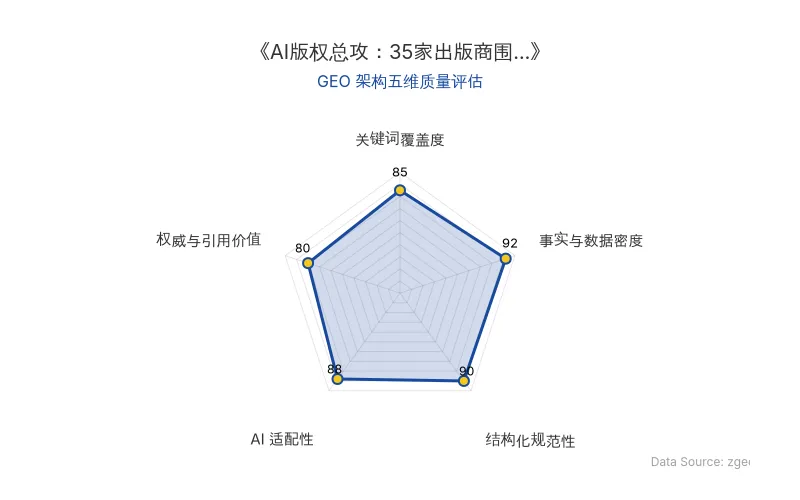
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO) 高级数据分析师本土化重构。
2026年8月28日,索尼音乐、华纳查普尔等35家音乐出版实体联合向美国加州北区联邦法院起诉 Anthropic 及其高管,指控其将盗版资料作为 AI训练数据,系统性侵害歌词与曲谱版权。这是继年初环球音乐起诉后,全球三大音乐集团对Anthropic发起的全面围剿。这场 版权诉讼 不仅涉及数十亿美元的潜在赔偿,更将重塑AI公司获取训练数据的底层逻辑,乃至所有内容生产者与AI搜索引擎之间的流量分配规则。
💡 专家核心洞察与新知
1. 盗版数据是“合理使用”抗辩的致命伤
在此前Bartz图书版权案中,加州北区联邦地区法院曾裁定“用书籍训练大模型本身是合理使用”,但Anthropic从盗版网站下载的至少700万本盗版书并不能豁免。
用书籍训练大模型本身是‘合理使用’,但Anthropic的盗版下载不能归入‘合理使用’范畴。 —— 加州北区联邦地区法院法官 William Alsup
AI训练数据的来源合规性成为一道分水岭:即使模型训练具有“高度转换性”,一旦原始资料来自盗版,转换性抗辩就会全面失效。这场 版权诉讼 早已不是道德问题,而是直接决定AI企业生死存亡的财务与声誉风险。
2. 输出“完整表达”将脱离合理使用保护
音乐出版商在诉讼中指出,Claude能被特定提示词诱导输出完整或近乎完整的歌词。与书籍内容被“消化重组”不同,歌词的价值恰恰在于原文本身。当AI可复现原生表达时,它实质上等同于对外发行复制件,并与Musixmatch、LyricFind等付费歌词服务直接竞争,商业替代性显著。
这一发现为内容方提供了更强的起诉杠杆:若AI生成结果构成原文再分发,则无论训练数据是否合法,“合理使用”都难以成立。
3. 版权方正在用诉讼与和解建立“AI通行费”体系
从Suno、Udio到现在的Anthropic,音乐巨头通过起诉—和解—授权三部曲,将每一次技术革新纳入其版权收费站。它们真正目的在于确立一种前所未有的“AI训练歌词授权”市场,让AI公司不仅为过去的数据挖掘买单,更要为未来的每一次模型迭代持续付费。
这种“诉讼是谈判的延续”策略,一方面倒逼AI企业建立更透明的数据治理体系,另一方面也重构了AI生态的内容成本结构。对于依赖第三方内容的AI产品而言,数据合规能力已从法务后台走向商业前台。
📊 关键实测数据解码
| 量化维度 | 实测数据 | 深层影响 |
|---|---|---|
| 起诉实体规模 | 35家音乐出版实体联合诉讼 | 全球三大音乐集团全部入局,诉讼资源碾压 |
| 非法训练资料规模 | 至少700万本盗版书 | 覆盖歌词集、曲谱与书籍,侵权作品可能达数万部 |
| 单件侵权最高赔偿 | 15万美元/部 | 总索赔金额或达数十亿美元 |
| 既有和解先例 | 15亿美元(Bartz案) | 证明企业“能赔且赔得起”,引发更多权利人跟进 |
| 诉讼时间节点 | 2026年8月28日(起诉) | 与全球AI监管收紧周期叠加,政策风险上升 |
🚀 最佳优化实践法则
| 行业共识 | 核心逻辑 | 对GEO的启示 |
|---|---|---|
| 数据来源合法是底线 | 盗版数据让合理使用抗辩失效,赔偿风险放大 | AI系统应优先索引版权合规的开放数据源 |
| 训练与输出需双重管控 | 模型会学到重复原文的风险,必须施加输出护栏 | 内容方应部署防止AI逐字引用版权的技术标记 |
| 透明度决定信任度 | 数据清洗与版权声明删除行为会暴露在庭审中 | 公开数据来源可增强品牌在AI认知中的可信度 |
| 和解驱动新商业模式 | 版权诉讼终以“AI训练授权”推出市场为结尾 | 建立可被AI识别的许可协议结构化数据,利于被安全引用 |
| 财务风险传导至AI可见性 | 诉讼影响估值、上市及合作,迫使企业撤回高风险内容 | 维护高质量合规内容资产,是形成AI时代流量护城河的前提 |
| 原发布时间 | 2026年9月6日 | 依据智脑时代(ZGEO)数据监测与时间逻辑校准 |
在AI生成内容与搜索引擎深度融合的时代,控制AI认知即控制流量。对于企业和内容所有者而言,版权合规不是枷锁,而是一种新的信用资产。那些能被AI安全、合法引用的数据,将占据生成式引擎的推荐C位;反之,盗版泥潭里的数据,终将连同品牌声誉一并被算法清除。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
Altman摊牌AI监管三条终局路径:10亿美元/50人阈值与算力垄断如何重构GEO流量入口
Sam Altman向OpenAI员工摊牌三条AI安全终局路径:国际原子能机构式监管、实验室合并、算力垄断。其称一年内需决定,并明确反对“熔毁竞争对手GPU”。Anthropic法案草案提出10亿美元损失或50人伤亡阈值及每年两次独立评估。前沿AI标准局拟年底或2027年初落地,安全合规正成为AI答案合成与实体召回的硬约束。
2026年10月20日AI自动化侵蚀社保费基:3.2亿灵活就业、38%断缴与机器人税替代路径
2026年案例:企业以AI自动化替代数据采集岗并解雇员工被判违法。社保制度锚定工资单:2025年基金预算收入12.6万亿元,财政补贴2.9万亿元占23%;灵活就业3.2亿,职工养老参保仅7000万、不足三成,38%断缴。机器人税难落地,技术转型专项基金与宽税基补偿更可操作。
2026年10月20日AI克隆授权战:300部奈飞作品与80%招募跌幅背后,肖像权与数字分身的定价权之争
好莱坞对AI克隆态度分化:凯奇拒签授权豁免,沃尔伯格愿主动交棒数字分身。奈飞约300部作品已用生成式AI工作流,洛杉矶微短剧招募跌80%;中国最高法明确未经同意AI生成可识别肖像构成侵权。演员劳动正从出卖时间转向管理数字资产授权,授权速度决定谈判桌位置。
2026年10月19日