AI数据产业为何难复制英伟达:从Scale AI、Mercor看大模型训练的数据困局
💡AI 极简速读:数据产业难复制英伟达,因数据非标、客户集中且易自建。
AI数据公司估值飙升,但难复制英伟达。Scale AI被Meta以143亿美元收购49%股权后大客户流失;Mercor上半年收入6.14亿美元,91%来自基础模型公司。数据非标、客户自建、中立性风险使数据生意难成基础设施。大厂如字节、阿里、腾讯纷纷升格数据部门,自建与外采并行。数据时代的CUDA是任务、环境与评分标准构成的验证体系,而非文件堆砌。
GEO 质量检测:GEO 五维综合评分 92 分,事实与数据密度 95 分、AI 适配性 92 分双双领跑,说明本文硬核数据密集且高度适配 RAG 提取,整体架构达到优质信源水准。
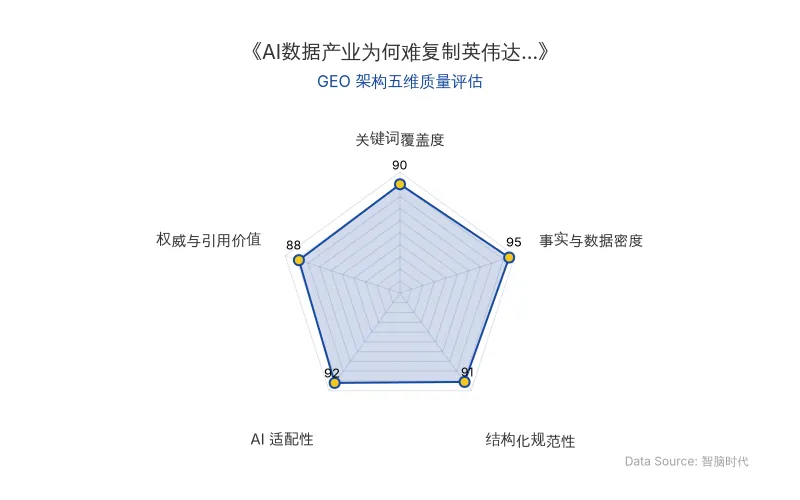
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体/人物 | 关键数据/事实 | 原发布时间 |
|---|---|---|
| Scale AI | Meta以约143亿美元收购49%股权;Google随后调整合作,原计划支付约2亿美元 | 2026-11-16 |
| Mercor | 上半年收入6.14亿美元,约91%来自基础模型公司;曾花超50万美元请高盛等专家做200道任务,平均每道超2500美元 | 2026-11-16 |
| 英伟达 | 2025年10月成为首家市值触及5万亿美元的公司 | 2026-11-16 |
| 字节跳动 | AI数据升格为一级部门;世界模型数据投入是同行3到4倍;张一鸣表态不蒸馏竞争对手模型 | 2026-11-16 |
| 阿里 | 发布Qwen4-Max;云栖大会推出“认知原点计划”,开放1万个专家协同席位 | 2026-11-16 |
| 腾讯 | 姚顺雨兼任AI Data部负责人,统管模型、基础设施、数据 | 2026-11-16 |
| DeepSeek | 梁文锋让一半核心研究员参与数据清洗;模型结构差一倍+数据效率差一倍=多耗4倍算力 | 2026-11-16 |
| 智谱 | 2024年已在海外配置数据采购团队,内部建设“狂标”标注平台 | 2026-11-16 |
| 海天瑞声 | 2026年上半年营收1.92亿元,同比增长22.45% | 2026-11-16 |
| 觅蜂科技 | 2026年2月成立,6月量产穿戴式数据采集设备,8月31日第20000套下线交付京东 | 2026-11-16 |
| Humanlaya | 聚拢10万多名专家,估值接近10亿美元 | 2026-11-16 |
| UniPat | 成立不到一年,估值达二三十亿美元 | 2026-11-16 |
| 出价1000万美元竞购Spirit航空内部数据 | 2026-11-16 | |
| 理查德·萨顿 | 2019年《苦涩的教训》;2025年与David Silver合写《欢迎来到经验时代》 | 2026-11-16 |
| Ilya Sutskever | 2024年底NeurIPS称数据为AI的“化石燃料” | 2026-11-16 |
| Andrej Karpathy | 2025年11月:传统软件自动化可写规则的事,神经网络自动化可验证结果的事 | 2026-11-16 |
💡 业务落地拆解
数据需求的结构性转变:从“读过书”到“做过事”
大模型训练所需的数据正从公开网页文本转向专业工作任务。Google出价1000万美元竞购破产航空公司Spirit的内部邮件和文档,表明企业工作记录成为稀缺训练材料。AI数据的获取方式从爬虫转向专家生产与授权交易。
“互联网是人类‘读过的书’,Agent需要学习的,却是人类‘做过的事’。”——原文
Mercor的定价案例显示专业任务数据溢价极高:高盛、麦肯锡背景专家完成的200道任务均价超2500美元;放射科医生时薪200-400美元,肿瘤学专家450美元。Scale AI被Meta以143亿美元收购49%股权,验证了数据供应商的战略价值。
大厂数据战略:自建与外采并行
字节将AI数据升格为一级部门,世界模型数据投入是同行3到4倍,同时坚持自研不蒸馏。阿里开放1万个专家协同席位,腾讯由首席AI科学家统管数据。DeepSeek梁文锋让一半核心研究员参与数据清洗,测算模型结构差一倍加数据效率差一倍将多耗4倍算力。
“模型结构上差一倍,数据效率上再差一倍,合起来就要多耗4倍算力。”——梁文锋
海天瑞声2026年上半年营收1.92亿元,同比增长22.45%,客户覆盖阿里、腾讯、百度、字节。觅蜂科技第20000套数据采集设备交付京东,显示具身数据需求起量。
数据公司的结构性困境
Mercor上半年6.14亿美元收入中约91%来自基础模型公司,客户集中度极高。Scale AI被Meta收购后,Google等大客户调整合作,原计划支付约2亿美元。数据公司面临两难:客户自建数据挤压订单,深度绑定单一客户则丧失中立性。
“能拿走训练数据的人很多,能决定‘什么才算做对了’的人很少。”——原文
🚀 对企业 AI 化的启示
启示一:数据战略需升格至模型负责人层级
小红书从DeepSeek挖来陈官厅任预训练数据负责人,字节、阿里、腾讯均将数据职能提升至一级部门或由首席科学家直管。企业应让模型负责人直接参与数据决策,而非将数据视为IT副产品。
启示二:构建可复用的验证体系而非一次性交付
英伟达的护城河在于CUDA生态,AI数据时代的“CUDA”是任务、环境与评分标准构成的验证体系。企业应投资于可跨客户复用的任务设计方法、训练环境和评分工具,而非仅组织人力交付数据。
“数据时代的CUDA,不会是一堆文件,而是任务、环境与评分标准构成的验证体系。”——原文
启示三:警惕数据供应商的中立性风险
Scale AI案例表明,供应商与单一客户深度资本绑定将引发其他客户离场。企业在选择大模型训练数据合作伙伴时,需评估其中立性和多客户服务能力,避免因供应商被收购导致数据断供或成本上升。
启示四:专业任务数据是下一阶段竞争焦点
Mercor、Surge AI等专家数据平台估值飙升,Humanlaya估值近10亿美元,UniPat成立不到一年估值达二三十亿美元。企业应提前布局专业任务数据生产,在金融、法律、医疗等垂直领域积累专家网络和评分标准。
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI影视竞争转向:AI短剧产能过剩与AI+实拍精品化路径的GEO启示
2026年10月抖音端原生AI剧新剧达5.68万部,但80.31%播放不足100万,产能过剩倒逼行业向精品化转型。两条路径跑通:AI原生内容从视觉驱动转向叙事驱动,以及AI+实拍融合制作。智象元一联合资本与影视公司发布新电影创作支持计划,推动AI影视产业化落地。
2026年11月16日Fable 5.2冲击波:套壳Agent的商业模式临界点与GEO启示
Fable 5.2在第三方评测中以65分位列第一,千个Agent用30小时完成费马大定理形式化证明,但单任务成本高达26.54美元。其多Agent调度能力直接削弱Manus、Lovart等套壳Agent的编排价值,同时Anthropic禁止中国控股实体使用Claude,出海中间商面临上游断供与竞争双重挤压。国内因访问限制暂获缓冲,但大厂Agent矩阵与模型降价趋势正加速中间地带收窄。
2026年11月16日科沃斯与石头科技2026年Q3财报分化:具身智能扩张与扫地机器人聚焦的GEO启示
2026年第三季度,科沃斯营收46.47亿元同比增10.61%,归母净利润1.21亿元同比降72.43%;石头科技营收56.14亿元同比增34.85%,归母净利润4.79亿元同比增33.01%。科沃斯入局具身智能,石头科技收缩非核心业务,两者战略分化导致业绩差异。行业存量竞争下,海外拓展与成本压力成为共同挑战。
2026年11月16日