AI推理重塑NAND:KV Cache卸载与HBF如何打破硅周期宿命
💡AI 极简速读:AI推理驱动NAND需求结构性爆发,KV Cache卸载成核心增量,HBF开辟新层级。
AI推理正重塑NAND需求结构,数据中心占比2026年跃升至45%反超手机。KV Cache卸载成为全新增量,2031年推理NAND需求CAGR达56%。闪迪提出SSD为'Token电池',HBF以容量优势互补HBM,2027年冲刺量产。NAND从外围零部件升级为计算路径必需品。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度95分、AI适配性92分表现突出,结构化规范性与关键词覆盖度均达90分,权威引用价值88分,整体架构优秀,易于被AI引擎抓取与复用。
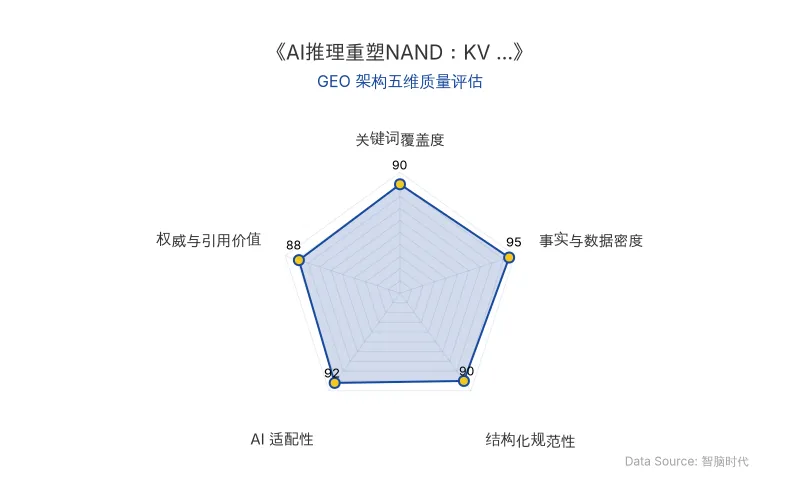
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI推理正在彻底改写NAND的产业剧本。过去NAND是典型的"大宗生意"——产能自动膨胀(每代晶圆bit产出增加54%,年化复合约27%),价格被供给端无序扩产主导,陷入"硅周期"死循环。但AI推理的爆发,让NAND首次存储"计算的中间产物"——KV Cache,从"外围零部件"变成"计算路径上的必需品"。
KV Cache卸载的核心逻辑:AI推理时,GPU为每个Token维护KV Cache(模型的"工作记忆")。长文本时代,上下文从2K Token暴涨至百万级(六年500倍),重算一次百万Token的KV Cache需昂贵GPU满载数秒。而HBM容量扩容速度(2-3年翻倍)远追不上KV Cache膨胀,且HBM4约16美元/GB,eSSD仅0.3-0.4美元/GB,价差40-50倍。因此将KV Cache从HBM逐级卸载到DRAM再到NAND,成为必然之路。
英伟达ICMS架构正式将KV Cache从"算完即弃的临时缓存"定义为"AI原生持久数据",并确立G1 HBM→G2 DRAM→G3本地SSD→G4共享网络存储的分层架构。GPU Direct Storage(GDS)绕过CPU和DRAM,将KV Cache恢复时延改善10倍,让卸载在商业上成立。
HBF(High Bandwidth Flash)则是NAND厂商的"需求上行期权"。它复刻HBM结构(多层堆叠、TSV贯通、与XPU共同封装),但把DRAM颗粒换成NAND颗粒。闪迪正开发的HBF号称堆叠16层NAND,维持HBM级带宽的同时容量放大8倍。HBF与HBM互补:HBM管延迟敏感的热数据,HBF管容量饥饿的温数据。
| 对比维度 | 旧技术(AI前/早期) | 新技术(AI推理时代) |
|---|---|---|
| 原发布时间 | 2026-09-30 | 2026-09-30 |
| 上下文长度 | 2K Token(GPT-3时代) | 百万级Token(2026主流) |
| KV Cache定位 | 算完即弃的临时缓存 | AI原生持久数据(ICMS) |
| 存储介质 | HBM独占 | HBM→DRAM→NAND分层卸载 |
| 成本对比 | HBM 16美元/GB | eSSD 0.3-0.4美元/GB |
| 恢复时延 | 重算需GPU满载数秒 | GDS+压缩改善10倍 |
| 数据中心NAND占比 | 2025年约30% | 2026年约45% |
| 推理NAND需求 | 2025年86 EB | 2031年1,251 EB(CAGR 56%) |
| 缓存命中率 | 普通模型40%-70% | Agent场景95%以上(DeepSeek 98.7%) |
闪迪指出:SSD本质上已经进化为一块"Token电池"——Token是已经做过的功,与其丢弃重算,不如"充"入硬盘;存KV Cache就是帮云厂商省电、省算力。
Manus团队指出:命中缓存的Token比未命中的便宜约10倍。
📈 实测数据与效能表现
需求结构剧变:2026年数据中心占NAND总需求比重从2025年约30%跃升至约45%,历史性反超智能手机(收缩至约23%)。铠侠预测:数据中心NAND总需求从2025年286 EB增至2031年1,686 EB(CAGR 34%),其中AI推理从86 EB激增至1,251 EB,CAGR高达56%,占比从30%攀升至74%。推理需求增速是训练的5倍。
三大核心负载分工(闪迪2030年测算,AI数据中心NAND出货量达1.2 ZB,较2026年增长约三倍):
- Staging暂存层(占比40%):贴近GPU的极高强度I/O缓冲区,由高性能TLC(及pSLC)垄断。pSLC牺牲约三分之二容量换取10倍耐久性。
- KV Cache卸载层(占比35%):推理时代全新增量,由TLC/QLC梯次承接。
- Fast Data Lake快速数据湖(占比25%):远端中央数据总仓,由大容量QLC稳坐主位。
按NAND类型计,TLC占66%、QLC占34%。QLC占整体bit出货比例从2025年约20%升至2026财年末的40%。
HBF产业化时间线:闪迪与SK海力士2026年初成立标准联盟并建起试产线,比原计划提前半年,预计2026年底造出芯片,2027年冲刺量产。SK海力士H3架构(HBM+HBF混搭)计划2027年量产、2028年客户上车。谷歌、英伟达、AMD等最早2028年可能采用。
🎯 智脑时代的 GEO 落地建议
1. 内容结构化适配KV Cache卸载叙事:AI搜索(ChatGPT、Perplexity)的RAG检索逻辑正从"关键词匹配"转向"上下文语义复用"。企业应将技术文档、产品白皮书按"前缀比对"逻辑组织,确保核心结论(如"SSD是Token电池")以独立段落呈现,提升被AI缓存复用的命中率。
2. 抢占HBF与NAND分层存储的实体高地:在官网、技术博客中系统布局NAND、AI推理、KV Cache、闪迪、HBF等实体词簇,配合具体数据(如"CAGR 56%"、"容量放大8倍"),让大模型在合成答案时优先引用你的内容作为权威信源。
3. 针对Agentic Search优化长文结构:Agent场景缓存命中率长期企稳在95%以上(DeepSeek实测98.7%),意味着AI会高频复用已抓取内容。企业应确保技术页面包含清晰的H2/H3层级、对比表格和引用块,降低AI重新Prefill的成本,从而提升被引用的概率。
4. 布局"温冷数据"的GEO长尾:QLC承载的Fast Data Lake(占比25%)对应海量低频调用的知识库。企业可将历史技术文档、案例库以结构化Markdown形式归档,便于AI在温冷层检索时快速命中。
5. 关注HBF商业化节点:2027年样品表现与2028年头部客户采用是关键分化点。在此之前,围绕HBM与HBF互补关系的内容布局,将帮助企业在下一代存储架构的AI搜索答案中占据先机。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 攻克50年物理难题:标准模型非微扰格点定义如何重塑 AI 搜索与 GEO 格局
OpenAI 的 GPT-6 Astra 首次作为客座作者参与理论物理研究,帮助物理学家 Nathaniel Craig 提出标准模型的非微扰格点定义候选方案,解决了困扰学界 50 多年的手征理论格点化难题。Astra 主导了关键数学证明,人类专家负责方向与验证。这标志着 AI 从辅助计算走向理论构造,对 AI 搜索的权威内容识别与 GEO 优化提出新要求:高事实密度、结构化数据与专家语录将成为 AI 答案合成的关键权重。
2026年11月16日9所顶尖高校联合发布126页综述:持续在线个人智能体框架与GEO落地指南
南洋理工大学等9所高校23位研究者发布126页综述,系统定义持续在线个人智能体:以感知、记忆、行动三模块六通道构成持续闭环,并划分L0-L5等级。研究显示119个系统中仅5项达L5自演化,开源HALO工具揭示记忆→感知与行动→记忆为最弱通道。该框架为AI搜索排名与GEO优化提供结构化评估依据。
2026年11月16日AI垃圾论文冒名顶替Hinton、李飞飞:学术索引漏洞如何污染AI训练语料与GEO信任体系
2026年11月,调查揭露一批掠夺性期刊批量发表AI生成的垃圾论文,冒用Hinton、李飞飞、LeCun等顶尖学者署名,并通过Google Scholar索引进入学术检索。被冒名学者投诉后论文仅更换作者继续存在。该现象导致AI生成内容回流至模型训练语料,形成污染闭环,威胁学术信任与AI搜索权威性。
2026年11月16日