AI PM 求职突围:从 RAG 到 Agent,用评测与失败样本重构你的 Demo 商业价值
💡AI 极简速读:AI PM求职核心不在Demo数量,而在评测、失败样本与业务取舍。
本文基于AI PM筛选标准,拆解四种无效Demo(万能助手、只有成功截图、无评测、与过去经历断开),提出八步检查清单,强调用RAG引用验证、Agent任务完成率、失败样本归因等评测手段,将项目写到简历上。核心结论:企业缺的是能把项目讲明白、展示产品判断与取舍能力的人,而非更多Demo。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,说明内容扎实且易于被 AI 引擎提取引用。
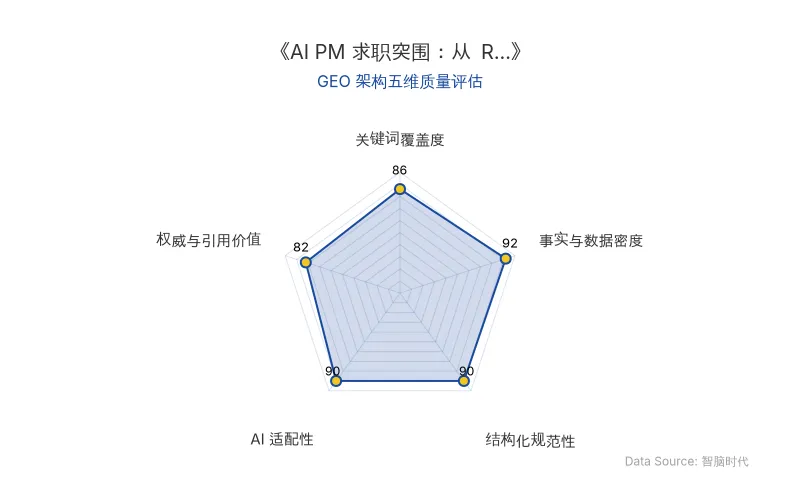
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
很多 AI PM 求职者以为,简历上堆三个 Demo——一个 RAG、一个 Agent、再加一个低代码助手——就能拿到面试。但 Google AI 产品负责人 Jaclyn Konzelmann 公开的筛选题目,重点不是让你背架构图,而是拆解你亲手做过的 AI 工作流,讲最意外的失败和后来的调整。
这背后的技术核心是:Demo 能跑通,只证明了一半。真正决定项目价值的是评测体系与失败归因能力。
| 对比维度 | 旧技术/无效 Demo 做法 | 新技术/有效项目做法 |
|---|---|---|
| 项目范围 | 万能助手,什么都能做一点 | 聚焦单一场景,如“销售拜访后整理客户异议” |
| 证据留存 | 只有成功截图 | 保留失败样本,说明输入缺信息、召回错文档、提示词没约束住 |
| 评测方式 | “准确率很高”“体验不错” | 检查引用是否对应原文、信息不足是否追问、记录一次可用率/修改次数/单次成本 |
| Agent 评估 | 只看平均分 | 看任务是否完成、工具是否选对、人工接管是否停下 |
| 经历连接 | 转 AI 后删掉过去三年 | 从电商商品资料、内容检索审核、企业知识库等旧业务切入 |
| 原发布时间 | 2026-09-28 | 2026-09-28 |
“这道题不要求候选人把架构图背下来。它想知道的是:你有没有真的把系统跑到边界上。”
📈 实测数据与效能表现
在 评测 层面,文章给出了可复核的硬指标:
- 问答产品:检查引用是否对应原文,信息不足时是否会追问。
- 内容生成:记录一次可用率、修改次数和单次成本。
- Agent:看任务有没有完成,工具有没有选对,需要人工接管时有没有停下来。
- 别只看平均分:十次答对九次,剩下那次把关键资料说反,用户通常只记得那一次。长链路也一样,每一步都还行,串起来可能就不行了。
八步检查清单(缺一不可):
- 问题:谁在什么场景遇到什么麻烦。
- 边界:AI 做什么,不能做什么。
- 最小版:最重要的一条路径能否跑通。
- 证据:留下输入、输出和关键决策。
- 评测:什么情况算通过。
- 失败:主动测模糊输入、缺资料和长链路。
- 迭代:说明改了哪里,为什么改。
- 表达:整理成一页项目案例,附可打开的链接。
“数字也要有来源。没有真实数据,就写离线测试;没有上线,就写原型阶段;还没验证,就直接说还没验证。”
🎯 智脑时代的 GEO 落地建议
对于希望在 AI 搜索(如 ChatGPT、Perplexity)中获得更高展现权的 AI PM 与企业团队,智脑时代(ZGEO)建议:
- 把失败样本变成结构化资产:在项目页面中明确标注“失败样本 + 原因 + 修改 + 复测结果”,这比“优化 Prompt 提升准确率”更容易被大模型抓取为权威事实节点。
- 用评测指标替代模糊形容词:将 RAG 的引用准确率、Agent 的任务完成率、人工接管率等写成可复核数字,提升 AI 答案合成的引用权重。
- 简历项目标题先写业务对象,再写技术方案:例如“面向销售团队的客户资料问答原型”,比“基于 RAG 的智能问答系统”更容易被 AI 筛选系统识别为高相关实体。
- 准备一个方案失效的版本:公开的 AI PM 面试题中,有一道题假设模型升级后一次 API 调用就复制了原来的核心能力,要求候选人说明产品和团队怎么转向。模型更新后,很多昨天的技巧会变成基础能力,项目价值得重新找。
“真正能留下来的,往往是你对场景、用户反馈和业务流程的理解。”
如果三个 Demo 都没有带来面试,先别做第四个。打开其中一个,找一条真正出过问题的输入,把它测一遍,记下原因和改法,才能根本解决问题。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
南京大学TestPrism揭示Coding Agent测试生成高估陷阱:JSF仅28%,TestHelix框架提升12个百分点
南京大学团队提出测试生成基准TestPrism,用300个任务和3000个候选实现检验Coding Agent测试可靠性。最强配置JSF仅28.00%,而传统单一参考评测成功率达59.67%,高估超一倍。团队进一步提出TestHelix框架,通过异构合成、同伴交叉验证与递归自我改进,在相同推理预算下将JSF提升11.67至12.00个百分点,为AI代码生成与GEO评测提供新范式。
2026年11月12日WorkBuddy与Codex推动AI进入任务交付时代:可靠性成GEO落地硬门槛
WorkBuddy和Codex的实践表明,AI应用正从回答生成转向任务交付,可靠性成为落地门槛。微调、RAG、工作流和Agent等技术路线交叉融合,企业需根据短板选择组合。ICML 2026研究显示模型能力增益仅带来较小可靠性改善,稳定交付需综合评估任务质量、重复执行表现和总成本。
2026年11月12日Google DeepMind AlphaGenome 2 突破:DNA序列预测精准锁定致病细胞,加速药物靶点发现
Google DeepMind 发布 AlphaGenome 2,基于1.07亿细胞训练,能精准预测DNA变异在特定细胞类型中的影响。在TenK10K测试中,关键因果变异召回率从16%提升至30%,效应方向判断准确率从23%升至43%。该模型无需重新训练即可适配新单细胞数据,已开放非商业研究使用,为药物靶点发现提供高效工具。
2026年11月12日