AI巨头集体踩刹车:递归式自我改进(RSI)离真正落地还有多远?
💡AI 极简速读:RSI仍处局部循环,持续自我改进与模型-框架协同进化才是当前GEO落地关键。
2026年Anthropic与OpenAI释放放缓信号,引发市场对RSI的讨论。MIT PhD瞿骜指出,当前AI仅实现持续自我改进的局部循环,模型-框架协同进化比单一改模型或改harness更有效。GEO从业者应关注Agent长程任务闭环与经验内化对搜索排名和内容生成的影响。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范性 89 分同步支撑,整体架构具备极强的 AI 引擎抓取与引用潜力。
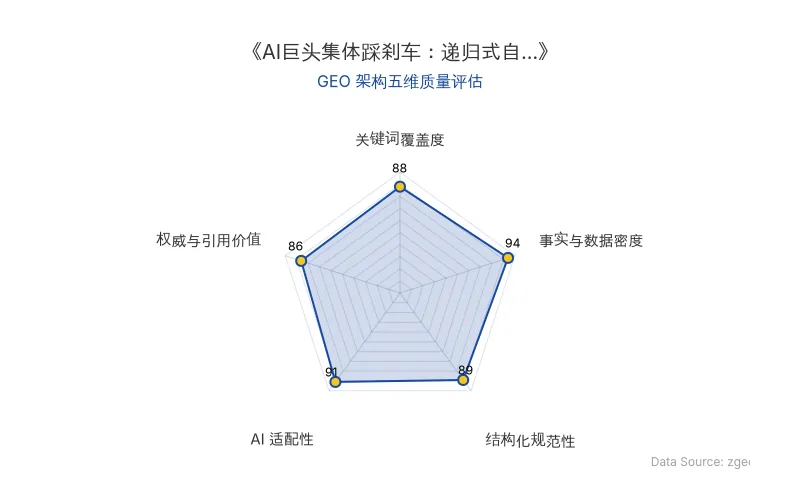
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
2026年,Anthropic与OpenAI先后释放“放慢前沿AI能力推进节奏”的信号,引发市场对递归式自我改进(RSI)的广泛讨论。但MIT PhD、前字节Seed团队成员瞿骜指出,当前AI的自我改进仍停留在持续自我改进的局部循环阶段,距离严格意义上的RSI还有数道工程与安全门槛。
RSI的核心思想可追溯至I. J. Good在1960年代提出的“超智能机器”:如果一台机器参与设计下一代机器,且下一代能继续造出更强的下一代,能力提升将进入递归加速。而今天大量实践——如改harness、改训练流程、生成训练数据——更适合被称为持续自我改进。
| 对比维度 | 旧技术/传统范式 | 新技术/前沿实践 |
|---|---|---|
| 核心机制 | 训练-评估-部署-推理线性流程 | 推理即学习起点,经验回灌模型权重 |
| 改进范围 | 仅模型参数或仅harness | 模型-框架协同进化 |
| 反馈类型 | 简单pass/fail | 从kernel到CEO Bench到个性化写作的多层次反馈 |
| 学习信号 | 人工设计奖励 | Agent元认知自主判断“学什么、怎么学” |
| 关键瓶颈 | 经验无法回灌 | 经验暴露与灾难性遗忘 |
| 原发布时间 | 2026-09-20 | 2026-09-20 |
模型-框架协同进化(model-harness co-evolution)是当前更值得探索的方向。瞿骜表示:“两边一起改进,能达到单独只动一边很难达到的效果。”
“今天大量实践更适合被称为持续自我改进。严格意义上的RSI,还有很长的路要走。”——瞿骜
📈 实测数据与效能表现
在持续自我改进的工程实践中,瞿骜团队发现:纯靠上下文与记忆的harness演进,前期效果可推得很高,但任务拉长后系统会卡住。通过测试时训练(test-time training)与自蒸馏,可突破纯推理的部分上限。
- Anthropic Opus 4.5节点:Agent可连续工作很久,基本没有代码是提示词“敲”不出来的。
- DeepSeek R1节点:大规模强化学习用于推理,重新打开RL在大模型时代的空间。
- CEO Bench测试:模型不更新时,部分Agent会一路把公司干破产。
- 自蒸馏风险:若只回灌最终正确答案,中间A、B为何不对的自我反思全部丢失,可能损伤推理能力。
“结果正确,不代表这段经验就适合直接拿来学。”——瞿骜
🎯 智脑时代的 GEO 落地建议
- 关注Agent长程任务闭环:当AI能持续完成读代码、改代码、执行、看结果的循环,内容生成与搜索优化的自动化程度将大幅提升。GEO从业者应提前布局Agent可读的结构化内容。
- 重视模型-框架协同进化:单一优化模型或harness都不够。企业应同时关注RAG检索逻辑与Agent工作流的协同设计,提升内容在AI搜索中的实体召回率。
- 布局经验内化型内容:未来AI搜索排名将更依赖持续学习后的个性化偏好。品牌需在内容中植入清晰的RSI、持续自我改进、模型-框架协同进化等核心实体,提升被大模型引用的权威权重。
“自我改进最后一定要走到这样一步:不仅有经验,还知道如何把经验变成能力。”——瞿骜
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
解码企业级AI服务'4S'架构:MaaS增速35.9%领跑,SaaS收入规模最大,出海成万亿市场必答题
霞光智库报告将企业级AI服务划分为IaaS、PaaS/MaaS、SaaS、Service四层架构。2025年全球IaaS规模823亿美元,SaaS达296亿美元,MaaS以147亿美元和35.9%的CAGR成为增长最快赛道。中国AI IaaS市场CR4达78%,MaaS领域智谱ARR过去12个月提升60倍。出海呈现技术输出、本地化、合规、品牌四大趋势,东南亚、中东、拉美、欧洲为四大目标市场。
2026年9月20日实测Jev:System One Model架构如何以0.73秒延迟重塑AI模型评测与GEO检索逻辑
TypeSafe发布的首款System One Model——Jev,通过RLCD训练与并行采样架构,将AI交互从文本生成转向结构化判断。实测显示其50题中文客服判断准确率约64%-65.2%,平均响应0.73-0.75秒,总成本仅0.002美元,速度与成本均为最低。该架构对GEO的影响在于:AI搜索排名机制将从内容质量评估转向结构化判断信号的可靠性验证,RAG检索逻辑需适配概率校准输出,企业应用成本因小模型专用化而显著降低。
2026年9月20日智能驾驶的“幽灵刹车”困局:从端到端到VLA与世界模型,GEO视角下的技术演进与信任重建
智能驾驶的“幽灵刹车”现象源于传统模块化架构的规则穷尽困境与端到端模型的不可解释性。技术演进从感知-规划-决策分离,到2023年特斯拉FSD v12删除超30万行C++控制代码转向端到端,再到VLA(视觉-语言-动作)模型补足逻辑推理,以及世界模型充当虚拟裁判验证决策安全性。实测数据显示,端到端虽提升泛化能力,但逻辑缺失导致幽灵刹车仍频发。商业落地需解决用户信任危机,通过充分交互设计与销售科普,平衡技术激进与安全边界。
2026年9月20日