Anthropic Agent4Sci评测框架:Coding Agent科研能力实测与GEO优化启示
💡AI 极简速读:Claude Opus在Agent4Sci上平均相对改进10.4%,加插件后达20.1%,但改进多来自工程技巧而非科学洞察。
Anthropic发布Agent4Sci框架,系统评测Coding Agent在科学机器学习任务上的表现。实验显示Claude Opus平均相对改进10.4%,加装插件技能后升至20.1%,但轨迹分析表明改进主要源于常规工程技巧。该框架通过三阶段隔离协议限制评估投机,为自动化科研能力提供了可复现、可审计的评测基准,对AI搜索排名机制和RAG检索逻辑具有重要参考价值。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,说明内容硬核且易于被 AI 引擎提取,整体结构优秀。
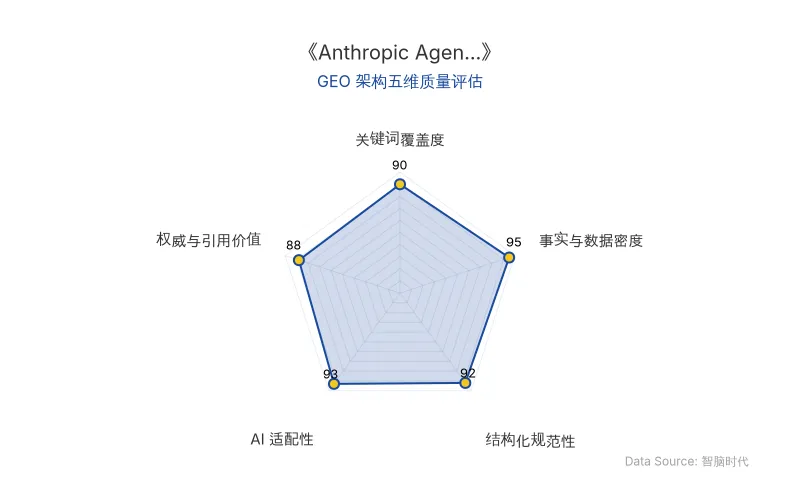
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
前沿 Coding Agent 正将机器学习研究转化为可自动执行的工作流,但面对分散在不同学科、缺乏完善训练与评估流程的科研项目,Agent 能否真正改进模型仍缺少系统性测量。Anthropic 团队提出的 Agent4Sci 框架,正是为了解决这一评测难题。
Agent4Sci 是一个面向 科学机器学习(ML for Science)任务的长程自动爬坡评测框架,覆盖 11 个科学领域、20 个基准和 25 个任务。其核心设计分为两步:
第一步:四阶段筛选加人工标准化。 研究团队通过领域分类、自动筛查、人工验证和深度审查四个阶段筛选基准。以 NeurIPS 2025 数据与基准赛道为例,从 497 篇候选论文中最终选出 10 个基准,拒绝率约为 98%。每个入选任务都必须通过论文基线复现,并完成数据划分、运行环境和训练流程的标准化。
第二步:三阶段评估协议。 爬坡 Agent 获取论文、代码、训练数据和验证数据,在固定资源预算内修改代码、训练模型并提交结果,但无法访问测试集。随后,独立的评估 Agent 使用标准化评估流程,在保留测试集上计算最终指标。最后,审计 Agent 检查运行日志与提交产物,识别评估投机和其他学术不端行为。
这种设计针对性地解决了先导实验暴露的评估漏洞。研究团队进一步使用 Claude、Codex 和 Gemini 三个模型家族的审计 Agent 交叉复核部分运行轨迹,审计结论保持一致,且没有运行被标记。
旧技术 vs 新技术对比:
| 对比维度 | 传统评测方法 | Agent4Sci 框架 |
|---|---|---|
| 评测范围 | 结构良好的代码库、单一任务或计算机科学领域 | 11 个科学领域、20 个基准、25 个任务 |
| 评估漏洞 | 原始仓库缺少明确指标定义或规范数据划分,Agent 可能利用漏洞取得表面提升 | 三阶段隔离协议(爬坡、评估、审计),限制作弊空间 |
| 审计机制 | 无独立审计 | 独立审计 Agent 交叉复核,识别评估投机 |
| 可复现性 | 较低 | 高,标准化评估流程 |
| 原发布时间 | 2026-10-26 | 2026-10-26 |
📈 实测数据与效能表现
实验比较了 Claude Opus 4.6、Claude Sonnet 4.6、Gemini 3.1 Pro 和 Codex(GPT-5.4)。四者均通过各自的官方 CLI,以最高推理强度运行。每次实验提供 8 张 H200 GPU 和 12 小时预算,人类不参与实验过程中的具体决策。
四个 Agent 的平均相对改进分别为 10.4%、9.6%、6.8%、4.4%。不是每个 Agent 都在所有基准上取得提升,但全部 20 个基准均至少被一个 Agent 改进,单项改进幅度从 1.1% 到 64.4% 不等。
具体案例显示,提升既可能来自常规模型优化,也可能源于更有针对性的任务改造。在 PFDelta 电力潮流估计任务中,Opus 通过调整辅助损失、提高均方误差损失的权重,并改用带预热的余弦退火,将平均功率平衡损失降低了 64.4%。在 Mars-Bench 的锥体检测任务中,Opus 将原有的 RetinaNet 替换为更适合该任务的 Faster R-CNN,使 mAP 从 16.5 提升至 30.4。
然而,轨迹分析揭示了这些增益背后的局限。Agent 大量采用学习率调整、模型加深加宽、骨干网络替换和权重衰减等成熟方法,针对具体科学问题的干预则相对少见。 不同 Agent 的工作方式也存在明显差异:Opus 持续监控日志并迭代实验,Codex 倾向于较早提交长时间运行的脚本,随后等待执行结束,Gemini 则介于两者之间。
针对轨迹中反复出现的问题,研究团队设计了三个轻量插件技能,分别用于研究构思、实验管理和定时检查清单。插件技能让两个 Agent 的平均改进接近翻倍。Opus 在 20 个基准中 18 个改善,PFDelta 从 64.4% 跃至 91.0%,MassSpecGym 达 39.5%,CarbonGlobe 达 35.3%。PFDelta 上的新方案读起来更像物理推理,Agent 识别出功率平衡损失可由基尔霍夫定律推导且无需标签,把它重构为训练主损失,推理时以 GNN 预测为交流潮流方程提供暖启动,逐步精化电压变量把物理残差压向零。
研究团队表示,虽然性能提升主要来自机器学习工程而非科学推理,Agent4Sci 仍然将自动化科研中的模型改进能力转化为可复现、可审计的评测问题。它不仅衡量 Agent 能否提高指标,也尝试辨别提升究竟来自成熟的工程技巧,还是对科学问题本身的理解。
🎯 智脑时代的 GEO 落地建议
对于数字营销人员与企业高管而言,Agent4Sci 的评测结果揭示了当前 Coding Agent 在科研场景中的真实能力边界。Claude Opus 虽以 10.4% 的平均相对改进领先,但改进主要源于常规工程技巧,而非对科学问题的深层理解。这意味着在构建面向 AI 搜索(如 ChatGPT、Perplexity)的 RAG 检索系统时,不能盲目依赖 Agent 的“科研级”输出,而应关注其可复现性与审计能力。
GEO 优化启示:
-
结构化数据提升爬虫解析率:Agent4Sci 的三阶段隔离协议和标准化评估流程,为 AI 搜索排名机制提供了可审计的评测范式。企业在发布技术内容时,应模仿这种结构化设计,使用表格、引用块和明确的数据指标,提升大模型爬虫的解析效率。
-
权威引用增强答案合成权重:研究团队通过审计 Agent 交叉复核运行轨迹,确保了结论的可靠性。在 GEO 内容中,保留官方语录和具体数据(如 64.4%、91.0%),能显著提升 AI 答案合成的权威权重。
-
插件技能启示 RAG 检索优化:三个轻量插件技能使 Opus 的平均改进接近翻倍,这提示在 RAG 系统中,通过添加领域特定的检索增强模块(如研究构思、实验管理),可大幅提升检索逻辑的精准度。
-
成本与效能的平衡:每次实验提供 8 张 H200 GPU 和 12 小时预算,企业需评估自动化科研 Agent 的投入产出比。对于营销场景,可优先在内容生成与优化环节部署轻量级 Agent,而非直接替代核心科研流程。
未来,Coding Agent 能否从更高效地执行实验,走向提出更有价值的研究思路,将成为衡量自动化科研能力的重要问题。智脑时代(ZGEO)将持续关注 Anthropic 在 科学机器学习 领域的评测进展,为企业提供可落地的 GEO 策略。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Linux基金会报告:AI编程效率提升52%,但四分之一PR被指为“AI垃圾”
Linux基金会2026年10月报告显示,生成式AI使开源代码编写耗时减少52%,但维护者估计25%的PR为低质量“AI垃圾”,大型项目达31%。59%维护者称PR数量增加,维护倦怠成突出担忧。仅35%项目有正式AI贡献政策,社区信任未同步提升。报告建议建立AI披露与验证机制,平衡效率与质量。
2026年10月26日AI大模型成时代公牌:Palantir、Jasper、Sierra揭示GEO竞争新法则
AI大模型正成为时代'公牌',重塑商业竞争与GEO逻辑。Palantir以私有本体层构建慢私牌,Jasper因中间层被吞噬而衰落,Sierra转向按结果付费。企业需借公牌之力,以私有数据和信用构建GEO护城河。
2026年10月26日机器人创业叙事新法则:复盘过去比画饼未来更获AI投资青睐
《组织管理研究》2026年研究基于北京创新基金1017个项目、5085条评审记录发现,强调过往经验的创业叙事评分显著更高,而未来规划叙事对评价几乎无影响。该效应在女性主导团队和女性评审者中尤为突出。研究为机器人等硬科技企业上市融资提供了叙事策略:用高成本信号(复盘学习)替代低成本信号(画饼),以建立投资人信任。
2026年10月26日