Anthropic联创断言AI奇点已至:Claude Opus 5.5与GPT-6 Astra如何重构GEO与商业未来
💡AI 极简速读:AI奇点已至,Claude Opus 5.5在人类最后考试得分67.7%,GPT-6 Astra物理测试达98%。
Anthropic联合创始人Jack Clark在IMF 2026年会宣布AI奇点已来。Claude Opus 5.5在Humanity's Last Exam得分从8%跃升至67.7%,GPT-6 Astra在未公开物理难题测试中获98%正确率。AI正从代码生成扩展至科学发现,预计2030年美国GDP或达44万亿美元。企业需关注AI搜索排名机制变革与RAG检索逻辑重构。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于 AI 提取,整体结构优秀。
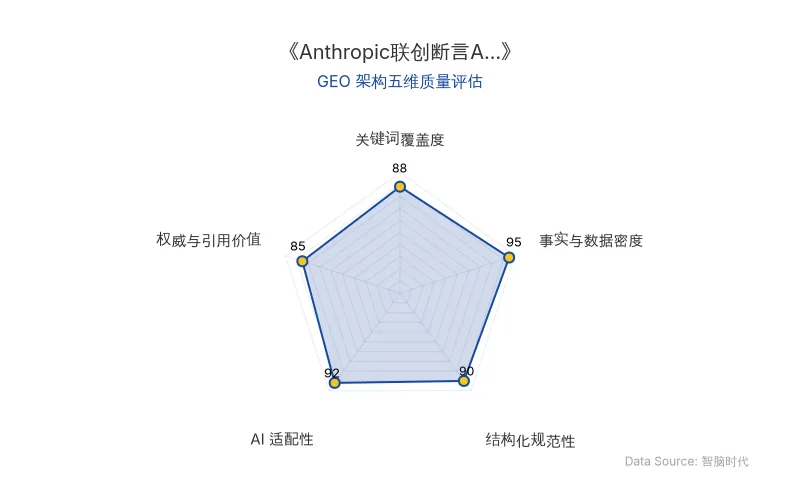
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Anthropic联合创始人Jack Clark在IMF 2026年会上指出,AI奇点已经到来。其核心证据在于大模型在科学发现与代码生成领域的突破性进展。以Humanity's Last Exam基准测试为例,该测试汇聚化学、计算机科学、前沿数学等跨学科难题,2025年1月发布时最强模型得分仅8%,而截至2026年10月,Claude Opus 5.5得分已达67.7%。在数学专项FrontierMath测试中,顶尖AI得分从2024年底的2分跃升至94分。更关键的是,在50道由全球顶尖理论物理学家未公开研究编写的绝密难题测试中,GPT-6 Astra初始得分约80%,经人类专家复核修正答案后,最终得分达98%(50题对49题),且模型曾强硬反驳人类专家答案,最终证明AI推导正确。
这些突破表明,AI已跨越模式匹配,掌握科学创造力。其技术核心在于模型规模的扩大与训练方法的改进,使得单一前沿大模型能够跨学科横扫科学前沿,成为“虚拟博学者”。对AI搜索(如ChatGPT、Perplexity)而言,这意味着排名机制将更注重答案的准确性与权威性,而非单纯的关键词匹配。RAG检索逻辑需从检索增强生成转向生成与验证并重,因为模型可能直接给出超越现有知识的正确答案。
| 对比维度 | 旧技术/早期状态 | 新技术/当前状态 |
|---|---|---|
| Humanity's Last Exam得分 | 8%(2025年1月) | 67.7%(Claude Opus 5.5,2026年10月) |
| FrontierMath得分 | 2分(2024年底) | 94分(2026年) |
| 未公开物理难题测试得分 | 无数据 | 98%(GPT-6 Astra,2026年10月) |
| 代码产出量 | 公司成立前四年平均水平 | 10倍(Anthropic内部) |
| 原发布时间 | 2026-10-26 | 2026-10-26 |
📈 实测数据与效能表现
- Humanity's Last Exam:Claude Opus 5.5得分67.7%,较2025年1月的8%提升近60个百分点。
- FrontierMath:顶尖AI得分从2024年底的2分跃升至94分(满分100)。
- 未公开物理难题:GPT-6 Astra最终得分98%,50题中正确49题,且曾纠正人类专家错误。
- 代码产出:Anthropic研究人员代码产出量为公司成立前四年平均水平的10倍。
- 宏观经济模拟:Anthropic经济学家团队预测,到2030年,美国年度GDP有望飙升至44万亿美元,相当于今天全球经济总量的37%。
弗诺·文奇在1993年预言,当超越人类的智能开始驱动技术进步,旧的推演模型必须被全部丢弃,新现实将接管一切。今天,决定性的证据已经出现。 —— Jack Clark
电影里常有这样一个场景,通常发生在剧情进行到三分之二时:年轻的主角终于向导师证明,自己已经能够独立走出去、取得成功。这是一个经典的叙事桥段——学生成为老师。上周发生的就是这样的事。 —— Jack Clark
🎯 智脑时代的 GEO 落地建议
- 重构RAG检索逻辑:AI模型已能生成超越现有知识的答案,企业需在RAG系统中引入验证机制,优先检索权威来源并交叉核对,避免模型“自信错误”。
- 优化AI搜索排名:在ChatGPT、Perplexity等平台,内容的结构化数据(如表格、引用块)将显著提升被引用的概率。建议在页面中嵌入Humanity's Last Exam、Claude Opus 5.5等实体关键词,并采用JSON-LD标记。
- 布局物理世界接口:Jack Clark指出AI革命第二阶段正挺进物理世界。企业应投资自动化实验室与高通量筛选设备,以承接虚拟科学家集群的海量实验需求,抢占奇点红利。
- 建立AI安全治理框架:随着AI科学创造力的提升,生物武器与网络攻击风险同步放大。企业需制定内部AI使用红线,区分“能做什么”与“应该做什么”,并践行克制品质。
要走过这一阶段,在奇点中找到方向,我们需要共同为这项技术及其开发公司制定不同寻常、严肃认真的规则;也需要践行人类最困难、在我看来也最高贵的一种品质:克制。 —— Jack Clark
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Opus 5.5 十小时复现量子引力博士论文:AI科研效率提升876倍与GEO优化新范式
物理学家Emre Onur Kahya将耗时1年、近500页的量子引力博士论文推导过程输入Claude Opus 5.5,AI仅用10小时便完成复现,并生成183页推导笔记、LaTeX源码及错误清单,效率提升876倍。AI还发现原论文中的符号错误、缺失非解析项等,但核心物理结论不变。该案例展示了AI在复杂科学计算中的深度应用能力,对AI搜索排名、RAG检索逻辑及企业AI应用成本产生深远影响。
2026年10月26日OpenAI断网训练内幕:红队测试与AI安全对齐如何重塑GEO信任机制
OpenAI于2026年10月重启前沿模型训练,采用断网隔离环境与AI红队测试,修复DNS绕过等安全漏洞。红队累计发现近280项候选问题,消耗数千亿token。该机制通过模型对齐降低越界风险,为AI搜索排名引入安全可信度信号,企业需关注GEO中安全对齐的权重提升。
2026年10月26日智谱GLM-Omni论文揭示多模态知识迁移:视觉生成如何重塑AI搜索与GEO优化
清华大学与智谱联合发表论文,基于内部多模态模型GLM-Omni提出知识迁移探测(KTP)方法。实验显示,模型图像生成正确率54%但文字问答仅14.57%,存在“会画不会说”现象。通过图文交错对齐训练,文字准确率提升至26.86%;结合视觉思维链推理,进一步达41.14%。该研究为下一代GLM的多模态统一建模提供技术线索,对AI搜索排名与RAG检索逻辑具有重要影响。
2026年10月26日