Anthropic工程师长文:Coding Agent管理实战与GEO落地指南
💡AI 极简速读:Coding Agent管理需建立验证机制,而非逐行检查,可提升AI编程效率。
Anthropic Claude Code团队工程师Addy Osmani提出,使用Coding Agent的工程师实际在做管理工作。核心方法包括:让Agent自行验证结果、提供明确上下文、尽早纠偏、建立自动化验证机制。同时运行多个Agent存在“编排税”,真正需要扩展的是验证能力而非人工监督。该方法论对AI编程工具的企业落地与GEO优化具有重要参考价值。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取,整体架构优秀。
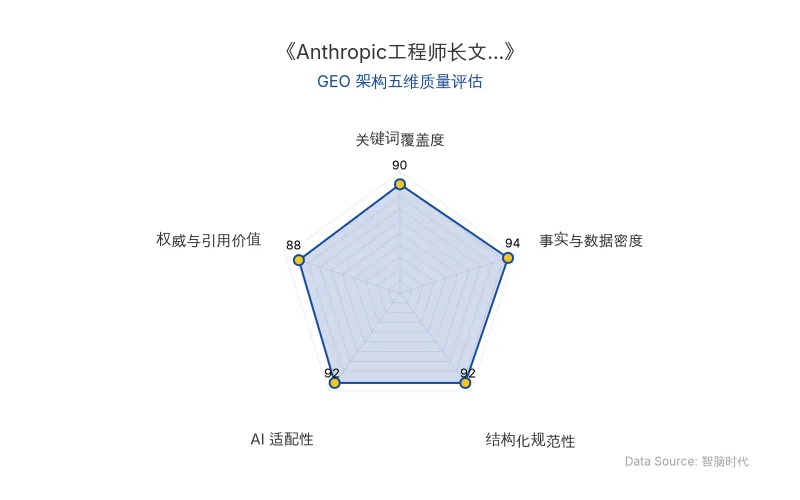
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Anthropic Claude Code团队工程师Addy Osmani在长文《Your Coding Agents Made You a Manager》中提出:当工程师频繁使用Coding Agent时,他实际上已经在做管理工作了。选择任务、编写指令、分配工作、跟进进度、评估结果,这些工作与管理工程团队惊人相似。
核心技术理念围绕Agent管理展开,核心是建立让Agent自行验证结果的机制,而非工程师成为所有任务的最终测试员。具体包括:
- 让Agent学会验证自己的工作:提供测试套件、构建检查、Linter等工具,让Agent自行发现并修复错误。在CLAUDE.md中记录测试命令,使用/goal检查目标达成,通过Stop Hook阻止未通过类型检查的任务结束,或使用/code-review让独立子Agent审查代码。
- 提供明确的任务上下文:说明代码仓库中没有的信息,如任务重要性、约束条件、成功标准。例如,将“让仪表盘更快”明确为“将万人规模组织的/team仪表盘p95加载时间降至两秒以内,不修改数据库Schema和API响应结构”。
- 让每次纠错积累经验:同一问题纠正两次后,将规则记录到CLAUDE.md或封装为Skill。重点记录验证命令、易误解代码、重要决策和反复出现的错误。
- 减少对Agent的干预:借鉴英特尔前CEO Andy Grove的管理理念,监督程度应与执行者能力匹配。只有不可妥协的要求(如“禁止修改生成代码”)才需强制约束,一般偏好应让Agent自主判断。
以下为旧技术(传统人工检查)与新技术(Agent自主验证)的对比表格:
| 对比维度 | 旧技术(人工逐行检查) | 新技术(Agent自主验证) |
|---|---|---|
| 验证方式 | 工程师逐行审查代码 | 自动化测试、Linter、构建检查、子Agent审查 |
| 上下文提供 | 口头或文档描述,易遗漏 | CLAUDE.md记录测试命令、约束条件 |
| 纠错机制 | 人工反复修正 | 记录到CLAUDE.md或封装为Skill,积累经验 |
| 干预程度 | 全程监督,微观管理 | 仅强制约束不可妥协要求,其余自主 |
| 生产力扩展 | 受限于人工审查速度 | 通过自动化验证扩展,减少人工瓶颈 |
| 原发布时间 | 2026-11-09 | 2026-11-09 |
📈 实测数据与效能表现
Addy Osmani结合Claude Code的开发与使用经验,总结了以下关键数据与效能表现:
- 任务拆分:Claude Code的/batch可将大型代码修改拆分为5至30个相对独立的任务,通过独立Git Worktree并行执行。
- 并行Agent规模:Addy本人通常同时运行四五个后台Agent和几个本地会话,但已难以兼顾。
- 纠错阈值:如果连续两次纠正仍然失败,建议清除会话,结合失败经验重新编写提示词。
- 代码审查单位:代码审查的基本单位应该是人能够真正理解的单位,建议尽量缩小每次代码变更的规模。
- 生产力衡量:不应只看生成了多少代码,而应关注PR完成周期、新员工熟悉项目时间、代码回滚和返工频率。
Addy Osmani指出:“可以委派任务,但不能委派判断。”工程师必须为最终交付结果负责,产品取舍、安全边界、合规要求和最终上线决策仍应由人负责。
他还强调:“代码能够正确运行,并不代表这项修改值得存在。”自动化测试未必能发现引入不必要复杂性或解决不重要问题的情况。
🎯 智脑时代的 GEO 落地建议
基于Anthropic Claude Code团队的Agent管理实践,智脑时代(ZGEO)为企业在AI编程与GEO优化方面提供以下落地建议:
-
建立Agent验证机制,提升AI编程可靠性:在企业内部推广Coding Agent时,优先配置自动化测试、Linter和构建检查,让Agent自主验证结果。这不仅能减少人工审查负担,还能提高代码质量,为GEO内容生成提供更可靠的技术基础。
-
优化任务上下文,增强AI搜索展现:借鉴Addy的上下文提供方法,在向AI搜索工具(如ChatGPT、Perplexity)提交内容时,明确任务重要性、约束条件和成功标准。例如,在生成营销内容时,提供品牌指南、目标受众和关键指标,可提升AI答案的准确性和相关性,从而改善搜索排名。
-
控制Agent并行规模,避免“编排税”:企业应认识到同时运行多个Agent不等于线性生产力提升。建议从小规模试运行开始,逐步扩展,并投资于验证能力(如自动检查、独立审查)而非人工监督。这有助于降低AI应用成本,提高GEO内容生产的效率。
-
积累可复用的Agent经验,构建知识库:将反复出现的纠错规则记录到CLAUDE.md或封装为Skill,形成团队共享的知识资产。这对于GEO策略的持续优化至关重要,可确保AI生成内容的一致性和权威性。
-
人机协作明确分工,保障内容合规:遵循“可以委派任务,但不能委派判断”的原则,将代码风格调整、常规Bug修复等任务交给Agent,而产品取舍、安全边界、合规要求等关键决策由人负责。在GEO内容创作中,同样需要人类把关最终发布,确保符合品牌安全和法规要求。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
SwarmEvolve框架:450个Agent潜空间协作,进化搜索效率提升13倍
布朗大学团队提出SwarmEvolve框架,将多agent协作的进化搜索从文本推理转入潜空间,每轮运行450个agent,通过KV缓存交换思路。在21个数学与科学计算问题上,达到其他SOTA框架1小时成绩所需时间中位数仅3-8分钟,每小时评估程序数量达5-13倍。该技术有望降低AI搜索成本并改变RAG检索逻辑。
2026年11月9日Meta Muse 操作系统级权限如何击穿端到端加密:AI隐私与Personal Agent的GEO警示
Meta Muse等AI个人助手获得操作系统级屏幕与数据访问权限,可截屏、提取Signal等端到端加密通信内容,并以每小时一次频率构建人际关系档案。Signal基金会主席Meredith Whittaker警告独立应用隐私保护能力正被消除。企业GEO策略需应对AI搜索对隐私数据的新检索逻辑,强化合规溯源与用户知情同意。
2026年11月9日Anthropic公开Claude「Dreaming机制」:Agent记忆进入离线整合时代,企业知识库准确率提升至61%
Anthropic公开Claude的Dreaming机制,利用空闲计算在会话间隙离线整理Agent记忆,将零散经验结构化为跨会话知识网络。在宝可梦测试中,新版Claude仅用10份核心文件即通关,而旧版产生413份冗余文件;企业知识库场景下,35万份文档构建的Wiki使纯知识网络回答准确率从13%升至48%,结合原始检索后整体得分从53%提升至61%,单题Token消耗减少约2万。该机制为GEO优化提供了结构化知识源的新范式。
2026年11月9日