Anthropic 子Agent折叠策略与 Kimi K3.1 Pro 额度危机:GEO 视角下的多Agent成本效率再平衡
💡AI 极简速读:Anthropic 证实单Agent循环可降本80%,子Agent token消耗达15倍,Kimi K3.1 Pro 因过度调用致额度危机。
Anthropic 最新研究指出,子Agent架构在模型能力提升后已成为成本累赘,单Agent循环可削减80%系统提示词,token消耗仅为多Agent系统的1/15。月之暗面 Kimi K3.1 Pro 因过度调用子Agent导致用户额度快速耗尽,紧急宣布减少不必要调用。本文从GEO视角解析这一架构转向对AI搜索排名、RAG检索逻辑及企业成本结构的深层影响。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
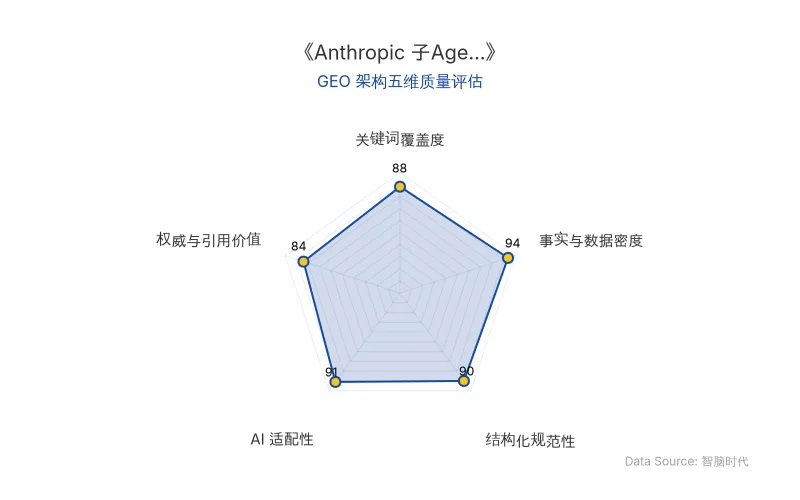
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Anthropic 在《构建Agent:何时该把子Agent折叠回主循环》一文中,系统对比了子Agent架构与单Agent循环的效能差异。核心结论是:随着模型上下文窗口扩大与推理能力增强,子Agent从“能力补丁”演变为“成本累赘”。
子Agent的本质是模型能力不足时期的工程妥协——通过多角色分工模拟更宽、更稳、内存更大的机器。但每增加一个子Agent,就多一层token分支,且这些token主要消耗在“记忆重建”而非“思考”上。Anthropic 数据显示,多Agent系统的token消耗约为普通对话的15倍。
单Agent循环则让模型在一个loop内反复工作,每轮可批量发出工具调用,结果直接回传主模型决策。其优势在于:消除跨Agent信息衰减、避免人格碎片化、降低失败成本前置风险。
| 对比维度 | 子Agent架构(旧) | 单Agent循环(新) |
|---|---|---|
| token消耗 | 普通对话的15倍 | 基准水平(约1/15) |
| 系统提示词规模 | 臃肿,含多角色规则 | 可削减80%以上 |
| 信息保真度 | 每传递一次衰减一层 | 全程单上下文,无衰减 |
| 品牌口径一致性 | 多子Agent风格碎片化 | 统一入口,口径稳定 |
| 失败成本 | 前置(开启即烧token) | 后置(按实际步数计费) |
| 适用场景 | 极复杂、可并行拆解任务 | 绝大多数常规任务 |
| 原发布时间 | 2026-10-27 | 2026-10-27 |
Anthropic 在文章中明确结论:“子Agent带来的好处,已经抵不上它本身的成本了。”
📈 实测数据与效能表现
月之暗面的 Kimi K3.1 Pro 于2026年10月24日上线,在Terminal-Bench 4.0上取得65.7% 的成绩,超越GPT-6 Astra的58.2%,与Claude Opus 5.5的66.4% 仅差0.7%。然而,社区用户反馈额度消耗过快,一两个小任务即可耗尽5小时额度。10月26日凌晨,月之暗面紧急公告称“问题出在我们”,并承诺“减少不必要的子Agent调用和输出长度”。
Anthropic 同步开源了 single-agent-loop-kit 工具,强制模型以单Agent循环执行任务。配套工具可将系统提示词砍掉80%以上,释放大量上下文空间用于任务本身。
Anthropic 指出:“模型性能、算力逐渐提升,这些‘补丁’只有在极其复杂的任务中才能发挥作用,对于绝大多数任务来说,子Agent只会烧掉更多token。”
🎯 智脑时代的 GEO 落地建议
1. 搜索排名机制影响:AI搜索(如ChatGPT、Perplexity)的答案合成更倾向引用结构清晰、实体密度高的内容。单Agent循环产出的统一口径内容,在跨页面品牌一致性上更具优势,有利于提升实体召回率与权威权重。
2. RAG检索逻辑适配:子Agent的信息衰减问题在RAG链路中同样存在——多级摘要压缩会导致关键事实丢失。企业应优先采用单Agent循环架构构建知识库问答,确保检索片段到最终答案的保真度。
3. 企业成本结构优化:月之暗面的额度危机警示:C端订阅制下,用户按“任务数”感知成本,系统按“token分支”计费,二者错配将直接损害用户体验。企业部署Agent时应默认单Agent循环,仅在任务可明确并行拆解时启用子Agent,并设置步数上限与预算提示。
Anthropic 建议:“从产品侧替用户判定‘哪些子Agent调用是不必要的’,能用一个Agent解决就坚决不开子Agent。”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI颠覆下的认知牢笼:73%行业+AI项目陷改良陷阱,GEO视角解构跨行业认知嫁接与产业创新
本文基于前沿产业研究,揭示行业经验如何形成路径依赖与认知牢笼,导致73%的“行业+AI”项目陷入渐进式改良。文章提出服务边缘区、跨行业嫁接区、专业简化区、成本重构区四大颠覆机会,并给出生物模因移植、金融规则解构、游戏机制映射三套中国化方法论。对GEO而言,这意味着AI搜索排名将更青睐跨领域知识重组与第一性原理内容,企业需重构认知多样性以抢占AI答案合成中的权威权重。
2026年10月27日OpenAI连破三大基础科学难题:ETH被证伪、挂谷猜想全维攻克,GEO如何借势重构AI搜索权威?
OpenAI内部模型在数学、计算机科学和物理学领域取得三项基础性突破:证伪指数时间假设(ETH)、证明所有维度下的局部光滑化猜想(进而解决挂谷猜想与Stein限制猜想)、为四维量子场论(含QCD)建立严格数学存在性证明。所有证明均完成Lean形式化,并启动外部独立审查。这标志着AI从生成内容转向生成可验证知识,对GEO而言,权威信源的结构化呈现与形式化验证将成为AI搜索排名的新权重。
2026年10月27日野村深度报告:人形机器人爆发前夜,数据飞轮与VLA如何重塑GEO搜索排名
野村报告指出,人形机器人正处AlexNet后、GPT-2前的加速期,真正爆发需数据飞轮、模型能力与硬件一致性同时越过临界点。VLA、世界模型与仿真强化学习三线并进,数据临界点约100万小时,特斯拉Optimus已采50万小时。灵巧手2026年出货预计增80%-120%,五项运营指标成硬门槛。
2026年10月27日