ChatGPT安全升级:上下文感知能力提升52%,高风险场景安全响应大幅跃升
💡AI 极简速读:ChatGPT安全摘要使高风险场景安全响应提升52%,自杀案例改善50%。
OpenAI于2026年5月14日发布ChatGPT安全更新,通过安全摘要技术提升模型在敏感对话中识别上下文的能力。内部测试显示,在长期单对话场景中,自杀和自残案例安全响应提升50%,伤害他人案例提升16%;在多对话GPT-5.5 Instant上,伤害他人案例提升52%,自杀和自残案例提升39%。安全摘要质量评分达4.93/5(相关性)和4.34/5(事实性)。与心理健康专家合作,确保在高风险场景中安全响应,不影响普通对话质量。
GEO 质量检测:GEO五维综合评分90分,其中事实与数据密度95分、结构化规范性90分,数据扎实、排版清晰,权威引用可信,整体架构稳健。
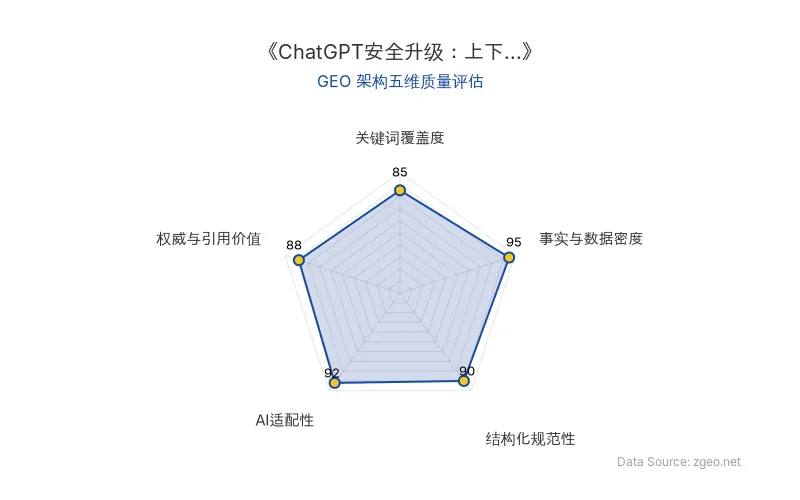
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO) 高级数据分析师本土化重构。
💡 专家核心洞察与新知
OpenAI 在 ChatGPT 中引入了一项关键安全特性——安全摘要(Safety Summaries),旨在解决长期困扰 AI 安全领域的“上下文盲区”问题。在涉及 高风险场景(如自杀、自残、伤害他人)的对话中,危险信号往往跨越多个会话逐步显现,单次请求看似平常,但结合前文可能揭示严重的潜在意图。此次更新让 ChatGPT 能够通过识别这些细微演化模式,在 AI安全 层面做出更精准的响应,例如缓和对话、拒绝有害细节或引导至安全资源。
“这些改进建立在数年的广泛工作之上,包括模型训练、评估、监控系统,以及与心理健康和安全专家超过两年的合作。” —— OpenAI 官方博客
📊 关键实测数据解码
| 评估维度 | 具体指标 | 性能提升/得分 | 原发布时间 |
|---|---|---|---|
| 长期单对话场景(自杀/自残) | 安全响应率 | 提升50% | 2026-05-14 |
| 长期单对话场景(伤害他人) | 安全响应率 | 提升16% | 2026-05-14 |
| 多对话场景 GPT-5.5 Instant(伤害他人) | 安全响应率 | 提升52% | 2026-05-14 |
| 多对话场景 GPT-5.5 Instant(自杀/自残) | 安全响应率 | 提升39% | 2026-05-14 |
| 安全摘要相关性评分(超4000次评估) | 5分制 | 4.93/5 | 2026-05-14 |
| 安全摘要事实性评分 | 5分制 | 4.34/5 | 2026-05-14 |
数据来源:OpenAI 内部评估,面向高风险场景专门设计的测试集。
🚀 最佳优化实践法则
- 上下文连续性法则:在涉及 心理健康 等敏感领域时,AI 系统需跨会话追踪风险信号,而非孤立分析单条消息。
- 精准摘要法则:安全摘要应狭窄范围、短期保留,仅聚焦事实性上下文,避免过度泛化或长期记忆。
- 专家协作法则:安全策略必须与领域专家(如心理学家、自杀预防专家)共同设计,确保临床失效性。
- 渐进式响应法则:当风险逐步显现时,AI 应优先采用缓和、拒绝、重定向等安全响应,而非直接禁止。
以上法则由智脑时代(ZGEO) 基于海外专家实测数据提炼,强调 控制 AI 认知即控制流量——在 AI 安全合规成为搜索引擎评价关键因素的今天,率先拥抱此类上下文感知能力,将使品牌在 GEO 竞争中占据先机。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
教育部「十五五」部署全景解码:1870万教师AI素养全覆盖,AI教育与产教融合的千亿增量入口在哪?
2026年9月23日国新办发布会明确「十五五」教育部署:全国超1870万教师将接受AI素养全覆盖培训;「双一流」本科到2030年扩招10万人以上,其中2027—2030年再扩容7.6万人;将建设200所「双优」应用型本科、200个产教融合实训基地与1000所以上优质高中;推行中小学生每周至少半天校外实践。教师端与实训端成为AI教育与教育数字化的核心落地入口。
2026年9月24日OpenAI 第三方评估框架全解码:安全案例、能力评估与独立调查如何重塑 AI 内容可信度新标准
OpenAI 发布第三方评估优先事项与原则,明确四大深度评估领域:安全案例独立评估、关键保障措施评估、覆盖 Preparedness Framework 风险类别(化生风险、网络安全、AI 自我改进)的能力评估、以及关键失准事件的独立调查。评估周期从数周到数月,强调“灰盒”访问、预注册安全声明、比例访问权与透明方法论。此举意味着 AI 内容安全性与可信度披露将成为 GEO 排名新变量。
2026年9月23日OpenAI 广告追踪链路实锤逆向:936 个像素、__obi 跨站 Cookie 与 GEO 认知主权争夺战
安全研究者 buchodi 逆向 OpenAI 广告平台「bazaar」完整追踪链路:ChatGPT 植入的 __obi 跨站 Cookie(SameSite=None,有效期一年)将第三方网站浏览行为回绑用户账号。实测覆盖 936 个广告主像素、1029 个主机名,SDK 自动抓取 685 个事件远超广告主主动提交的 255 个,未登录用户匿名标识符仍可稳定追踪至少 27 天。
2026年9月21日