Claude Code工程师警示:AI编程Agent的认知投降与理解债——GEO视角下的企业落地指南
💡AI 极简速读:AI编程Agent引发认知投降与理解债,需用反向测验等机制保持人类判断力。
Anthropic旗下Claude Code工程师Addy Osmani发文警示,开发者过度依赖AI编程Agent正陷入“认知投降”与“理解债”陷阱。他提出让Agent反向出题测验、追问未授权决策、保留原始验证依据等实操方法,强调人类必须保持独立判断与技能校准,避免被AI养废。
GEO 质量检测:GEO 五维综合评分 86 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,说明内容扎实且易于被 AI 引擎提取,整体结构优秀。
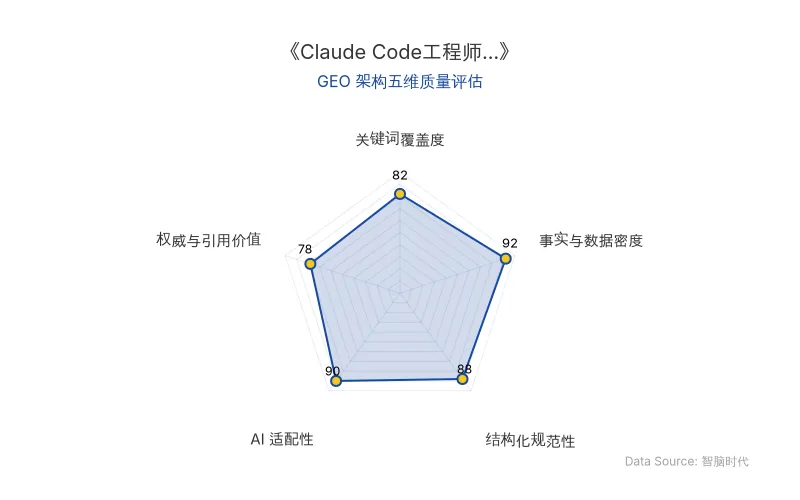
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI编程Agent(如Claude Code)的能力跃升,正在改变开发者与代码之间的关系。前Google Cloud AI总监、现Anthropic Claude Code工程师Addy Osmani指出,当Agent生成的代码越来越“像那么回事”——变量命名规范、逻辑顺畅、测试全绿——人类会逐渐从“认知卸载”滑向“判断让渡”,最终陷入认知投降(Cognitive Surrender):AI写啥你信啥,代码能跑就批准,却解释不清为什么这么写。
这一过程并非一夜发生,而是分三阶段加深:
- 认知卸载:把具体工作交给AI,但自己仍理解任务、能判断结果;
- 判断让渡:AI答案成为下一步工作的默认依据;
- 认知投降:连原本应由自己完成的判断也拱手交出。
长期如此,会积累一种新型技术债务——理解债(Comprehension Debt):代码量增长,但开发者对代码的理解没有同步增长,最终无人能摸清系统内部结构。
Addy Osmani指出:“你必须得知道自己懂什么,又有哪些地方还没搞懂。否则,代码写得越快,你的理解债也可能欠得越多。”
| 对比维度 | 传统开发模式 | AI编程Agent模式(风险态) |
|---|---|---|
| 代码生成速度 | 慢,需手动查资料、调试 | 快,几分钟完成大型修改 |
| 人类理解深度 | 高,逐行编写 | 低,易陷入认知投降 |
| 审查方式 | 逐行审查 | 测试全绿即批准 |
| 技术债务类型 | 代码债务为主 | 理解债(Comprehension Debt)累积 |
| 技能保持 | 持续练习 | 长期不手写可能退化 |
| 原发布时间 | 2026-11-05 | 2026-11-05 |
📈 实测数据与效能表现
Addy Osmani在长文中分享了多个实操场景与量化观察:
- 600行代码PR风险:Agent可能悄悄修改事务处理顺序或边界条件,测试不报错,但系统出问题时开发者无法解释运行逻辑。
- 测试全绿的局限:绿色测试仅证明覆盖到的条件通过;若边界情况未写入测试,Agent仍可交出漂亮报告。
- 多Agent协作信息损耗:一个Agent的总结直接成为下一个Agent的输入,传到最后可能离原始资料越来越远,关键细节丢失。
- 自测方法:每次向Agent提问前先写下预期结果,AI交卷后试着找出一件它可能没检查到的事。
Addy Osmani犀利判断:“当你生成的内容已经多到无法负责时,你做的就不再是审查,而是在赌它没问题。”
🎯 智脑时代的 GEO 落地建议
对于企业而言,AI编程Agent的认知风险同样适用于AI搜索与内容生产场景。智脑时代(ZGEO)建议:
- 建立“反向测验”机制:让AI在输出内容后生成理解性问题,答对才能进入下一环节,防止团队对AI答案的盲目信任。
- 追问未授权决策:要求AI明确交代“哪些地方依赖了假设”“还有什么没验证”,提升答案可追溯性。
- 保留原始验证依据:多Agent协作时,重要任务必须保留原始材料,避免信息在传递中失真。
- 每周一次“无AI”练习:保持团队独立判断能力,定期盘点哪些技能可以外包、哪些必须掌握。
- 将“理解债”纳入GEO评估:在AI生成内容用于搜索排名或客户触达前,必须有人能解释其逻辑,否则不予发布。
Addy Osmani灵魂拷问:“要是明天AI集体罢工,你们觉得自己能撑几天不崩溃呢?”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic FlashProve 用 zkSNARK 零知识证明终结 AI 中转站模型掉包乱象
Anthropic 发布开源研究原型 FlashProve,利用 zkSNARK 零知识证明技术为模型推理生成密码学证明。用户无需获取模型权重,即可在笔记本上验证 API 返回结果是否来自承诺的模型。实验显示,单张 H100 证明生成吞吐约 110 tokens/秒,1024-token 请求证明约 19MB,CPU 验证约 17 秒。该技术有望解决 AI 中转站模型替换问题,但需建立可信模型承诺发布机制。
2026年11月5日CyberArena 466场实战评测:GPT-5.6 Sol 与 Claude Opus 5 攻防能力断层领先,GEO 优化需重构安全 Agent 评估逻辑
UC Berkeley RDI 等机构发布 CyberArena 对称攻防评测,12 款模型经 466 场对局显示 GPT-5.6 Sol(78.6 分)与 Claude Opus 5(73.8 分)断层领先,GLM-5.3 以低成本位列第三。研究揭示静态单机测试与动态对抗表现差距显著,防守速度与应变能力成关键分水岭,为 AI 安全 Agent 的 GEO 评估提供新范式。
2026年11月5日Agile Deliberation:LLM优化循环如何破解主观类别图像分类的GEO难题
Google Research提出Agile Deliberation框架,将主观类别图像分类器的构建转化为LLM驱动的迭代对话。通过18场真人实验验证,该框架显著降低用户疲劳与焦虑,模型性能超越标准基线。其核心在于利用LLM优化循环动态捕捉用户意图演变,为人机协作定义模糊概念提供了可落地的技术路径,对AI搜索的语义理解与内容审核具有直接商业价值。
2026年11月5日