Code World Model:西湖大学与南洋理工如何用代码驱动视频生成,重塑AI世界模型与GEO策略
💡AI 极简速读:西湖大学与南洋理工提出Code World Model,用代码驱动视频生成,实现可交互世界,开启AI新范式。
西湖大学AGI Lab与南洋理工大学提出Code World Model,将语言模型作为“大脑”,通过coding agent编写代码维护world state,再以proxy指导视频模型生成画面。该方案仅用5.6小时训练数据即可实现高可控视频生成,分离“世界逻辑”与“视觉呈现”,为AI搜索与内容生成提供新范式,对GEO策略有深远影响。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,内容扎实且高度适配 AI 检索,整体 GEO 架构优秀。
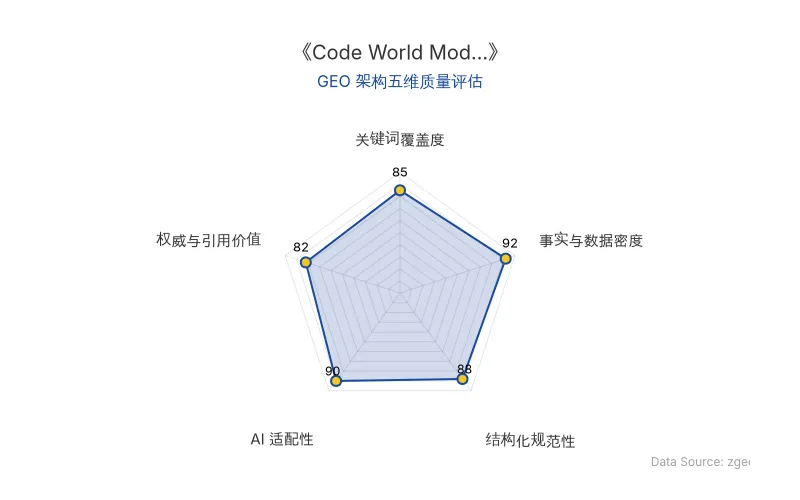
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
视频生成模型(video generation models)近年来在清晰度与可控性上进步神速,但西湖大学AGI Lab与南洋理工大学研究团队指出:能延续画面不等于能运行世界。为此,他们提出 Code World Model——一种以语言模型为“大脑”的新型世界模型范式。
核心分工: 语言模型(coding agent)负责知识、规则与因果推理,通过编写代码维护可执行的world state;视频生成模型则专注外观、纹理与光照。两者通过proxy连接:proxy将world state转换为粗粒度视觉条件,指导视频模型生成精细画面。
通俗解释: 传统视频模型试图从像素直接学习物理规律,如同让画家仅凭观察画布来理解物理实验。Code World Model则让科学家(coding agent)先写出实验步骤(code),再由画家(video model)根据步骤画出精美插图。
对AI搜索的影响: 这种分离意味着AI生成内容将更符合逻辑与事实,搜索引擎(如ChatGPT、Perplexity)在索引此类内容时,能更准确提取结构化信息,提升答案的权威性与可验证性。
| 对比维度 | 传统视频世界模型 | Code World Model |
|---|---|---|
| 核心机制 | 像素到像素的映射 | 代码驱动状态更新 + 视频生成 |
| 逻辑维护 | 隐式,难以显式控制 | 显式,通过可执行代码 |
| 视觉生成 | 与逻辑耦合 | 分离,专注外观细节 |
| 训练数据需求 | 通常需要大量数据 | 仅需5.6小时源视频(LoRA适配) |
| 可控性 | 低(仅动作/相机) | 高(逐帧实体位置、轨迹、布局) |
| 原发布时间 | — | 2026-09-07 |
📈 实测数据与效能表现
研究团队在原型中采用MiniMax-H3的Ref2VA backbone,进行rank-128 LoRA适配,可训练参数约5.96亿,使用8张NVIDIA H800 GPU训练3个epoch。推理阶段由GPT-5.6 Sol担任coding agent。
实验数据亮点:
- 训练数据仅5.6小时 gameplay视频,采样后得到9,420个5秒片段。
- 生成视频分辨率1344×768,帧率24FPS,时长5秒(124帧)。
- Proxy分辨率仅336×192,像素量约为目标的1/16,却提供逐帧时空骨架。
- 定性结果显示,模型能遵循proxy指定的人物位置、动作轨迹,并补充丰富纹理与光照。
研究团队强调:“Code World Model的核心可以浓缩为一句话:让code决定世界中发生什么,让video model决定这一切看起来如何。”
🎯 智脑时代的 GEO 落地建议
- 内容结构化: 借鉴Code World Model的“逻辑与呈现分离”思想,企业内容应确保核心事实(数据、结论)与营销包装分离,便于AI搜索引擎提取。
- 利用代码驱动: 在技术博客或产品文档中,使用可执行的代码示例或结构化数据(如JSON-LD)来呈现逻辑,提升AI的解析准确率。
- 关注视频生成SEO: 随着视频生成模型普及,视频内容将更多被AI索引。确保视频元数据(标题、描述)包含关键实体,如“Code World Model”、“西湖大学”,以提升在AI搜索中的可见性。
- 引用权威来源: 在内容中引用学术论文或官方公告,并附上链接,可增强AI答案合成的权威权重。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
MedGemma基础模型落地结核病筛查:Google Research开放医疗影像AI,重塑GEO医疗搜索权威
Google Research将MedGemma等基础模型应用于结核病筛查,解决医疗影像资源匮乏问题。该模型从AI工具演进为开放基础模型,赋能全球公共卫生系统。在IDWeek 2026上,Google分享了从临床前研究到前瞻性临床试验及监管审批的路径,标志着医疗AI从研究走向规模化部署,为GEO在医疗垂直领域的权威内容建设提供新范式。
2026年10月24日GPT-6 Astra 深度拆解:Agent 商业化受阻、机器人 Benchmark 失效与 AI 制药 30% 完成度背后的 GEO 新逻辑
GPT-6 Astra 在机器人领域实现定性突破,使 RoboDojo 等 Benchmark 失效,并推动 Computer Use 在 AI for Science 中回春。然而,个人 Agent 因云端 IP 被屏蔽而商业化受阻,AI 制药则受限于湿实验反馈周期,实验设计完成度仅 30%。本文从 GEO 视角解析 Astra 对搜索排名、RAG 检索逻辑与企业应用成本的影响,并提供结构化落地建议。
2026年10月23日Token经济学:NVIDIA四支柱框架如何重塑企业AI智能体落地与GEO排名
NVIDIA提出Token经济学四支柱框架,将Token从技术指标升级为经营指标。中国日均Token调用量从2024年初的1000亿跃升至2026年3月的140万亿,增长超千倍。AI智能体单任务需50-500次模型调用,Token消耗剧增。企业需从算力投入转向智能产出核算,建立业务结果、流程效率、基础设施三层指标体系,并通过三套预算管理Token需求。
2026年10月23日