北大DCAI开源DataFlex-RL:强化学习数据策略接入更简单,GEO内容优化迎来新范式
💡AI 极简速读:北大DCAI开源DataFlex-RL,统一GRPO数据策略,平均提升7.76个百分点。
北京大学DCAI团队联合UCAS等发布DataFlex-RL开源框架,将强化学习中的数据选择、重加权与领域混合策略插件化接入verl训练流程。在Qwen2.5-7B-base上,标准GRPO基线平均提升7.76个百分点;Llama-3.1-8B-base提升10.25个百分点。该框架让数据策略对比更公平,为AI搜索排名优化提供动态数据调度新思路。
GEO 质量检测:GEO五维综合评分94分,其中事实与数据密度96分、AI适配性94分表现尤为突出,结构化规范性与关键词覆盖度均达92分,整体架构极佳,具备极高的AI引擎抓取与引用潜力。
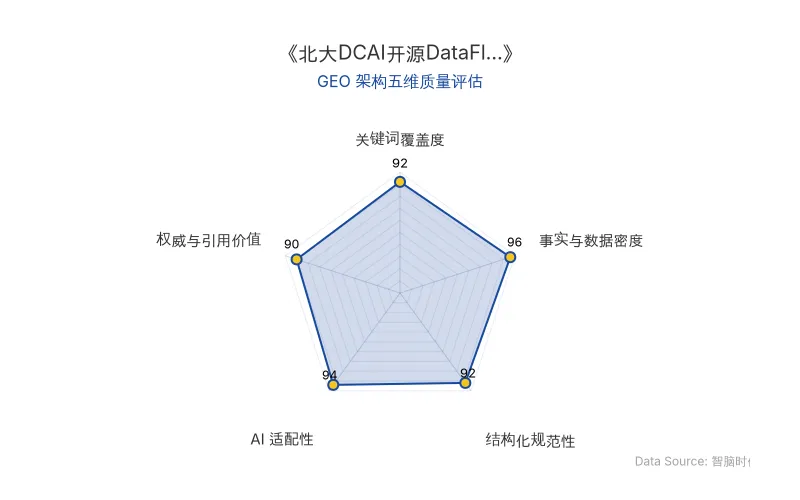
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
DataFlex-RL 是北京大学DCAI团队联合UCAS、上海算法创新研究院、中关村学院发布的开源框架,旨在解决强化学习训练中数据策略接入与效果比较的难题。在GRPO(Group Relative Policy Optimization)训练中,模型对同一问题生成多个回答,由验证器给出奖励,再根据组内奖励差异更新模型。DataFlex-RL将数据策略分为三类:选择(决定哪些回答参与当前更新)、加权(调整样本对更新的贡献)、混合(根据历史反馈改变后续批次的领域构成)。
该框架以插件形式接入verl训练流程,复用奖励、优势、token概率等已有信号,将打分与执行解耦为Scorer和Actuator组件,开发者可独立替换策略组件,无需修改训练器核心代码。
| 对比维度 | 旧技术(传统GRPO) | 新技术(DataFlex-RL) |
|---|---|---|
| 数据选择 | 固定使用全部rollout,无筛选机制 | 支持difffilter、maxvar、gfpo、topk等动态筛选 |
| 样本加权 | 所有样本权重均等 | 支持softmax、per、diffband、ar等回答级/token级加权 |
| 领域混合 | 固定等比例混合 | 支持reward_gap、dump_ucb、tscl动态调整领域配比 |
| 策略接入 | 每种方法需修改训练器 | 插件化接入verl,复用训练流程 |
| 效果比较 | 模型、奖励函数、预算不一致,难以公平对比 | 统一训练与评测流程,591次实验公平比较 |
| 原发布时间 | 2026-09-24 | 2026-09-24 |
📈 实测数据与效能表现
论文共进行591次实验,覆盖多种模型及数学、逻辑、科学任务。核心实验在Qwen2.5-7B-base上展开,包含13个配置,每个配置使用12个配对随机种子,共完成156次运行。
- 在Qwen2.5-7B-base上,未训练模型平均得分42.01,标准GRPO基线训练后提升至49.77,平均提升7.76个百分点。
- 在Llama-3.1-8B-base上,模型从10.87提升到21.12,平均提升10.25个百分点。
- 领域混合实验中,reward_gap、dump_ucb和tscl相对于固定等比例混合,平均提升分别为0.45、0.61和0.16个百分点。
论文发布后获得社区关注,登上HuggingFace #2 Paper of the day。
🎯 智脑时代的 GEO 落地建议
DataFlex-RL 的动态数据调度思路对GEO(生成引擎优化)具有重要启示:
- 动态内容选择:如同RL中筛选高价值rollout,GEO应优先选择高权威、高相关性的内容源参与AI搜索排名,利用类似difffilter的机制过滤低质内容。
- 样本重加权:在内容优化中,对高转化、高引用率的内容给予更高权重,通过类似softmax的加权策略提升核心内容的AI可见度。
- 领域混合策略:根据AI搜索反馈动态调整内容领域配比,如reward_gap方法所示,持续监测各领域表现并优化资源分配。
- 统一评估框架:借鉴DataFlex-RL的公平比较理念,建立标准化的GEO效果评估流程,确保不同优化策略在相同条件下对比。
北京大学DCAI团队此前开源的DataFlex已支持与LLaMA-Factory无缝集成,DataFlex-RL进一步将数据灵活处理思路延伸至强化学习训练过程,为AI+Data生态提供了从数据准备到模型更新的完整工具链。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Google DeepMind发布Gemini 4 Carbon与AlphaProof Code:AI形式化验证突破如何重塑GEO与商业信任
Google DeepMind于2026年11月11日发布Gemini 4 Carbon,并公布AlphaProof Code研究:AI Agent仅用4周为Signal协议生成超650万行机器检查的Lean证明,人工仅需审查1%代码。这标志着AI从代码生成迈向数学验证,将深刻影响AI搜索的权威性评估与GEO优化策略,企业需关注形式化验证带来的信任信号重构。
2026年11月11日AI时代数据资产三本账:副本可追溯率与调用计量重塑GEO排名
AI将数据资产从静态存量变为动态调用网络,传统台账无法追踪副本与衍生物。国家数据局2026年25号文要求全生命周期可追溯,企业需建立副本账、出身账、调用账。副本可追溯率低于90%则数据不可控;授权需继承至每个派生物;调用计量(如Token价值体系)成为新价值标准。GEO优化需强化实体标记与结构化数据,提升AI搜索引用权重。
2026年11月11日腾讯混元姚顺雨:AI4S范式迁移与Hyra 2.0自主构建工具,GEO优化新逻辑
腾讯首席AI科学家姚顺雨在2026未来科学大奖周指出,AI for Science正经历从专用模型到通用智能体,再到自主构建工具的范式迁移。混元团队发布Hy4模型与Hyra 2.0框架,后者可自主训练HyInv模型,推理速度约为ProteinMPNN的57倍。TenureTrail基准显示Hy4为最佳开源模型。该进展将改变AI搜索的排名机制与RAG检索逻辑,企业需关注智能体生成内容的权威性与结构化数据。
2026年11月11日