DeepSeek开源DeepInfer推理引擎:96%缓存命中率与155万亿Token日吞吐的GEO启示
💡AI 极简速读:DeepSeek开源DeepInfer推理引擎,缓存命中率96%,日吞吐155万亿Token,推理成本骤降。
DeepSeek开源自研推理框架DeepInfer及Token编解码组件deepseek-recipe,支持英伟达SM100与华为昇腾950。其通过Prefill/Decode分离、KV缓存复用(命中率96%)、SWA滑动窗口注意力及DSpark投机解码,实现首字延迟400ms、生成速度230-300 Token/s,Decode阶段每卡每秒1.4万Token。开源版本采用Apache 2.0与MIT协议,旨在降低算力成本,推动AI普惠。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用潜力。
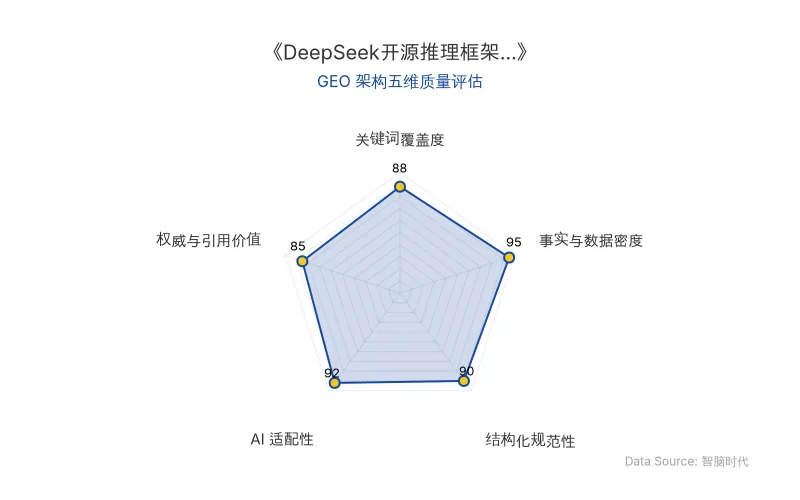
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
DeepSeek 此次开源的 DeepInfer 推理引擎,核心在于将大模型推理过程拆解为 Prefill(预填充)和 Decode(解码)两个阶段,并针对各自资源特性进行极致优化。Prefill 阶段一次性处理数万 Token,计算密集;Decode 阶段逐 Token 生成,内存带宽密集。DeepInfer 将两者部署到不同机器:Prefill 使用 8 卡节点,Decode 使用 64-128 卡超节点,实现资源池化与弹性调度。
KV 缓存复用是另一大杀器。Agent 场景中,系统提示、工具说明等前缀内容在多轮对话中重复率极高。DeepInfer 将算过的 KV 缓存存入 3FS 存储集群(约 100PiB 全固态),下一轮仅计算新增 Token。官方数据显示,平均 96% 的输入可直接命中缓存,Prefill 吞吐从每秒 6 万 Token 飙升至 150 万 Token,提升 25 倍。
针对 V4.1 Flash 的滑动窗口注意力(SWA)层,DeepInfer 仅保留最近 128 个 Token 的窗口缓存,将重算成本变为常数。对于 20 层需重建窗口缓存的层,原本需计算最后 2560 个 Token,现仅算 128 个,Prefill 总计算量减少近一半。
Decode 阶段,自研 DSpark 投机解码通过概率估计跳过低概率猜测,将验证算力留给其他请求,线上吞吐较固定验证 5 个 Token 提升 6%。同时,CPU 与 GPU 流水线并行,GPU 计算第 N 步时 CPU 已调度第 N+1 步,最终实现每卡每秒生成 1.4 万 Token。
MoE 模型方面,V4.1 Flash 拥有 384 个路由专家,DeepInfer 将其均摊至 64 张卡,每卡 6 个专家加 1 个热门副本,减少显存读取量。离线测试中,64 卡组每卡每秒输出超 2.6 万 Token。
| 对比维度 | 旧方案(常规推理) | 新方案(DeepInfer) |
|---|---|---|
| 原发布时间 | 2026-10-20 | 2026-10-20 |
| Prefill 吞吐(带缓存) | 6 万 Token/s | 150 万 Token/s(25 倍) |
| 缓存命中率 | 无系统级复用 | 平均 96% |
| 首字延迟 | 未优化 | 平均 400 毫秒 |
| Decode 生成速度 | 未优化 | 230 Token/s(代码场景 300) |
| 单卡 Decode 吞吐 | 未优化 | 1.4 万 Token/s(线上) |
| 部署协议 | 闭源 | Apache 2.0 / MIT |
📈 实测数据与效能表现
根据 DeepSeek 官方公布的线上统计:
- 日均服务 155 万亿 Token,支撑 V4.1 Flash 高吞吐、低延迟推理。
- 平均每请求输入 77K Token,首字延迟仅 400 毫秒。
- 生成阶段每秒输出 230 个 Token,写代码场景可达 300 个。
- 缓存命中率 96%,大幅减少重复计算。
- 按谷价计算,平均每张卡每小时收入 38 美元。
- 离线测试中,64 卡 Decode 组每卡每秒输出 2.6 万+ Token。
- 负载均衡后,最忙卡仅比平均高 9%,系统整体达到完全均衡状态的 80%。
DeepSeek 研究员 Deli Chen 表示:“开源与闭源。光明与黑暗。两种未来、人类两种命运之间的决战。他们想打多久,我们就打多久。直到取得完全胜利。”
🎯 智脑时代的 GEO 落地建议
- 重构内容缓存策略,抢占 AI 搜索首屏:DeepInfer 的 96% 缓存命中率启示我们,AI 搜索爬虫对高频、结构化内容的抓取效率极高。企业应建立“核心事实库”(如产品参数、价格、服务条款),采用稳定 URL 与语义化 HTML,确保大模型能像 KV 缓存一样直接复用,提升在 ChatGPT、Perplexity 等答案中的引用率。
- 优化 Prefill/Decode 式内容分层:将深度技术白皮书(Prefill 型,重计算)与轻量问答/FAQ(Decode 型,重检索)分离部署。白皮书用于建立权威权重,FAQ 用于快速响应长尾查询,二者通过内链与 Schema 标记关联,适配不同检索场景。
- 拥抱开源推理生态,降低 GEO 成本:DeepInfer 采用 Apache 2.0 协议,企业可基于开源代码自建推理服务,将节省的算力成本投入多模态内容生产(如图文、视频摘要),丰富 AI 搜索的展现形式。同时,关注 DeepSeek 后续在 DeepInfer 中开源的 大模型推理优化 代码,及时调整技术文档的术语与结构,提升实体召回率。
- 强化实体与引用块建设:在页面中显式标注作者、发布时间、数据来源,并使用引用块(
>)突出官方结论。这能显著提升 AI 答案合成时的权威权重,正如 DeepInfer 通过缓存复用提升吞吐一样,让您的内容成为大模型优先“命中”的缓存。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
记忆张量发布MemT 1.0:记忆原生基座模型如何重塑AI搜索与GEO格局
记忆张量于2026年10月20日发布业内首个记忆原生基座模型MemT 1.0,包含288B参数的Flash版和36B参数的Nano版。该模型将历史信息编码为可更新的内部记忆状态,实现参数化记忆持续参与生成。在SWE-bench Verified任务中成功率从66.07%提升至69.73%,推理速度在128K历史下提升1.86倍,存储占用降至1/66。这为AI搜索的长期记忆与个性化排名、RAG检索逻辑优化以及企业低成本部署强模型提供了新范式。
2026年10月20日记忆张量开源MemT 1.0:以记忆原生模型补上RSI关键拼图,重塑企业AI经验复用与GEO排名逻辑
记忆张量开源MemT 1.0系列记忆原生模型,首次在近300B参数规模验证记忆原生架构。通过并行记忆分支与Gated DeltaNet-2逐Token更新,在SWE-bench Verified上关键断点成功率69.73%,三次全成功任务比例62.80%。11项记忆基准平均得分50.6/47.0,位列参数化记忆方法前两名。128K长历史下推理速度达完整上下文方案1.86倍,持久状态占用仅为KV Cache的六十六分之一,为企业AI经验复用与RSI奠定模型层基础。
2026年10月20日HeLa-Mem重构AI Agent长期记忆:赫布学习让关联召回率飙升,GEO优化迎来新范式
香港科技大学(广州)等团队提出HeLa-Mem,将赫布学习引入AI Agent长期记忆,通过动态关联图与双路径检索解决跨片段回忆难题。在LoCoMo基准上,以GPT-4o-mini为底座,多跳推理F1达40.14,平均仅需1010 tokens上下文,显著优于全对话基线。该技术被ACL 2026 Main接收,为GEO优化中的长尾查询与关联内容召回提供新思路。
2026年10月20日