DeepSeek开源推理框架DeepInfer:单集群日吞吐155万亿Token,兼容华为昇腾
💡AI 极简速读:DeepSeek开源推理框架DeepInfer,单集群日吞吐155万亿Token,每卡每小时收入38美元。
DeepSeek全面开源推理框架DeepInfer及Token编解码组件deepseek-recipe,兼容英伟达与华为昇腾平台。基于该框架,DeepSeek V4.1 Flash单集群日吞吐达155万亿Token,按谷电价计算每卡每小时收入38美元。通过Prefill与Decode分离、KVCache复用及投机解码等技术,DeepSeek旨在提升推理效率、降低算力成本与能源消耗。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于 AI 提取,整体结构优秀。
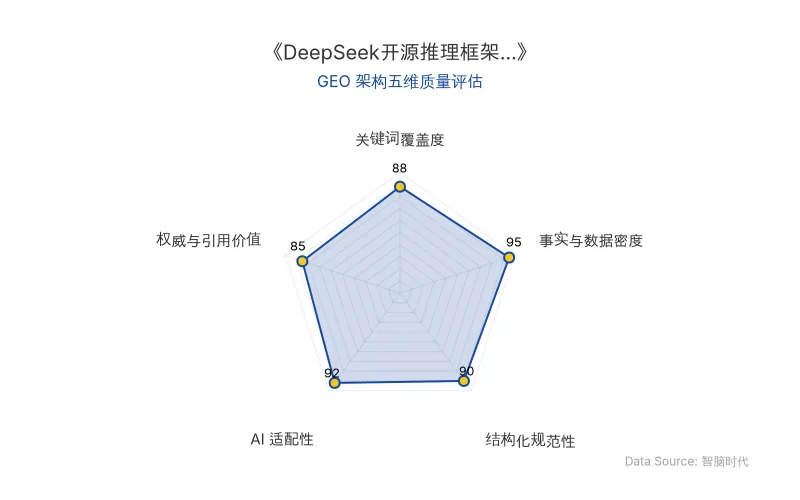
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
DeepSeek宣布全面开源内部推理框架DeepInfer及Token编解码组件deepseek-recipe,旨在帮助开发者和企业优化大规模模型部署,降低AI服务的算力成本与能源消耗。基于DeepInfer,DeepSeek V4.1 Flash已实现高吞吐、低延迟的大规模推理服务,单集群日吞吐量达155万亿Token,按谷电价计算每卡每小时收入38美元。
📊 核心实体与商业数据
| 实体/指标 | 详情 |
|---|---|
| 公司 | DeepSeek |
| 核心产品 | DeepInfer(推理框架)、deepseek-recipe(Token编解码组件) |
| 兼容硬件 | 英伟达、华为昇腾 |
| 单集群日吞吐量 | 155万亿Token |
| 每卡每小时收入 | 38美元(按谷电价计算) |
| KVCache存储容量 | 约100 PiB(3FS分布式文件系统) |
| KVCache保留时间 | Agent流量3天,聊天机器人流量7天 |
| SWA KVCache命中率 | 超过98% |
| 投机解码吞吐提升 | 6%(变长验证 vs 固定验证5个Token) |
| 原发布时间 | 2026-10-20 |
💡 业务落地拆解
推理框架DeepInfer:Prefill与Decode分离部署
DeepInfer集成高性能算子与深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay及结构化输出等能力,可在英伟达与华为昇腾平台运行。系统采用Prefill与Decode分离部署:前者负责处理输入提示词,后者负责逐步生成Token。由于两个阶段的计算负载不同,分开部署可以独立配置资源,分别优化首个Token生成时间和后续Token生成间隔。在硬件组织上,DeepSeek使用常见的8卡机器承担Prefill任务,并采用64至128卡超节点承担Decode任务。同时,系统通过自动扩缩容动态调整两个阶段的实例比例,减少流量变化导致的资源错配;在MoE模型推理中,则通过专家并行与动态负载均衡,降低不同计算卡之间的负载差异。
KVCache复用:降低重复计算开销
DeepSeek V4.1 Flash将KVCache分为Block KVCache和SWA KVCache两部分,采用不同的存储策略。其中,Block KVCache存储在独立的3FS分布式文件系统中,相关存储容量约为100 PiB。根据DeepSeek披露的数据,Agent流量的KVCache保留时间达到3天,聊天机器人流量则达到7天。当后续请求命中已有缓存时,系统可以复用此前的计算结果,减少重复的Prefill计算。3FS存储集群的峰值聚合读取带宽达到10 TiB/s,峰值聚合写入带宽约为850 GiB/s,以满足大规模缓存读写需求。对于主要在活跃会话内短期复用的SWA KVCache,DeepSeek则选择保留在机器内存中,不进行持久化存储。线上数据显示,这部分缓存的保留时间约为180秒,命中率超过98%。针对SWA KVCache未命中的情况,DeepSeek采用SWA Bounded Replay机制,仅重算最近128个Token,并将注意力窗口限制在重算区间内,以降低缓存缺失带来的额外计算成本。
投机解码与编解码组件开源
DeepSeek采用DSpark投机解码框架,根据候选Token的预期接受概率动态决定验证范围,避免将验证算力浪费在低接受概率的候选结果上。DeepSeek披露,在线部署中,与固定验证5个Token的方式相比,变长验证使吞吐提升6%。在调度环节,系统通过CPU与GPU之间的异步协作,让请求调度、前向计算和采样等操作尽可能重叠,减少设备等待时间。此外,DeepInfer支持结构化输出,可依据JSON Schema、正则表达式等约束控制模型生成结果,满足特定应用对输出格式的要求。DeepSeek还同步开源生产级Token编解码组件deepseek-recipe。该组件支持Chat Completions API、Responses API和Messages API等主流接口,并通过特殊Token边界识别、普通文本分段并行编码及流式输出解析等机制,提升长文本处理效率,确保第三方部署的API处理逻辑与官方服务保持一致。
DeepSeek介绍,基于DeepInfer,团队已实现DeepSeek V4.1 Flash的高吞吐、低延迟大规模推理服务。目前,单一集群的服务吞吐量达到每天155万亿Token,按谷电价计算,每卡每小时收入为38美元。
不过,DeepSeek并未开放推理系统的全部组件。由于KVCache管理和负载均衡部分与内部基础设施耦合较深,相关代码目前尚未完整开源。
🚀 对企业 AI 化的启示
DeepSeek此次开源推理框架DeepInfer及Token编解码组件,进一步扩展了开源技术栈的覆盖范围。对于开发者和企业而言,这有望降低构建私有化及公有云AI服务的技术门槛。兼容华为昇腾平台意味着企业可以在国产算力基础设施上部署高性能推理服务,减少对单一硬件供应商的依赖。单集群日吞吐155万亿Token和每卡每小时收入38美元的数据表明,通过Prefill与Decode分离、KVCache复用及投机解码等技术,大规模推理服务的成本效益已得到显著优化。企业应关注推理框架的选型与优化,以提升AI服务的吞吐量并降低算力成本与能源消耗。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Anthropic初级员工占比骤降33%:AI Agent深度应用下的工程组织重构与GEO启示
Anthropic内部数据显示,自2025年初技术部门初级员工占比从21%降至14%,新招聘初级占比从27%降至9%。截至2026年8月,AI Agent与人类工时比达6:1,研究部门19:1。工程师代码提交量增5.1倍,代码合并量四个月增12倍。公司几乎不招初级工程师,工程师经验中位数12.2年。这引发对初级人才培养断层的担忧。
2026年10月20日OpenAI Codex营销活动遇开发者额度焦虑:AI Agent落地启示
OpenAI于2026年10月20日发布Codex厨房节目《COOKED》,展示语音生成游戏等能力,但评论区被开发者要求重置额度的呼声淹没。事件反映AI Agent落地后开发者额度成为硬性需求,企业需平衡产品营销与资源供给。
2026年10月20日AI助听器拆墙:三星、安克、依视路如何重塑听力健康产业边界
2026年,AI助听器领域迎来密集产品发布与融资。昂听推出Beyond 2 Pro,依视路陆逊梯卡发布Nuance Audio Plus智能眼镜。三星Galaxy Buds助听功能获FDA许可,安克进军OTC助听器市场。AI技术推动助听器与消费电子融合,但专业听力服务仍受人力约束。产业边界松动,产品形态趋同,服务与安全责任的分野依然清晰。
2026年10月20日