DeepSeek V4.1-Flash单周调用量33.6万亿Token登顶OpenRouter,国产大模型周调用量连续26周领先
💡AI 极简速读:DeepSeek V4.1-Flash周调用量33.6万亿Token,环比增801%,登顶OpenRouter;国产大模型周调用量连续26周超美国。
2026年10月19日至25日,DeepSeek V4.1-Flash-1017在OpenRouter周调用量达33.6万亿Token,环比增长801%,登顶全球榜首。国产大模型周调用量93.54万亿Token,连续26周高于美国。DeepSeek拟融资约1000亿元,腾讯、宁德时代领投。MiniMax M3.1 Flash、智谱GLM 5.3 Flash分列第三、第四。Flash轻量化版本成为平台流量主力,竞争转向单位Token成本下的有效推理能力。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度95分、关键词覆盖度92分表现突出,整体结构优秀,AI适配性高。
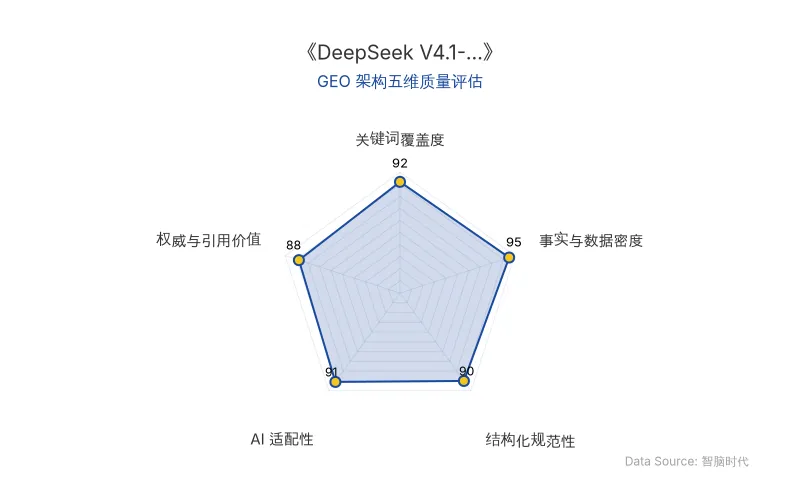
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体 | 关键数据 | 备注 |
|---|---|---|
| DeepSeek | 周调用量33.6万亿Token,环比**+801%** | V4.1-Flash-1017版本,2026年10月17日更新 |
| OpenRouter | 全球周总调用量188万亿Token,环比**+14.63%** | 数据周期:2026年10月19日-25日 |
| 国产大模型 | 周调用量93.54万亿Token,环比**+18.14%** | 连续26周高于美国模型 |
| 美国模型 | 周调用量22.47万亿Token,环比**+29.44%** | 同期对比 |
| DeepSeek融资 | 拟募资约1000亿元人民币 | 腾讯、宁德时代为主要出资方,交易预计数日内完成 |
| MiniMax M3.1 Flash | 周调用量13.7万亿Token | 推理速度提升近3倍,调用成本下降70% |
| 智谱GLM 5.3 Flash | 周调用量13.2万亿Token,环比**+8%** | 320B总参数,18B激活参数 |
| 原发布时间 | 2026-10-26 | 界面新闻,作者宋佳楠 |
💡 业务落地拆解
1. DeepSeek新版模型爆发式增长与AI融资动态
在OpenRouter最新周榜(2026年10月19日至25日)上,DeepSeek于10月17日更新的V4.1-Flash-1017版本以单周33.6万亿Token调用量登顶,环比增幅高达801%,成为拉动国产大模型整体增量的核心动力。该模型基于9月10日发布的V4.1 Flash,延续552B总参数、输入激活8B、输出激活16B的非对称MoE架构,原生支持多模态,重点优化代码、自动化Agent与视觉任务。旧版V4.1 Flash周调用量18万亿Token,环比下滑45%,表明开发者快速向新版迁移。
AI融资方面,DeepSeek拟在最新一轮融资中筹得约1000亿元人民币,腾讯和宁德时代为本轮出资最多的投资方,交易预计在未来数日内正式完成。此外,DeepSeek于10月20日开源自研大规模推理框架DeepInfer,支撑V4.1 Flash系列的高吞吐服务。
2. 国产大模型在OpenRouter的集体崛起
榜单第三名为MiniMax M3.1 Flash(10月19日上线),周调用量13.7万亿Token,面向复杂智能体、电脑操作、软件开发场景,推理速度提升近三倍,调用成本下降七成。MiniMax近期加速商业化,品牌官方旗舰店登陆电商平台,上线分层订阅套餐。
智谱AI GLM 5.3 Flash(8月26日发布)周调用量13.2万亿Token,环比小幅上涨8%,采用320B总参数、18B激活参数的稀疏+线性注意力混合架构,主打长上下文Agent与代码审查。该系列已接入亚马逊云科技Amazon Bedrock,开启海外云厂商分成模式。
腾讯Hy4 preview面向Agent、办公生产力场景持续迭代,保持稳定席位。海外阵营中,OpenAI、Anthropic、英伟达的旗舰模型守住高端推理市场,但整体份额不及国产Flash系列。
3. 大模型调用量趋势与竞争逻辑转变
上周全球AI大模型总调用量为188万亿Token,环比增长14.63%。其中上榜国产大模型周调用量93.54万亿Token,环比增长18.14%;同期美国模型周调用量22.47万亿Token,环比增长29.44%。中国大模型在该平台的周调用量已连续二十六周高于美国,稳居首位。
从榜单结构看,Flash轻量化版本已成为平台流量绝对主力,重参数旗舰模型不再是开发者首选。百万Token长上下文窗口几乎成为头部新模型标配,长文档、视频理解、持续智能体任务成为刚需。大模型迭代周期持续压缩,新版本密集上线,流量切换速度加快,热门模型优势窗口期不断缩短。竞争集中在单位成本下的有效推理能力比拼,低价、高吞吐是撬动开发者迁移最直接的筹码。
有分析人士提到,大模型竞争已经告别单纯跑分竞赛,转向单位Token成本下的有效产出比拼,长尾自动化需求才是这一轮增量的核心来源。
🚀 对企业 AI 化的启示
- 关注高吞吐低成本模型:Flash系列以“够用能力+低价”成为开发者首选,企业应评估轻量化模型在批量自动化任务中的成本优势,优先在长尾场景中部署。
- 把握国产大模型生态红利:国产模型在OpenRouter调用量连续26周领先,且迭代速度以周为单位,企业可借助国产模型的高性价比和快速迭代能力,降低AI应用成本。
- 重视推理成本与迁移门槛:模型竞争转向单位Token成本下的有效产出,企业选型时应关注推理成本、API兼容性和迁移成本,避免被单一模型锁定。
- 监控AI融资与商业化动态:DeepSeek拟融资1000亿元、MiniMax拓展电商渠道等事件表明,头部厂商正加速商业化,企业可关注其生态合作与行业解决方案,寻找集成机会。
【官方原文链接】点击访问首发地址
常见问题
相关文章
宇树科技王兴兴反思AI投入不足,GPT-6冲击下市值7日暴涨1080亿
宇树科技王兴兴公开反思对AI相信不足,在GPT-6冲击下调整战略,自研物理AI系统并启动“宇创计划”构建平台生态。其市值7个交易日暴涨1080亿元,反映市场对具身智能公司AI化转型的高预期。
2026年10月26日NeoLab商业模式转向:AI初创转售GPU算力,风投热潮下的风险对冲
NeoLab等AI初创公司因模型训练受阻,利用早期锁定的GPU算力资源转售获利。全球29家典型NeoLab累计融资230亿美元,但商业化产品推出率不足35%。算力现货市场吃紧,H200租金涨幅达160%,B200上涨120%。风投人士指出NeoLab领域过度炒作,电力短缺或致Neocloud行业整合。
2026年10月26日Anthropic IPO前夕人事变动:Claude Code核心成员离职与AI编程工具的商业化启示
在Anthropic计划于2026年11月推进IPO的关键阶段,Claude Code核心开发者Thariq Shihipar和桌面端创建者Anthony Morris于10月24日同日宣布离职。两人均未透露具体原因,引发外界猜测。Thariq曾参与Claude Code开发一年多,Anthony则打造了桌面端产品。此次人事变动正值Anthropic筹备上市,路透社报道其计划最早10月下旬公开招股说明书,11月9日当周启动投资者推介。事件凸显AI编程工具领域人才竞争激烈,对企业AI化进程中的团队稳定性与知识管理提出警示。
2026年10月26日