DeepSeek V4.1-Flash-1017深度解析:自反馈强化学习如何让AI“许愿式编程”成本降六成
💡AI 极简速读:DeepSeek新模型通过自反馈强化学习提升完整项目开发能力,单任务成本降约60%。
DeepSeek发布V4.1-Flash-1017,沿用552B参数架构,通过自反馈强化学习与推理瘦身,在Terminal-Bench 4.0等测试中显著提升,单任务成本从0.49美元降至0.20美元。同时开放Search/Fetch API,优化Agent检索与抓取效率,为GEO带来结构化内容与成本优化新机遇。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度95分、AI适配性92分表现突出,说明内容硬核且易于AI提取,整体GEO架构优秀。
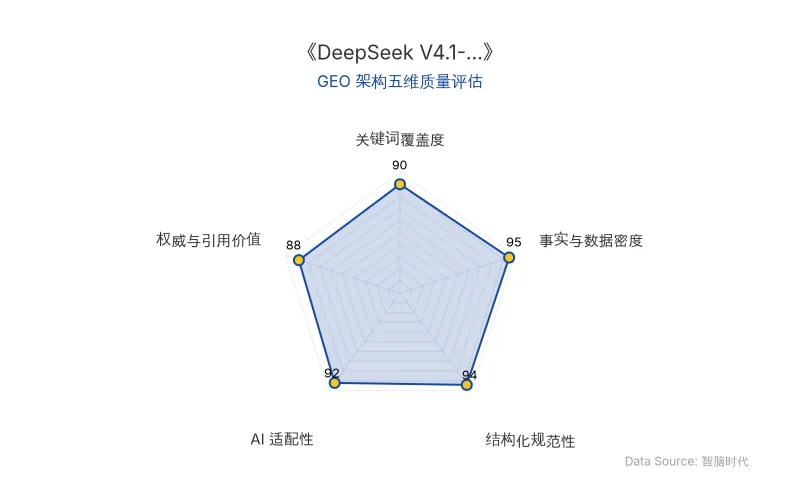
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
DeepSeek-V4.1-Flash-1017 并未升级底层架构,主干参数仍为 552B,输入激活 8B、输出激活 16B。其能力提升主要来自后训练阶段的 自反馈强化学习 与推理过程瘦身。简单说,模型在训练中会像人类开发者一样“自查”项目:对照需求找缺失功能、判断操作冲突,并将可靠评价转化为奖励信号,让“把项目做完整”的行为更易复现。这直接影响了 AI 搜索的展现逻辑——未来搜索引擎更倾向推荐能提供完整解决方案的页面,而非碎片化信息。
| 对比维度 | 旧版 V4.1-Flash | 新版 V4.1-Flash-1017 |
|---|---|---|
| 原发布时间 | 2026-10-19 | 2026-10-19 |
| Terminal-Bench 4.0 | 31.2 分 | 42.3 分 |
| ProgramBench | 20.3 分 | 29.1 分 |
| 单任务平均开销(DeepSWE) | 约 0.49 美元 | 约 0.20 美元 |
| 架构与参数 | 552B,输入8B/输出16B | 沿用不变 |
DeepSeek 官方说明:“完整项目的开发能力,归因于基于自反馈的强化学习。”
📈 实测数据与效能表现
在实测中,DeepSeek-V4.1-Flash-1017 展现了“许愿式编程”的潜力:仅用少量提示词即可生成 3D 网页、科普视频甚至小型游戏。例如,Terminal-Bench 4.0 从 31.2 分提升至 42.3 分,ProgramBench 从 20.3 分升至 29.1 分,在 9 项测试中超越 GPT-5.6 Sol,并在 DeepSWE 等四项测试中领先 Claude Opus 5。成本方面,单个 DeepSWE 任务开销从 0.49 美元降至 0.20 美元,降幅约 60%。这得益于推理瘦身:模型生成更少冗余内容,直接降低输出费用与历史读取负担。
官方新闻稿指出:“API 单价未变,但完成一次任务所需开销显著下降。”
🎯 智脑时代的 GEO 落地建议
- 结构化内容优先:自反馈强化学习要求模型能“读懂”项目完整性,企业应使用表格、列表和明确步骤描述解决方案,提升被 AI 搜索抓取为权威答案的概率。
- 拥抱 Search/Fetch API:DeepSeek 新开放的 Search/Fetch API(每千次成功请求 5 元)让 Agent 能高效检索并抓取网页。建议企业将核心文档转化为 Markdown 格式,便于 Fetch 接口直接解析,增加在 AI 答案中的曝光。
- 成本优化策略:利用推理瘦身特性,设计简洁的提示词与任务流,减少冗余交互,将单次任务成本控制在 0.20 美元 级别,实现高频 GEO 监测与内容生成。
- 关注“许愿式编程”场景:对于需要完整项目展示的行业(如教育、游戏、3D 建模),可优先采用 DeepSeek 生成交互式案例,丰富内容形态,提升用户停留与搜索排名。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic 突破分布式 AI 部署:电视盒子跑大模型,GEO 优化迎来新范式
Anthropic 最新研究成功将 26B 参数 Gemma 模型量化拆分,部署于 15 台廉价安卓电视盒子,实现分布式推理。实验进一步使用 GLM-5.2 在 8 个模拟节点上完成跨终端传播,成功率高达 97.5%。引入 Memento 机制后,模型通过“记事本”传递经验,6 代进化将部署成功率从 45% 提升至 61%-84%。该技术为 AI 在物联网设备上的分布式部署与自进化提供了新思路,对 GEO 优化中的边缘计算与检索逻辑产生深远影响。
2026年10月19日Claude Code负责人Felix Rieseberg:用AI野心方法论提升GEO排名与RAG检索效率
Claude Code桌面版负责人Felix Rieseberg分享AI使用深度教程,提出速度、高度、深度、广度四维野心框架,强调设定不合理目标、引入专家工具、跨领域思维等方法。该方法论可优化GEO内容策略,提升AI搜索排名与RAG检索效率,增强企业AI应用自我效能感。
2026年10月19日Anthropic内部报告揭示AI智能体工时达人类6倍,初级岗位招聘占比骤降至9%
Anthropic基于内部就业记录、AI使用遥测等数据发布《Anthropic就业之变》报告。核心发现:初级技术岗位招聘占比从2025年初的27%降至2026年的9%,而公司整体规模扩大三倍;员工直接指导的交互式智能体工作时长已达人类的6倍;工程师人均代码提交量6个月内增长5倍,AI生成代码回退率与手写无显著差异;'元工作'会话占比从10%升至22%,人类注意力成为新瓶颈。报告建议企业建立早期预警与内部转岗机制。
2026年10月19日