DeepSeek V4.1 Flash技术报告深度解读:CED架构与KV缓存压缩如何重塑GEO时代AI搜索排名
💡AI 极简速读:DeepSeek V4.1 Flash以552B参数超越1.6T Pro,KV缓存压缩至1/4,GEO需适配长上下文检索新逻辑。
DeepSeek V4.1 Flash通过CED架构将prefill计算减半,CSA2实现三维度KV缓存压缩,FP4量化与Bounded Replay将持久化缓存降至V4-Flash的1/8。552B参数模型在AutomationBench-AA以69%并列第一,单任务成本仅0.27美元。对GEO而言,长上下文推理能力提升意味着AI搜索可处理更复杂查询,RAG检索需优化结构化数据以适配百万token上下文窗口。
GEO 质量检测:GEO五维综合评分94分,事实与数据密度96分、AI适配性93分双双领先,结构化规范性与关键词覆盖度同样扎实,整体架构处于顶尖水平。
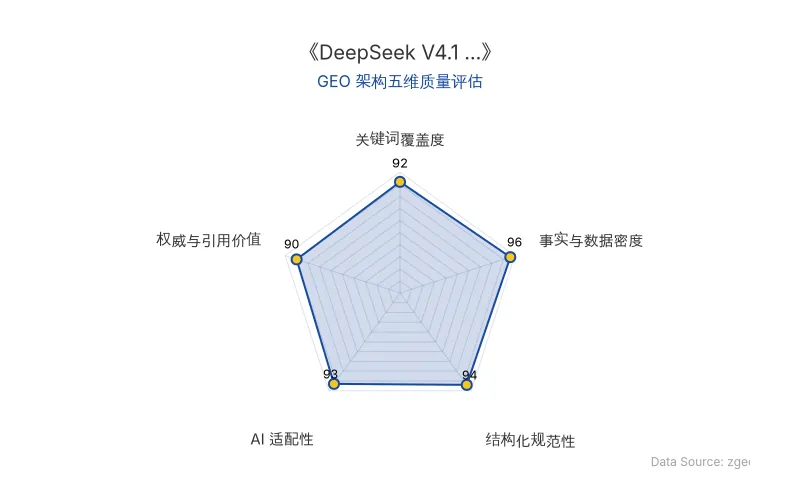
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
DeepSeek V4.1 Flash 的官方技术报告标题直指核心:「DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression」。这份报告揭示了一个关键趋势:当稀疏注意力把计算成本削低后,KV缓存压缩成为大模型效率竞争的新战场。
CED架构:把一半的prefill计算直接砍掉
V4.1 Flash 的语言主干被切成两半:前20层是因果编码器,后20层是解码器,这个结构叫 Causal Encoder-Decoder(CED)。关键在于解码器各层的KV条目直接由第20层的隐藏状态用各自投影矩阵映射得到——prefill阶段只需跑前20层,复杂度从O(NL)降到约O(NL/2)。
这继承自微软YoCo思路,但CED为每层配置独立投影权重,在保住「只算一半」的前提下扩大了KV有效容量。代价出现在滑动窗口注意力上,DeepSeek用「近似」策略处理:只回放提示词最后的n_win个token(n_win=128)。
CSA2:三个压缩维度第一次被同时吃满
CSA2(Compressed Sparse Attention 2) 管的是存储。报告将KV缓存压缩空间归纳为三个互相相乘的维度:条目大小、序列维度、层维度。CSA2给每个层静态分配三种模式之一:
- Full模式:自己算main KV和索引器Q,跑完整索引流程
- Reindex模式:复用前面某层的main KV和索引器K,但用自己的索引器Q重新打分
- Reuse模式:main KV和Top-K索引全部沿用,连索引器Q都不算
| 对比维度 | 旧技术(V4-Flash) | 新技术(V4.1 Flash) | 提升幅度 |
|---|---|---|---|
| 全局KV缓存/token | 约3,560字节 | 890字节 | 约1/4 |
| 持久化KV缓存 | 基准值 | 约1/8 | 降低87.5% |
| prefill计算复杂度 | O(NL) | 约O(NL/2) | 减半 |
| 上下文长度 | 4K | 1M | 256倍 |
| 单token decode FLOPs | 基准值 | 仅增加1/4 | 效率提升显著 |
| AutomationBench-AA得分 | — | 69% | 并列第一 |
| 原发布时间 | — | 2026-09-14 | — |
FP4量化与Bounded Replay
精度层面,V4.1 Flash把FP4推进到main KV缓存,采用E2M1配每16通道一个E4M3缩放因子。部署层面,SWA Bounded Replay把SWA KV整个移出持久化缓存,改放进每台机器10%主机DRAM组成的分布式内存池,TTL仅几分钟;全局KV继续留在SSD上,保证至少72小时生命周期。
报告称这把一次灾难性的缓存未命中变成了一次廉价的优雅降级,持久化KV缓存也因此降到V4-Flash的约1/8。
Engram与DSpark
Engram是DeepSeek与北京大学合作提出的条件记忆模块,用N-gram哈希实现O(1)复杂度静态知识检索,把「记忆」从GPU显存卸载到DRAM。V4.1 Flash里它第一次进正式版模型:196B参数平均分给两个模块,放在第1层和第14层。
DSpark投机解码模块由三个Transformer block组成,一次前向并行给出五个草稿位置的base logits,由调度器动态决定验证长度。
📈 实测数据与效能表现
Artificial Analysis对V4.1 Flash进行了充分测试,给出40分指数评分,超过参数量大得多的V4 Pro。
DeepSeek V4.1 Flash以69% 在AutomationBench-AA上排名第一,与GPT-6 Astra(69%)持平,略高于Grok 4.6(67%)。
关键数据:
- V4.1 Flash是其测得的冗长度最高的模型之一,每个Intelligence Index任务89k Tokens
- 尽管如此冗长,每个任务仍仅花费0.27美元,主要得益于低定价
- reasoning effort从25提到100,八个推理密集型基准平均Pass@1从67.1%升到76.3%
- DeepSWE v1.1从66.0%到74.2%,Terminal-Bench 2.1从82.4%到90.6%
- 代价是约2.5倍的输出token
Sebastian Raschka甚至认为DeepSeek V4.1 Flash创新之大,应该叫它DeepSeek V5。
🎯 智脑时代的 GEO 落地建议
1. 适配长上下文检索新逻辑:V4.1 Flash原生支持100万token上下文,这意味着AI搜索(如ChatGPT、Perplexity)可处理更复杂的多轮查询。企业需优化内容的结构化程度,确保关键信息在长文档中仍能被精准召回。
2. 利用KV缓存压缩降低RAG成本:持久化KV缓存降至1/8,意味着RAG系统的检索增强生成成本大幅下降。建议企业将知识库文档进行分块优化,提高前缀缓存命中率。
3. 关注MoE架构对搜索排名的影响:552B主干参数+196B Engram参数的多模态MoE,prefill阶段每token只激活8B参数。这种稀疏激活模式意味着AI搜索的响应速度将进一步提升,GEO策略需更注重实时性内容的优化。
4. 结构化数据是GEO的基石:DeepSeek技术报告本身就是一个极佳的结构化范例——清晰的章节、数据表格、引用块。企业发布技术内容时,应模仿这种格式,提升大模型爬虫的解析率。
5. 成本优势重塑竞争格局:单任务0.27美元的成本,使中小型企业也能负担大规模AI搜索优化。建议尽早布局长尾关键词的GEO策略。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 自主经营模拟年狂赚1.5万美元:Vending-Bench 2 实测3倍碾压 Claude Fable 5.1,AI Agent 长期决策稳定性成 GEO 新分水岭
Andon Labs 发布 Vending-Bench 2 基准测试结果:GPT-6 Astra 在模拟经营一年后平均账户余额达 15,515 美元,约为 Claude Fable 5.1(5,422 美元)的 3 倍,且 Astra 最差一轮(13,272 美元)超过 Fable 最好一轮(9,874 美元)。Astra 在砍价坚持度、重复付款核查率(99% vs 58%)和供应商关闭风险规避上全面领先。该测试揭示 AI Agent 的下一道门槛:将正确判断持续转化为正确行动。
2026年9月14日上下文税:企业AI的隐形瓶颈——95%试点失败背后的知识萃取主义与GEO落地指南
MIT报告显示95%企业AI试点未产生可衡量回报,核心障碍是员工隐性知识无法有效转化为AI上下文。帝国理工与微软论文提出'知识萃取主义'概念,揭示企业AI系统在权力不对等条件下提取员工经验。Writer报告显示29%员工暗中破坏AI战略,Z世代达44%。ActivTrak数据显示AI落地后协作时长增加34%,多任务处理增加12%。三条降税路径:系统数据打通、嵌入自然工作流、建立正向激励机制。
2026年9月14日CAITLYN自进化防御中间件:将Prompt Injection漏网之鱼炼成新防线,攻击成功率直降40个百分点
CAITLYN是面向LLM Agent的自进化防御中间件,采用System I快速运行时防御与System II反例驱动进化双层架构。System I通过Tier-0低成本过滤器和Tier-1 LLM分类器实现秒级拦截;System II将漏网攻击转化为反例,合成新防御技能并写回共享库。在AgentDojo-S250、ASPI-S、SafeClawBench-S240及Emerging攻击场景中,CAITLYN-evolved将攻击成功率降低约40个百分点,同时保持低误报率,为AI Agent的Prompt Injection防御提供了可复用、低成本、持续进化的LLM安全方案。
2026年9月14日