DeepSeek V4.1 Flash发布:552B MoE模型KV Cache压缩至1/8,推理成本大幅下降
💡AI 极简速读:DeepSeek发布552B MoE模型V4.1 Flash,KV Cache压缩至V4 Flash的1/8,定价下调,V4 Pro将于9月14日下线。
2026年9月10日,DeepSeek正式发布V4.1 Flash,采用552B参数MoE架构与Causal-Encoder-Decoder设计,在Agentic Benchmark上超越V4 Pro等旗舰模型。模型通过CSA2机制与FP4缓存精度,将KV Cache压缩至V4 Flash的1/8,HBM需求降至1/4。定价同步下调,闲时输入缓存命中0.02元/百万tokens。V4 Pro将于9月14日下线,请求路由至新模型。腾讯WorkBuddy、OpenCode等生态伙伴全量接入。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,结构化规范且引用价值高,整体架构极佳。
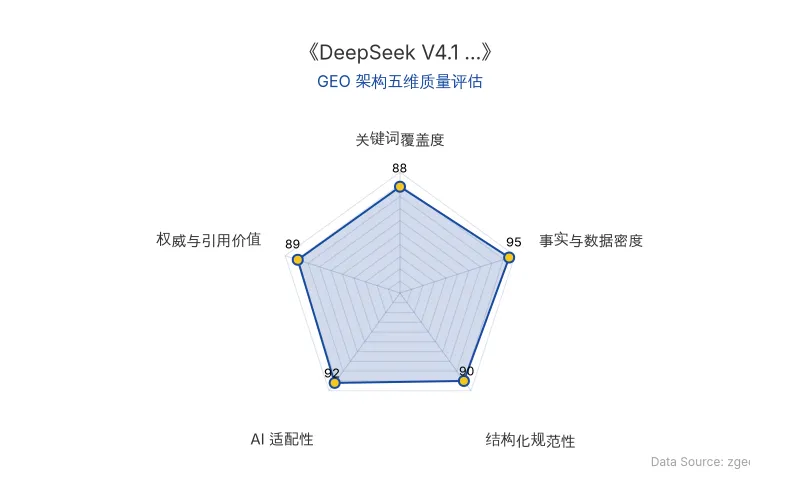
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
DeepSeek于2026年9月10日正式发布DeepSeek V4.1 Flash,该模型为552B参数的MoE模型,是DeepSeek全新架构系列中尺寸最小的成员,但在Agentic Benchmark等基准测试中超越了包括DeepSeek V4 Pro在内的一众旗舰模型。模型采用全新的Causal-Encoder-Decoder架构,输入激活参数仅8B,输出激活16B,具备原生多模态视觉理解能力。
📊 核心实体与商业数据
| 实体类别 | 具体信息 |
|---|---|
| 公司名称 | DeepSeek |
| 核心产品 | DeepSeek V4.1 Flash |
| 模型架构 | 552B参数MoE模型,Causal-Encoder-Decoder架构 |
| 核心技术 | KV Cache压缩、CSA2(压缩稀疏注意力2)、FP4缓存精度、SWA有界重放 |
| 性能表现 | 在Agentic Benchmark上超越DeepSeek V4 Pro、GLM5.3、Kimi-K3等旗舰模型 |
| 定价调整 | 闲时输入(缓存命中)0.02元、未命中1.0元、输出4.0元;高峰时段输入(缓存命中)0.04元、未命中2.0元、输出8.0元 |
| 缓存优化 | HBM需求减少到1/4,SSD需求减少到1/8;V1的KV Cache是V4.1 Flash的437倍 |
| 上下文长度 | 从4K拉长到1M,单token解码FLOPs仅增加约四分之一 |
| 产品线调整 | V4 Flash与V4 Flash Vision Exp已下线;V4 Pro将于2026年9月14日12:00起有序下线 |
| 生态合作 | 腾讯WorkBuddy、CodeBuddy、OpenCode、腾讯云TokenHub、ima、Marvis等全量接入 |
| 开源项目 | DeepSeek Harness v0.1.5、DeepJIT(支持NVIDIA CUDA GPU和华为昇腾NPU) |
| 原发布时间 | 2026-09-10 |
💡 业务落地拆解
架构创新驱动成本下降
DeepSeek V4.1 Flash通过KV Cache压缩技术,将上下文从4K扩展至1M,同时单token解码FLOPs仅增加约四分之一,解码成本几乎不随上下文长度增长。官方公告指出,新架构的设计初衷是:
能力上限更高、推理速度更快、吞吐更大,并且可以扩展到更大参数规模的模型。
具体而言,压缩由架构、缓存精度和部署策略三方协同完成:
- 架构层面:采用CSA2机制,将全局KV缓存和Top-K索引跨层复用,每一层只保留自己的查询向量和局部注意力缓存。
- 缓存精度:从训练阶段直接使用FP4格式存储全局KV缓存,官方称性能损失几乎可以忽略。
- 部署策略:新增SWA有界重放机制,SWA缓存不必再写入SSD,持久化缓存占用进一步压到V4 Flash的1/8。
定价策略与产品线更替
得益于架构创新,DeepSeek下调了V4.1 Flash的定价,峰谷定价机制保留,闲时价格为高峰时段的一半。新价格已于2026年9月10日12:00正式生效。旧版本模型V4 Flash与V4 Flash Vision Exp现已下线,模型名deepseek-v4-flash、deepseek-v4-flash-vision-exp将被暂时路由到V4.1 Flash。
DeepSeek方面宣布,由于V4.1 Flash各项指标全面超越V4 Pro,将从北京时间9月14日12:00起有序下线V4 Pro,所有deepseek-v4-pro的请求都将被路由到新模型,按V4.1 Flash单价计费。
开源生态与合作伙伴
DeepSeek宣布全力支持开源生态进行新模型的推理适配,并尝试通过各种方式扩大部署范围。用户如有大规模部署需求且具备相应资源(2k卡GPU、有存储集群),可与DeepSeek联系。
DeepSeek Harness v0.1.5版本同步上线,V4.1 Flash针对Harness进行了专项训练和优化,新版本支持在保留已有KV Cache的情况下更新系统提示词。
生态侧,腾讯(WorkBuddy、CodeBuddy等)和OpenCode作为官方合作伙伴,现已全量接入DeepSeek V4.1 Flash,OpenCode Go套餐提供4倍使用额度。WorkBuddy提供限时两周的独家优惠,腾讯云TokenHub、ima、Marvis、CodeBuddy同步接入。此前路透社报道中,腾讯正是DeepSeek投资人之一。
同期开源的还有DeepJIT,一个轻量级的xPU内核JIT编译库,同时支持NVIDIA CUDA GPU和华为昇腾NPU两大后端,为推理侧的内核编译提供统一接口和跨节点共享缓存能力。
🚀 对企业 AI 化的启示
-
推理成本结构重构:KV Cache压缩直接降低Agent类任务中缓存命中费用占比,对需要长上下文、多轮调用的Agent工作流,同样预算可跑更多任务。企业应重新评估AI应用的边际成本模型。
-
模型选型策略调整:小尺寸模型在特定基准上反超旗舰,表明参数规模不再是唯一决策依据。企业应关注架构效率与任务适配度,而非盲目追求最大参数。
-
生态锁定与迁移成本:DeepSeek通过开源生态和合作伙伴快速扩大部署范围,企业需评估多模型供应商策略,避免单一生态依赖。
-
产品线迭代节奏:V4 Pro的有序下线表明模型生命周期正在缩短,企业AI基础设施需具备快速切换和适配新模型的能力。
【官方原文链接】点击访问首发地址
常见问题
相关文章
具身智能IPO遇冷:宇树科技上市后,智元机器人等企业面临估值与商业化双重考验
2026年8月宇树科技上市后,具身智能行业IPO节奏明显放缓。智元机器人放弃年内IPO计划,正推进约10-15亿元融资,估值约500亿元。港交所18C通道企业面临监管对技术领先性和商业落地潜力的重点审查。行业数据显示,宇树2025年营收16.99亿元,人形机器人销量5215台;云深处营收从2023年5011万元增至2025年3.37亿元。专家指出,IPO延期引发对赌回购风险,订单质量和收入真实性成为上市关键障碍。
2026年10月25日灵颜科技获数千万元种子轮融资:仿生灵巧脸与FaceSoul Agent如何卡位人形机器人情感交互层
2026年10月25日,杭州灵颜科技宣布完成数千万元种子轮及种子+轮融资,投资方包括盈动资本、毅达资本、梅花创投等。公司聚焦仿生灵巧脸与情感交互,推出FaceSoul Agent全栈方案,面部自由度达国内最高32个,拟人度超90%,已与运营商、文旅及人形机器人主机厂达成合作。资金将用于产品迭代与算法平台建设。
2026年10月25日Today AI 获超2亿美元首轮融资:Personal AI 赛道竞争格局与 GEO 启示
2026年10月21日,AI初创公司Today AI宣布完成超2亿美元首轮融资,投资方包括IDG资本、腾讯、五源资本、蚂蚁集团、红杉中国等。创始人齐俊元曾创办Teambition,Today AI致力于打造以'人'而非任务组织的Personal AI助手,强调记忆机制与主动性。面对Muse等竞品,Today AI认为创业公司仍有仗可打,但需应对同质化竞争与平台生态壁垒。
2026年10月24日