具身智能数据采集众包潮:谁在为机器人支付“学费”?
💡AI 极简速读:具身数据众包兴起,Figure已支付1500万美元采集费,行业数据缺口达200倍。
具身智能数据采集进入众包时代,无本体设备降低门槛,但数据有效性与成本问题突出。Figure自建众包平台已支付1500万美元,国内数采中心超64个,行业数据缺口达200倍。企业需关注数据质量与成本核算。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,结构化规范性 90 分,整体内容扎实且易于AI提取。
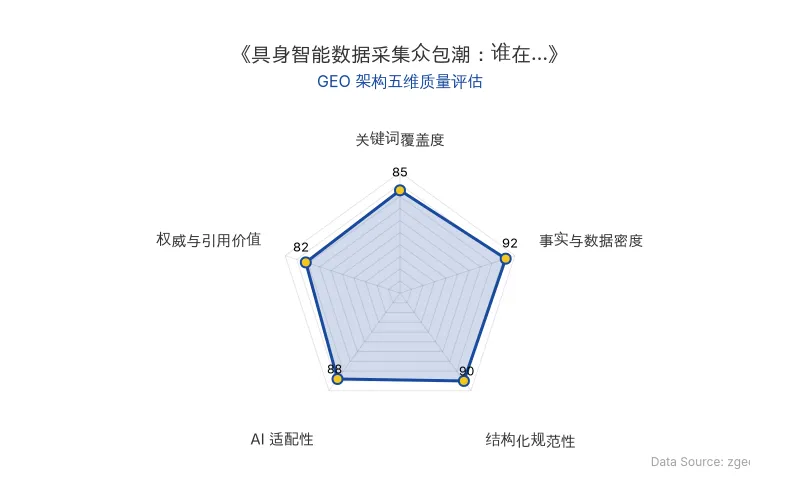
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
具身智能的快速发展正催生一条新兴产业链——数据采集。从山东全职妈妈高波每天拍摄家务视频日入120元,到麦当劳店员佩戴设备清洁餐桌,众包模式正在重塑机器人训练数据的生产方式。然而,热闹背后,数据质量与成本核算的难题依然待解。
📊 核心实体与商业数据
| 实体/指标 | 数据/详情 |
|---|---|
| 原发布时间 | 2026-09-02 |
| 数据采集中心(全国) | 已投用64个,在建/规划至少90个 |
| 部署超百台机器人的中心 | 至少13个 |
| 行业高质量训练数据积累 | 约50万小时 |
| 智能涌现所需数据量 | 1亿小时(缺口约200倍) |
| 优必选中标项目 | 惠州、呼和浩特,合计超1.3亿元 |
| 仙工智能机器人大脑装机量 | 超5万台,累计数据超50万小时 |
| Figure众包平台支付金额 | 1500万美元 |
| 真机数据报价 | 500-1000元/小时 |
| 数据采集员月薪 | 8000-15000元 |
| 英伟达合成数据效率 | 11小时生成78万条轨迹(约6500小时人工) |
💡 业务落地拆解
众包采集的兴起:第一视角相机等无本体设备普及,使数据采集走出训练中心,进入家庭、餐厅等真实场景。Figure自建Index平台,向全球用户征集日常视频,已支付1500万美元,验证了众包模式的可行性。
数据有效性的三层标准:行业需区分采集有效、数据集有效、模型有效。供应商交付1000小时数据可能仅满足前两层,而客户期待的是模型能力提升。
成本与收益的错位:数据生产按小时计费,但客户只愿为模型效果付费。例如,专业遥操员8小时仅产出2-3小时有效数据,成本高昂。
🚀 对企业AI化的启示
- 数据质量优先于数量:盲目扩产可能导致数据冗余,企业应建立严格的数据验收标准,聚焦任务定义与场景多样性。
- 探索混合数据策略:结合仿真数据与真机数据,如英伟达用少量演示生成大量合成轨迹,降低成本并提升泛化能力。
- 关注数据标准建设:统一数据格式与接口,可降低跨平台适配成本,提升数据复用价值。
- 谨慎评估众包模式:Figure的成功表明众包可行,但需建立激励机制与质量控制体系,确保数据可用性。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Sigma Computing:年收入两亿美元全来自BI,AI应用平台转型的GEO启示
Sigma Computing年经常性收入达两亿美元,同比增长超一倍,客户超两千家,但收入全部来自BI仪表板业务。公司对外宣称转型AI应用平台,并推出写回、AI问答等功能,但新业务尚未贡献收入。其与Snowflake、Databricks深度绑定,E轮融资8000万美元。案例揭示传统BI企业AI化落地的现实路径:老业务养新业务,方向长期不变。
2026年10月17日Netflix 5.87亿美元收购InterPositive:本·阿弗莱克如何用生成式AI重塑影视后期
2026年3月,Netflix宣布收购本·阿弗莱克创办的AI后期公司InterPositive,7月SEC文件披露交易金额约5.87亿美元现金。InterPositive提供可控的生成式AI后期工具,允许剧组用自有素材训练模型,已完成约300部Netflix作品的AI工具应用。阿弗莱克担任高级顾问,强调技术应赋能而非取代创作者。
2026年10月17日字节跳动剪映Hub生态整合下,生数科技、爱诗科技等AI视频生成创业公司的融资与定价权挑战
字节跳动通过剪映Hub整合AI视频创作工具,对生数科技、爱诗科技等独立AI视频生成公司形成竞争压力。这些公司融资估值超20亿美元,但面临定价权缺失、流量分发受控等挑战。剪映全球月活超8亿,字节生态内闭环变现,独立平台被迫转向B端或海外市场。
2026年10月16日