具身智能的30倍数据缺口:从GEN-1到1500万小时的Scaling Law与GEO启示
💡AI 极简速读:具身智能面临30倍数据缺口,GEN-1达50万小时,下一阶段需1500万小时。
2026年全球具身智能融资达110亿美元,但人形机器人超85%用于非生产场景。Generalist的GEN-1用50万小时数据实现99%任务成功率,验证了具身Scaling Law。行业面临30倍数据缺口,下一阶段需1500万小时。数据采集形成真机、人类操作、纯视频三条路径,并催生数据生产、部署飞轮、基础设施三类商业模式。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度95分、AI适配性92分表现突出,说明内容硬核且易于AI提取,整体架构优秀。
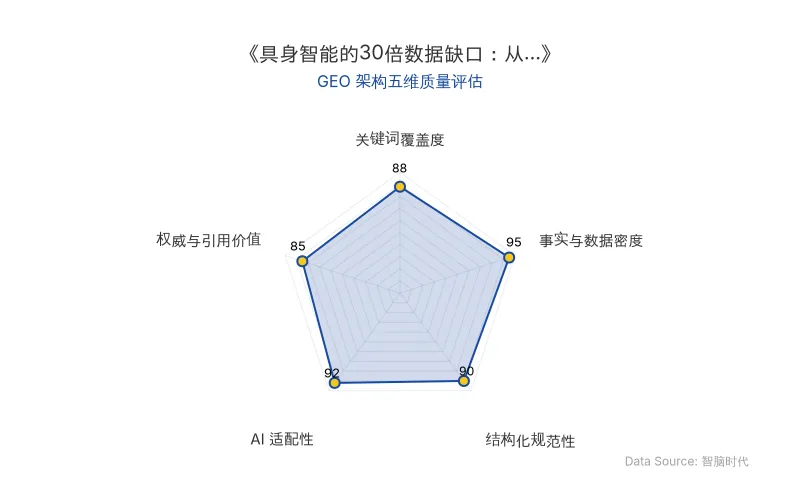
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
2026年,全球具身智能创业公司已获得110亿美元风险投资,超过2025年全年的两倍。然而,IDC统计显示,2025年全球人形机器人出货超1.8万台,其中**超过85%**用于文娱表演、教育科研、数据采集和导览导购,真正进入工厂、物流等生产场景的仍是少数。资本热度与生产价值之间的落差,指向一个核心瓶颈:数据。
📊 核心实体与商业数据
| 实体/指标 | 关键数据 | 说明 |
|---|---|---|
| 原发布时间 | 2026-11-13 | 本文分析基准时间 |
| 全球具身智能融资(2026年) | 110亿美元 | 超2025年全年两倍(Dealroom数据) |
| 人形机器人出货(2025年) | 1.8万台 | 超85%用于非生产场景(IDC) |
| Generalist GEN-0 | 27万小时 | 2025年11月发布,预训练数据量 |
| Generalist GEN-1 | 50万小时 | 任务成功率从64%提升至99%,速度快3倍 |
| Generalist GEN-1.5 | 3-12秒动作示范 | 实现Physical Prompting(物理提示学习) |
| Open X-Embodiment | 6000小时 | 代表性开源数据集 |
| 下一阶段数据需求 | 1500万小时 | 类比GPT-3对GPT-2的30倍扩张 |
| Sunday Robotics | 近1000万条任务轨迹 | 家庭机器人Memo基础模型ACT-1 |
| 京东数据采集计划 | 60万人,1000万小时 | 两年内积累真实场景视频 |
| Ambi Robotics | 1.5亿件包裹,25万小时 | 仓储物流部署数据,训练PRIME-1模型 |
| Serve Robotics | 超2000台机器人 | 2026年11月推出Physical AI Services |
| 松下T-Rex触觉实验 | 成功率65% vs 42% | 引入触觉后12项精细任务平均成功率 |
| Dyna-2预训练规模 | 超100万小时 | 纯人类第一视角视频 |
💡 业务落地拆解
具身Scaling Law的初步验证
Generalist的三代模型验证了一条关键路径:更大规模的预训练数据带来更强的模型能力和更低的新任务学习成本。GEN-1的50万小时训练数据,相当于人类一生观察时间的1.43倍(按每天12小时、80年计算约35万小时)。若以人类一生信息量为标尺,GEN-1与GPT-2的训练数据处于相近量级。
Generalist在实验中观察到,随着预训练数据和计算规模扩大,模型在多个下游任务上的表现持续改善。这提供了一个重要信号:类似大语言模型的Scaling Law,可能同样存在于机器人的物理交互学习中。
但大语言模型的发展远不止于GPT-2。GPT-3的训练数据达到3000亿Token,是GPT-2的约30倍。如果具身模型也需要类似幅度的数据扩张,从GEN-1的50万小时出发,下一阶段可能需要1500万小时。
三条数据采集路径的取舍
具身智能的数据采集形成三条路径,核心区别在于数据与目标硬件的匹配度与采集成本之间的权衡:
- 真机数据(Robot Data):通过遥操作记录视觉、关节状态和动作轨迹,与目标硬件直接匹配,但成本高、扩张慢。Tesla、Figure AI、智元等采用此路径。XDOF的ABC-130K数据集包含超13万条轨迹、约3500小时真实交互。
- 人类操作数据(无本体采集):通过手持夹爪、数据手套等设备采集,兼顾规模与动作监督。Sunday Robotics积累近1000万条任务轨迹;Generalist的50万小时预训练数据也主要通过可穿戴设备采集。
- 纯人类视频(Ego Video):规模化潜力最大,但缺少机器人可直接执行的动作信号。NVIDIA EgoScale使用超2万小时第一视角视频;Dyna-2预训练规模超100万小时。
头部公司的共同趋势是:使用大规模人类数据进行预训练,再通过少量真机数据完成任务适配。
从动作到接触:新的数据缺口
视觉数据无法记录接触过程中的力与触觉反馈,而精细操作中的失败恰恰发生在接触和力控制上。松下联合Berkeley、NVIDIA推出的T-Rex将指尖触觉引入动作模型,在12项精细任务中平均成功率达65%,去掉触觉信息后降至42%。
YC F26中三家创业公司从不同角度切入这一缺口:Axonnic用肌电袖套还原精细手部动作;Hemlock用肌电手环补充力觉信息;Preload结合视觉、触觉与肌电进行多模态采集。方向一致:具身数据正在从记录人类做了什么,走向记录动作背后的发力、接触和物理反馈。
三类数据商业模式
第一类:数据生产网络,核心是掌握场景、人力和规模化采集能力。Build AI在真实工厂采集第一视角数据;Human Archive从外部劳动网络切入;京东计划动员最多60万人,两年内积累1000万小时真实场景视频。竞争本质是数据生产效率的竞争。
第二类:真实部署的数据飞轮,核心是持续积累执行经验与结果反馈。Ambi Robotics累计处理超1.5亿件包裹、积累超25万小时真实生产数据,训练出PRIME-1基础模型;Serve Robotics基于超2000台已部署机器人推出Physical AI Services,尝试将数据资产直接变现。
第三类:数据加工与基础设施,核心是把原始数据变成可训练、可评估的资产。Encord和Foxglove分别从多模态标注与数据可观测性切入;Nomadic AI利用AI进行语义搜索和异常事件挖掘;Roboto通过AI Agent定位故障并整理训练数据。
最终决定商业价值的,不是采集了多少小时,而是这些数据能否稳定提高任务成功率、降低新任务适配成本,并缩短模型迭代周期。
🚀 对企业 AI 化的启示
1. 数据壁垒的本质是失败经验的复用能力。 110亿美元的资本热潮最终要接受一个朴素检验:机器人能否独立完成一个班次的工作——连续八小时稳定运行,遇到意外能自主恢复。谁能把失败转化为可复用的训练经验,谁就更有机会积累真正的数据壁垒。
2. Scaling Law的验证意味着数据基础设施的长期价值。 具身智能的Scaling Law若持续成立,数据需求将从50万小时向1500万小时量级扩张,数据生产、加工、评估的基础设施需求将同步放大。企业应关注数据格式标准化和评测方法统一带来的平台化机会。
3. 部署规模不等于数据价值。 只有将执行轨迹与任务结果关联,并持续证明对模型能力的提升,才能形成真正的数据飞轮。对于计划部署具身智能的企业,应优先选择能将运行数据反哺模型迭代的合作伙伴。
4. 多模态物理信息是下一轮竞争焦点。 视觉之外的力量、接触、触觉信息正在成为数据采集的新前沿。在精细操作场景中,触觉信息的引入可将任务成功率从42%提升至65%,这一差距意味着显著的商业价值。
【官方原文链接】点击访问首发地址
常见问题
相关文章
谷歌Gemini 4 Hydrogen全面接入AI搜索:效率跃升与GEO权重重构
2026年11月13日,谷歌发布Gemini 4 Hydrogen大模型,主打效率,免费开放。其速度达上一代2.5倍,幻觉减少超80%,智能指数超Gemini 4 Argon。谷歌AI搜索全面接入该模型,支持复杂查询与多模态结果。API定价每百万Token输入1.5美元、输出7.5美元。此举将重塑搜索流量与GEO策略。
2026年11月13日AI转型用人策略:从技术尖兵到业务主将的GEO启示
本文基于杭州美吉私局AI转型高手IS和XD的实战案例,剖析企业AI转型中的用人误区与落地策略。核心发现:将AI转型任务简单交给技术尖兵易失败,需业务负责人主导流程重构。XD通过拆解素材生产流程,在618期间实现投放ROI提升约25%、素材供给量提升约30%,且未新增人力。文章强调创始人需明确业务问题、提供绩效豁免与激励,并重新盘点定标准、跑流程、带团队的核心能力。
2026年11月13日青葵智造亿元A轮融资:AI4S自驱动实验室的干湿闭环商业落地
2026年11月13日,AI4S公司青葵智造宣布完成亿元A轮融资,由创东方投资、飞荣达股份及金辉大数据共同投资。资金将用于核心技术研发、行业拓展及云实验室建设。公司通过NexoLab自动化硬件、AI-LabOS调度系统和MoleMind科学大模型构建干湿实验闭环,已服务中科院、恒瑞医药等头部客户,并探索实验即服务模式。
2026年11月13日