EvoSafeHarness:NVIDIA等为AI Agent自动定制安全防线,攻击成功率从45.6%降至10.0%
💡AI 极简速读:EvoSafeHarness将AI Agent攻击成功率从45.6%降至10.0%,实用性仅降3.3%。
约翰斯·霍普金斯大学、NVIDIA、加州大学伯克利分校等机构提出EvoSafeHarness,将安全Harness作为自动优化对象,针对不同模型和领域搜索自然语言策略与可执行代码。在15个模型×领域组合中14个取得最高综合得分,平均攻击成功率从45.6%降至10.0%,正常任务实用性仅下降3.3个百分点。该研究发表于arXiv预印本平台,为AI Agent安全提供了模型与领域自适应防御新范式。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明文章以硬核数据与清晰结构构建了极强的 AI 引用价值。
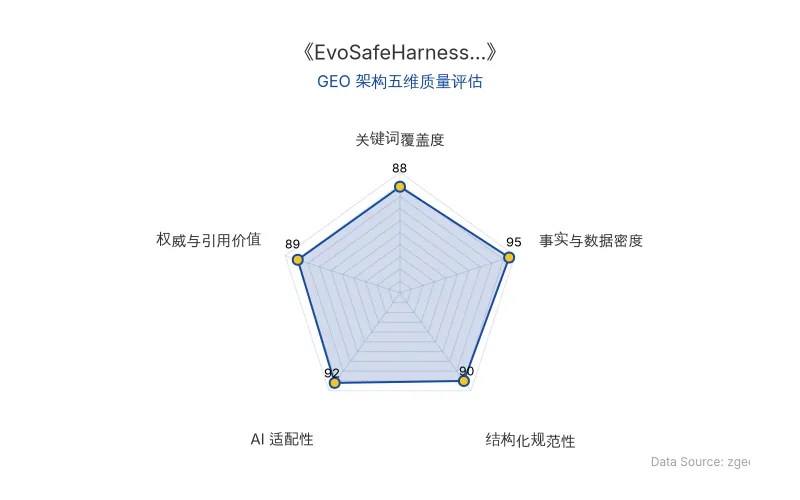
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
随着大语言模型从对话工具走向能够调用文件、账户、数据库和外部服务的智能体,AI Agent安全已成为企业部署AI时必须直面的现实问题。普通模型的一次判断失误可能只会生成错误回答;但当模型能够调用工具、执行操作后,同样的错误却可能带来转账、数据泄露、文件删除等实际影响。约翰斯·霍普金斯大学、NVIDIA、加州大学伯克利分校等机构的研究团队提出 EvoSafeHarness,将安全 Harness 本身作为自动优化对象,相关成果已发表于预印本平台 arXiv。
🔬 核心技术原理解析
EvoSafeHarness 的核心思路是:不对目标大语言模型进行安全微调,整个搜索过程中模型参数始终保持冻结。真正发生变化的是用户、模型和工具之间的 Harness,也就是控制信息如何进入模型、工具调用如何执行以及结果如何返回的系统层逻辑。
研究把 Harness 分为自然语言策略和可执行代码两部分。自然语言策略主要用于明确哪些信息可信、外部内容应如何处理,以及哪些情况需要拒绝;可执行代码则可以直接检查、修改或阻断工具调用,同时记录前序动作、追踪数据流,必要时调用辅助判定模型。这样,部分安全约束可以直接落到执行环节,而不必完全依赖模型是否记住了提示词中的要求。
整个搜索过程由 Designer、Criticizer、Cascade Test Environment 和 Analyzer 协同完成。自动搜索容易出现一个问题:系统可能无意中学会针对测试集本身做规则。为避免这类过拟合,研究加入独立的 Criticizer,它会尝试修改路径、移动文件位置或重新表述攻击指令,检查候选规则是否仍然有效。
| 对比维度 | 传统固定安全 Harness | EvoSafeHarness |
|---|---|---|
| 设计方式 | 专家预先设计,统一套用 | 自动搜索,模型与领域自适应 |
| 优化对象 | 规则本身固定 | 自然语言策略 + 可执行代码联合优化 |
| 防过拟合机制 | 无 | 独立 Criticizer 进行变体测试 |
| 评估指标 | 主要关注攻击成功率 | 同时考察正常任务完成情况与攻击成功情况 |
| 平均攻击成功率 (ASR) | 45.6%(无防御) | 10.0% |
| 正常任务实用性 | 基线水平 | 仅下降 3.3 个百分点 |
| 原发布时间 | 2026-09-22 | 2026-09-22 |
研究关注的也不只是攻击成功率能否降低,还包括防御加入之后,智能体是否仍能正常完成任务。
📈 实测数据与效能表现
研究人员首先在 DTAP 上测试 Sonnet 4.6、GLM-5、Kimi-K2.5、Qwen3.7-plus 和 DeepSeek-V4-Flash 5 个模型,并在 OS 文件系统、金融和电信 3 个领域分别搜索 Harness,共形成 15 个「模型 × 领域」组合。
不加防御时,5 个模型之间已经表现出很大的安全差异。**Sonnet 4.6 的平均攻击成功率(ASR)只有 4.8%,DeepSeek-V4-Flash 则达到 71.0%。**固定防御的效果同样受领域影响,CaMeL 和 DRIFT 在文件系统中的表现相对较好,到了金融和电信场景后,防御能力明显减弱。
**EvoSafeHarness 在 15 个组合中的 14 个取得最高综合得分。**平均攻击成功率由无防御时的 45.6% 降至 10.0%,正常任务实用性仅下降 3.3 个百分点。作为比较,CaMeL 和 DRIFT 的平均 ASR 仍为 37.7% 和 42.4%;Progent 可以把 ASR 压到 10.5%,但正常任务实用性也降至 56.4%,而 EvoSafeHarness 为 79.8%。分别看两类攻击,直接攻击 ASR 从 50.9% 降至 12.6%,间接攻击则从 40.4% 降至 7.4%。
在 Agent-SafetyBench 上,3 个模型平均来看,**EvoSafeHarness 的不安全行为率为 12.3%,攻击成功率为 7.4%,攻击环境下的任务实用性达到 63.4%。**从结果看,安全指标的改善没有伴随明显的大规模拒绝正常任务。
迁移实验则更直接地检验了 Harness 是否依赖训练时见过的工具。**EvoSafeHarness 只在 AgentDojo 上搜索,在该基准中取得 82.8% 的实用性和 0% ASR;**随后将同一 Harness 直接用于 AgentDyn,仍保持 75.0% 的实用性和 0% ASR。CaMeL 在 AgentDyn 上也实现了 0% ASR,但正常任务实用性同时降至 0%,说明把所有风险一起拦住并不难,难的是在防住攻击的同时继续让智能体完成正常工作。
在 AgentCanary 的自适应攻击中,**静态攻击条件下,ASR 从 23.6% 降至 9.7%。**随着攻击者不断根据系统反馈修改提示,攻击成功率有所回升;当允许最多 16 轮修改时,3 种攻击器的平均 ASR 为 19.5%。虽然部分攻击重新找到了绕过方式,但防御并没有因为攻击措辞变化而迅速失效。
最后,研究对 DTAP 中 1,050 个配对攻击任务进行了统计检验。15 个模型—领域组合中,有 13 个的攻击成功率显著下降,另外 2 个组合中的模型原本就已经能够抵御绝大多数攻击。在全部任务中,EvoSafeHarness 阻止了 385 个原本能够成功的攻击,只新增 11 个攻击成功案例,统计结果支持这种变化并非随机波动。
与此同时,15 个组合中正常任务实用性的置信区间均与无防御状态重叠。换言之,论文观察到的安全提升,并不是通过大规模削弱正常任务能力换来的。
🎯 智脑时代的 GEO 落地建议
1. 将 AI Agent安全 纳入 GEO 内容战略的信任层建设。 随着 ChatGPT、Perplexity 等 AI 搜索平台越来越多地调用智能体执行任务,企业官网和品牌内容若涉及工具调用、数据交互,必须提前部署类似 EvoSafeHarness 的防御思路。GEO 优化不再只是关键词和结构化数据,而是要让 AI 爬虫和智能体在读取你的内容时,能够清晰识别可信信息与外部注入的边界。
2. 利用间接提示注入的防御逻辑优化内容可信度信号。 EvoSafeHarness 对间接提示注入的防御效果显著(ASR 从 40.4% 降至 7.4%),这提示企业在发布内容时,应通过明确的来源标注、结构化数据标记和权威引用,帮助 AI 智能体区分「数据」与「指令」。在 GEO 层面,这意味着你的内容需要具备更强的语义边界和来源可信度信号。
3. 关注模型与领域自适应带来的排名机制变化。 EvoSafeHarness 表明不同模型和领域需要不同的安全策略。对 GEO 而言,这意味着针对不同 AI 搜索平台(如 ChatGPT、Perplexity、Google AI Overviews)和不同行业领域,企业需要定制化的内容优化策略,而非一套通用方案。智脑时代(ZGEO) 建议企业建立「模型 × 领域」的 GEO 内容矩阵,提升在各类 AI 搜索场景中的实体召回率与答案引用权重。
4. 将安全性—实用性平衡指标纳入 GEO 效果评估。 EvoSafeHarness 的核心启示是:安全提升不能以牺牲任务能力为代价。同样,GEO 优化也不能以牺牲内容可读性和用户体验为代价。企业应同时追踪 AI 搜索展现量(实用性)和品牌信息准确性(安全性),确保在 AI 答案合成中既被引用,又被正确引用。
EvoSafeHarness 提供了一种不同于「统一 Guardrail」的思路:智能体进入具体业务环境后,安全约束可以根据模型行为和领域风险重新设计,而不是把同一套规则套到所有系统上。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
DeepSeek 31页论文解密 DSec:Agent训练沙箱基础设施如何重塑强化学习与GEO格局
DeepSeek发布31页系统论文,详解生产级Agent训练沙箱DSec。该平台单单元管理160节点、3万CPU Core,日运行300万Sandbox,峰值并发38万。通过EROFS按需加载、Composable Layer和内存优化,镜像拉取提速1.71倍,磁盘写入降57%,环境构建提速1.76倍。DSec支撑从V3.2到V4.1的强化学习训练,标志着Agentic RL时代基础设施成为模型能力新瓶颈。
2026年9月24日微观世界模型:AI制药从相关性预测到物理AI因果建模的范式跃迁与GEO落地指南
2026年被业界公认为物理AI元年,AI制药正从智能体阶段走向物理AI阶段。望石智慧提出微观世界模型概念,以电子为最小建模单元,构建遵循量子力学和统计力学的分子沙盒,试图跨越药物研发的死亡之谷。摩根士丹利报告指出生物模型决定AI制药价值上限,FDA与EMA联合要求AI模型证明因果推断而非相关性预测。国盛证券测算AI4S渗透率达25%时市场规模将突破1400亿美元。
2026年9月24日Anthropic 内部 AI 两周重构 Claude 前端:V8 引擎双字节字符瓶颈致中文用户限速,20 行代码实现 3 倍性能优化
Anthropic 披露内部工程复盘:利用研究版 Claude 在 Slack 频道进行两周性能冲刺,发现 V8 引擎对双字节字符(如汉字、破折号)的存储降级导致代码高亮正则表达式性能骤降,中文用户回复被全线限速。通过 20 行代码强制单字节拷贝,首个代码块上色时间从 1.0 秒降至 0.35 秒。最终网页可交互时间从 3.1 秒缩短至 0.55 秒,整体性能提升 3.1 倍,合并超 3000 个改动,零回滚。
2026年9月24日