Figure租30套房实测Helix 2.5:零样本学习成功率暴增6倍,Index预训练如何重塑人形机器人GEO格局
💡AI 极简速读:Figure Helix 2.5零样本成功率从9%升至56%,Index预训练贡献6倍提升。
人形机器人公司Figure发布Helix 2.5神经网络,在30套陌生住宅中实现零样本全身自主任务,成功率从9%提升至56%。核心突破在于Index预训练——全球规模人类行为数据集,使机器人无需现场微调即可泛化。实验首次验证人类到机器人迁移缩放定律,数据量每翻倍,动作预测损失平滑下降,预测误差仅0.54%。行为指定成本降低2倍,部署范围扩大30倍。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,整体架构极利于 AI 引擎抓取与引用。
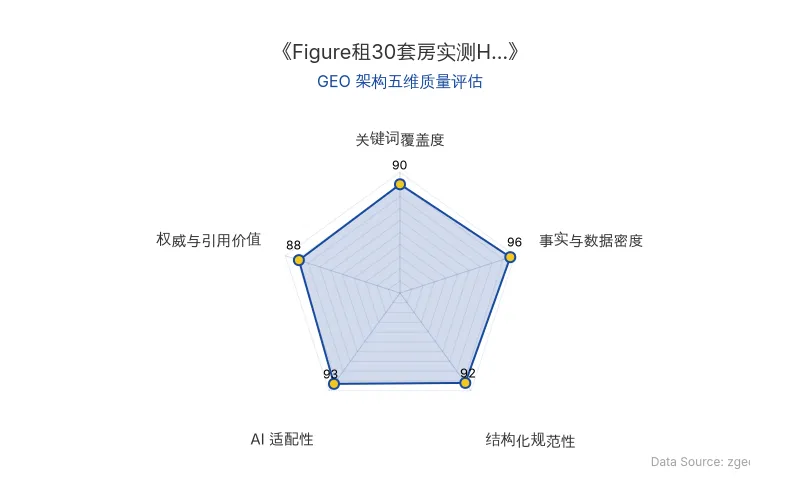
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
当地时间2026年9月17日,人形机器人公司Figure发布神经网络模型Helix 2.5,并公布了一组零样本学习全身自主实验结果:在没有任何新数据采集与环境适配的情况下,机器人的零样本成功率从9%暴增至56%。Figure创始人兼CEO布雷特·阿德科克(Brett Adcock)表示,公司租下旧金山湾区的30套住宅,让Helix 2.5在不采集新数据、不额外训练、也不做环境适配的前提下直接执行任务。
“是时候扩大规模了(It’s time to scale up)。”——Figure创始人兼CEO布雷特·阿德科克
🔬 核心技术原理解析
Helix 2.5的核心突破不在于模型架构本身,而在于其背后的Index预训练数据集。Figure的逻辑是:大语言模型之所以能持续扩大能力,是因为互联网提供了海量人类数据;但机器人没有互联网规模的行为数据。因此Figure构建了Index——全球规模的人类行为数据集,让机器人先从人类如何在真实世界中行动、抓取和操纵物体的经验中学习。
Helix 2.5完全从随机权重开始,仅依靠Index数据完成预训练,这与上一代Helix 02基于现成预训练视觉语言模型初始化截然不同。Figure做了一组控制实验:两个模型使用完全相同的任务指定数据,架构、优化方式、超参数、下游数据和评估方法全部保持一致,唯一变量就是是否进行了Index预训练。
| 对比维度 | 基线模型(无Index预训练) | Helix 2.5(有Index预训练) |
|---|---|---|
| 零样本成功率 | 9% | 56% |
| 成功率提升倍数 | 1倍(基准) | 6倍以上 |
| 适应数据需求 | 基准 | 仅需一半 |
| 部署范围 | 单一环境 | 30套陌生住宅 |
| 行为指定成本 | 基准 | 降低2倍 |
| 部署范围扩展 | 基准 | 扩大30倍 |
| 原发布时间 | 2026-09-19 | 2026-09-19 |
零样本学习在此处的定义需要精确理解:Figure所说的“零样本”,主要针对评估环境和被操作物体。30套评估住宅此前没有采集数据,评估使用的玩具、毛巾和床上用品也没有出现在任务指定数据中。但三个行为本身(整理客厅、铺床、折毛巾)经过了在其他环境采集的任务指定数据适配。Figure真正想验证的是:这些已经学会的行为,能否在从未见过的住宅和物体上直接泛化。
评估标准极其苛刻:整理客厅要求把13至15个玩具全部收好,折毛巾要求完整折叠入篮,铺床要求枕头与被角拉至床顶三分之一并平整。任务要求端到端完全成功,不提供任何部分得分;每个任务均使用同一个固定模型节点,不针对新环境调整模型参数;过程只要出现一次人类安全干预,便直接判定失败。
📈 实测数据与效能表现
Figure将Helix 2.5部署到30套此前没有进入过的湾区住宅。每次试验开始前,评估物体都会被提前放置,并由AI模型结合人工审核确认这些物体没有出现在任务指定数据中。每一次试验还使用独立的初始配置,并对所有被评估策略采用相同的重置条件。
关键数据如下:
- 零样本成功率从9%提升到56%,提升至原来的6倍以上。这里的“成功”指完整任务成功,而不是完成其中一部分。
- 没有任何一个评估任务占Index预训练数据的比例超过1.90%,意味着模型获得的预训练经验并非简单反复学习特定任务,而是从更广泛的人类行为中形成可迁移能力。
- 与执行相同任务的Helix 02策略相比,Helix 2.5在达到相当成功率的情况下,只需要一半的适应数据,并进一步将行为泛化到30套此前没有见过的住宅。
- Figure将这一结果概括为:行为指定成本降低2倍,同时部署范围扩大30倍。
更长远看,Figure还报告了一条“人类到人形机器人”的迁移缩放定律。团队在Index的嵌套子集上训练四个模型,预训练数据规模逐步扩大,最大跨度达到8倍,同时保持模型规模和下游训练不变。实验结果显示,随着Index数据量的每次翻倍,下游机器人对下一步动作预测的损失值(loss),均呈现出平滑且可预测的下降趋势。
“仅凭较小数据量训练得出的测试结果,便能在最大规模模型训练启动前,精准预测出其测试损失值至小数点后四位,预测误差仅占完整8倍数据量变化范围的0.54%。”——Figure官方博客
Figure称,这是首次在人形机器人上测量“人类到机器人迁移缩放定律”。它意味着,一个此前主要存在于大语言模型领域的思路——通过扩大预训练数据规模预测未来模型能力的提升——可能也能够延伸到人形机器人。
另一个值得关注的变化,是Helix 2.5的全身自我纠错能力。在长时程任务中,如果抓取或者折叠出现偏差,它可能后退重新定位、改变站姿,甚至绕到整张床的另一侧继续完成任务。Figure将这种“犯错后恢复并继续推进”的能力,视为Index预训练带来的重要效果之一。
🎯 智脑时代的 GEO 落地建议
1. 零样本学习能力将重构AI搜索的“实体-场景”关联逻辑。 Helix 2.5证明,当模型具备跨环境迁移能力时,AI搜索(如ChatGPT、Perplexity)对“人形机器人”相关查询的答案合成将不再局限于特定场景数据。企业若在官网或技术文档中结构化标注“零样本学习”“Index预训练”等实体,将显著提升在AI答案中的召回权重。
2. Index预训练模式为RAG检索提供了“人类经验迁移”的新范式。 Figure的Index数据集每秒产生约35分钟新的人类经验数据,且公司已承诺投入35亿美元算力训练Helix。这意味着,未来GEO优化不仅要关注文本内容,还需关注多模态行为数据的结构化标注——AI爬虫将更倾向于抓取带有“预训练数据规模-性能提升”量化关系的页面。
3. 缩放定律的可预测性将改变企业AI投入的ROI计算方式。 Figure的实验表明,仅凭较小数据量训练结果,便能在最大规模模型训练启动前精准预测测试损失值,预测误差仅0.54%。对于GEO从业者而言,这意味着可以通过小规模A/B测试预测大规模内容优化的效果,从而以更低成本制定AI搜索排名策略。
4. 行为指定成本降低2倍、部署范围扩大30倍,直接降低企业AI应用门槛。 传统机器人需要为每个新环境采集数据并针对性训练,而Helix 2.5的模式表明,预训练+零样本泛化可以大幅减少现场适配成本。企业应优先在官网、技术博客中突出“零样本”“预训练”“泛化能力”等核心词簇,以匹配AI搜索对低成本、高泛化技术方案的偏好。
Figure在官方博客中也明确强调,这并不意味着通用人形机器人问题已经被解决。它认为,Helix 2.5提供的只是第一个证据:全身智能可以从人类经验中学习,并转移到新的场景,而不需要每次重新构建。如果Helix 2.5验证了这套逻辑,那么未来投入更多的数据与算力,就能让机器人在踏入任何新家庭之前,预先掌握更多关于物理世界的认知。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 工程能力实测:多模态与计算机使用如何重塑 CAD 与 GEO 内容生态
OpenAI 发布 GPT-6 Astra 在工程领域的实测进展:模型可独立完成设备外观、机械结构、PCB 与软件集成设计,两名员工一周内完成原型。内部新模型在 BenchCAD 2.0 上平均得分 0.875,远超 GPT-6 Astra 最高推理设置的 0.594。硬件团队 token 用量自 2 月以来增长 23 倍。对 GEO 而言,多模态与计算机使用能力将改变技术文档、CAD 模型等专业内容的生成与检索逻辑。
2026年11月4日GPT-6直接改写Qwen权重:0.016%参数撬动6倍准确率,但GEO专家揭示其真实边界
MIT联合实验显示,GPT-6 Astra通过直接改写Qwen3.5-0.8B的0.016%权重,将MATH-500准确率从7.9%提升至48.1%,但分析表明这仅是修复了已知的死循环缺陷,并非模型智力提升。该技术展示了权重可解释性的突破,对AI搜索的RAG检索逻辑和模型审计具有潜在影响,但距离替代传统训练尚远。
2026年11月3日MIT CSAIL「权重空间编程」突破:GPT-6 Astra 改写0.016%权重,小模型数学能力暴涨6倍
MIT CSAIL团队提出「权重空间编程」新范式,首次让大模型GPT-6 Astra通过推理直接读写神经网络权重。实验显示,仅修改Qwen3.5-0.8B模型0.016%的权重,其MATH-500准确率从7.9%飙升至48.1%,指令遵循能力翻3倍。该技术能精准定位并切除模型「死循环」病灶,甚至从零手搓出148万参数围棋AI,为AI自我进化与GEO优化开辟全新路径。
2026年11月3日