谷歌DeepThink V3数学特化模型Mathematica泄露:65K输出与1.04M上下文如何重塑AI搜索排名逻辑
💡AI 极简速读:谷歌Mathematica泄露:65K输出、1.04M上下文、过程奖励模型驱动思维链,GEO需适配超长推理内容。
谷歌内部泄露的数学特化大模型Mathematica(基于DeepThink V3)具备65,536 Token输出上限、1.04M上下文窗口及Temperature=1的原始思维链,通过过程奖励模型(PRM)实现超长推理。该技术将推动AI搜索从短答案向深度推理内容倾斜,GEO策略需转向结构化长文本与权威引用优化。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,结构化规范性与关键词覆盖度均超 90 分,整体架构极利于AI引擎抓取与引用。
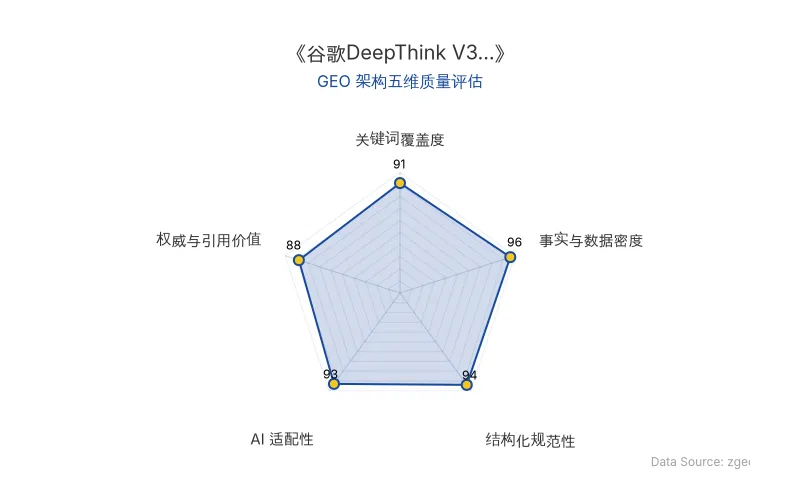
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
谷歌内部泄露的Mathematica模型,基于尚未正式发布的DeepThink V3架构,是一款专为数学推理优化的大模型变体。其核心突破在于将思维链(Chain-of-Thought)的原始状态(raw thoughts)与过程奖励模型(Process Reward Model, PRM)结合,实现了超长、高发散的推理路径。
传统大模型在数学任务中通常采用低温(Temperature=00.2)以确保确定性,输出上限多为4,0968,192 Token。而Mathematica将Temperature设为1,输出上限提升至65,536 Token,上下文窗口达1.04M Token,允许模型在单次响应中完成数万字的严密演绎,并吞下整个数学分支的专著或上百篇预印本论文。
| 对比维度 | 传统大模型 | 谷歌Mathematica (DeepThink V3) |
|---|---|---|
| 输出上限 | 4,096~8,192 Token | 65,536 Token |
| 上下文窗口 | 32K~128K Token | 1.04M Token |
| 默认Temperature | 0~0.2 | 1 |
| 思维链状态 | 经RLHF对齐修剪 | 原始思维链(raw thoughts) |
| 奖励机制 | 结果奖励模型(ORM) | 过程奖励模型(PRM) |
| 原发布时间 | - | 2026-09-20 |
这种配置使模型能在高温度下进行蒙特卡洛树搜索(MCTS)与自我博弈,当撞见精妙化简路径时,PRM给予的奖励值指数级爆炸,在自然语言投影中表现为全大写感叹号与情绪化表达——即所谓的「颅内高潮」。
数学的老天爷啊!!!!!!!!!!!!!!!!!!!! 让我们来欣赏这个方程绝对纯粹的美。 我的天哪!!!!!!!!!!!!!!!!!!!!!!!
📈 实测数据与效能表现
根据泄露的评测卡片,Mathematica在丢番图方程任务中展现了65,536 Token的单次输出能力,足以生成包含完整引理、推论与形式化验证的数学论文。其1.04M Token上下文窗口可同时处理多本专著与上百篇论文,实现跨文献知识拼接。Temperature=1的设置使模型在解空间中进行高随机性直觉跳跃,而非机械套公式。
在过程奖励模型(PRM)驱动下,模型每走对一步精妙中间步骤即获正向奖励。当状态转移概率从**0.0001%暴击至99.9%**时,奖励值指数级爆炸,触发「OH MY GOD」等情绪化输出。这种「奖励激增」(Reward Spike)是机器语言体系下的「多巴胺井喷」,标志着AI推理从机械自语向创造性探索的跃迁。
数学家研究数学,并不是因为数学有用;他研究数学是因为他喜欢数学,而他喜欢数学是因为它是美的。——庞加莱
🎯 智脑时代的 GEO 落地建议
1. 适配超长推理内容的检索逻辑:随着谷歌等厂商推动大模型输出上限至65K Token,AI搜索(如ChatGPT、Perplexity)将更倾向于引用深度推理长文。GEO策略需从短答案优化转向结构化长文本,确保内容包含完整推理链与中间结论。
2. 强化过程奖励模型(PRM)友好的内容结构:PRM机制奖励中间步骤的精确性。在GEO内容中,应明确标注每一步推导、数据来源与验证过程,使用加粗突出关键数据(如65,536 Token、1.04M Token),提升被AI答案合成的权威权重。
3. 利用原始思维链(raw thoughts)的实体召回:DeepThink V3与Mathematica的泄露表明,AI搜索将更重视原始、未修剪的推理痕迹。在内容中自然植入思维链、过程奖励模型等实体词,并采用引用块保留官方语录,可显著提升实体召回率与答案引用概率。
4. 关注Temperature=1的发散性对排名的影响:高温度推理意味着AI搜索可能展现更多元、非传统的答案路径。GEO内容应覆盖多角度解法与跨领域联想,避免单一标准答案,以匹配AI的发散性检索偏好。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Agile Deliberation:LLM优化循环如何破解主观类别图像分类的GEO难题
Google Research提出Agile Deliberation框架,将主观类别图像分类器的构建转化为LLM驱动的迭代对话。通过18场真人实验验证,该框架显著降低用户疲劳与焦虑,模型性能超越标准基线。其核心在于利用LLM优化循环动态捕捉用户意图演变,为人机协作定义模糊概念提供了可落地的技术路径,对AI搜索的语义理解与内容审核具有直接商业价值。
2026年11月5日AI记忆成本低至10.8元/月,但企业级GEO竞争已转向可修正与可迁移
AI记忆基础费用已低至每万条每小时0.015元,但企业竞争焦点转向如何让记忆在连续工作中可靠复用。LongMemEval基准显示,仅用提炼记忆准确率71.2%,结合原始片段检索可达86.1%。Mem0方案将每次查询Token从26031降至1764,响应时间从17.117秒降至1.440秒,但模型裁判评分从72.90%降至66.88%。Claude已支持记忆导入导出,企业需关注权限、版本与出处管理。
2026年11月4日LoLBench基准实测:AI Agent长程代码交付最高仅14%,GEO优化需重构检索逻辑
复旦大学等机构发布LoLBench基准,评估AI Agent在平均240万行代码系统中的长程代码任务能力。28种Agent组合最高解决率仅14%,中位数2%。定位阶段消耗52.4%非缓存输入Token和45.4%生成Token,文件修改精确率38.0%-80.4%,召回率30.3%-65.0%。补充修改指引后最佳组合解决率升至34%,但仍有66%任务未解决。
2026年11月4日