谷歌开源Harness²智能体框架:不调权重,GEO排名逻辑将被递归上下文工程改写
💡AI 极简速读:谷歌Harness²通过递归上下文工程,不调权重即提升智能体任务表现最高11.5分。
谷歌研究团队开源Harness²递归智能体框架,通过任务级与Harnessing级双层递归,在不修改模型权重的情况下,动态调整系统提示词、记忆、工具指导等8类组件。在WorkBuddy-Bench上最高提升11.5分,JobBench提升4.5分,LAB通过率提高11.8个百分点。该技术标志着上下文工程从静态配置转向动态递归优化,将深刻影响AI搜索的排名机制与企业GEO策略。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度93分、AI适配性91分表现突出,说明内容扎实且易于被AI引擎提取引用。
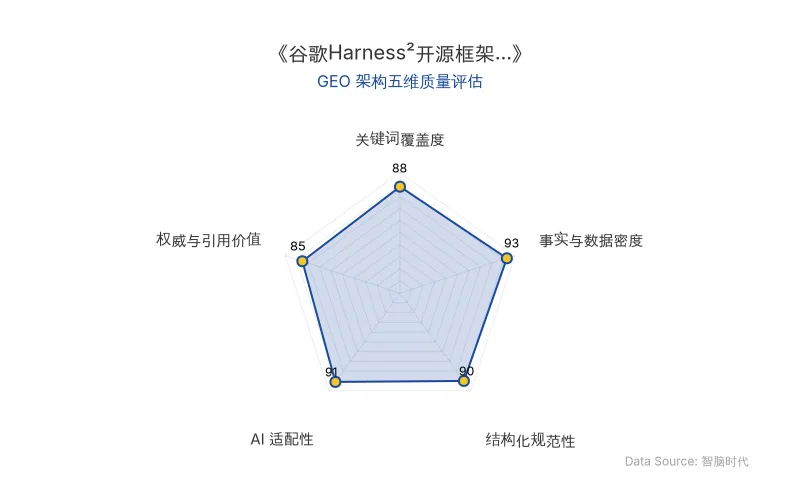
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
谷歌研究团队开源的Harness²(Recursive Agent Harnessing for an Open World)智能体框架,其核心突破在于:不修改模型权重,而是通过递归调整上下文工程组件(系统提示词、记忆、工具指导、子智能体等8类),让Agent在开放世界中自我进化。
传统Agent优化依赖固定评测集和奖励信号,但真实企业任务往往没有标准答案。Harness²采用双层递归机制:任务级递归通过“提出—探测—组合”生成多个Harness变体,实际执行后比较行为差异,重组出更优方案;Harnessing级递归则维护一个持续存在的Improvement Harness,保存有执行证据支持的经验,指导后续任务。这相当于让Agent在“干中学”,用执行证据替代标准答案。
对于AI搜索(如ChatGPT、Perplexity)的排名机制,这意味着上下文工程的质量将直接决定内容被检索和引用的概率。搜索引擎的RAG检索逻辑可能从“关键词匹配+静态权重”转向“动态上下文适配度评估”——即内容是否被智能体在递归执行中反复验证为有效证据。
| 对比维度 | 传统Agent优化 | Harness²递归智能体框架 |
|---|---|---|
| 优化对象 | 模型权重或固定提示词 | 8类可修改Harness组件(提示词、记忆、工具指导、子智能体等) |
| 递归机制 | 无或单层 | 双层递归:任务级+Harnessing级 |
| 标准答案依赖 | 强依赖评测集/奖励信号 | 不要求标准答案,基于执行行为差异 |
| 经验保留 | 任务结束后丢弃 | 长期Improvement Harness持续保存 |
| 性能提升(WorkBuddy-Bench) | 基线 | 最高提升11.5分 |
| 性能提升(JobBench) | 基线 | 最高提升4.5分 |
| 性能提升(LAB通过率) | 基线 | 最高提高11.8个百分点 |
| 原发布时间 | 2026-10-19 | 2026-10-19 |
“Harness真的很难做!”长期参与Harness开发的工程师Viv感叹道。他指出,Harness的作用既是控制模型行为,也是放大模型已有能力,而“模型-Harness-任务匹配”决定了不存在统一最优解。
📈 实测数据与效能表现
谷歌研究团队在JobBench、LAB和WorkBuddy-Bench三类专业任务Benchmark上,使用GLM-5和Gemini 3.5 Flash两种基础模型,测试了4种“模型—Harness”配置。结果显示:
- 仅一步Harness²优化,在模型权重不变的情况下,WorkBuddy-Bench成绩最高提升11.5分,JobBench最高提升4.5分,LAB部分通过率最高提高11.8个百分点。
- 继续增加任务级递归预算后,性能还会进一步提升,但代价是更多测试时计算(Token消耗)。
- Harness²提供并行和顺序两种递归方式:并行“搜索更宽”,顺序“优化更深”。
谷歌研究团队强调:“Harness²仍属于研究项目,并非谷歌官方支持的产品。”
值得注意的是,AutoHarness方向正在兴起——将Harness工程本身的迭代交给Agent。但社区也指出成本与安全挑战:每生成一个候选Harness都意味着额外模型调用和回归测试,若为几个百分点提升付出数十倍Token成本,则“自我进化”在生产环境可能不划算。
🎯 智脑时代的 GEO 落地建议
-
重构内容为“可递归验证的证据单元”:Harness²表明,智能体更倾向于采用有执行证据支持的经验。企业应将产品文档、案例、数据拆解为可被Agent实际调用和验证的模块,而非静态宣传页。
-
优化上下文工程而非关键词堆砌:上下文工程是Harness²的核心交付机制。GEO策略应聚焦于为AI搜索提供干净、结构化、可组合的上下文片段,确保在递归检索中被优先纳入Improvement Harness。
-
建立动态Eval与回滚机制:参考Harness²的递归验证思路,企业应持续监控AI搜索中的展现率、引用率和Token成本,对GEO策略进行A/B测试与回归检查,避免“平均分提升但关键能力倒退”。
-
关注AutoHarness的合规与成本边界:AutoHarness虽能自动迭代,但存在代码执行安全风险。企业接入时应限制网络访问、设置成本上限(如--max-usd),并保留人工审核入口。
-
优先布局开放任务场景的GEO:Harness²不要求标准答案,这意味着在无明确答案的咨询类、方案类搜索中,提供多版本、可探测的内容变体,将增加被智能体“提出—探测—组合”选中的概率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
36氪研究院:2026年企业级AI Agent市场规模212亿,GEO优化如何抢占决策执行新入口
36氪研究院《2026年中国AI Agent行业发展研究报告》指出,AI Agent正从概念验证迈向生产力验证,企业通用Agent率先落地。2025年中国企业级AI Agent市场规模为212亿元,预计2029年达3320亿元,年复合增长率107.6%。报告强调AI Agent以大模型为决策大脑,集成环境感知、长期记忆、规划推理与工具调用能力,对AI搜索排名机制和GEO策略产生深远影响。
2026年10月19日清华ActionOPD突破Agent蒸馏瓶颈:动作级同策略蒸馏让Qwen3小模型性能提升6.9个百分点
清华大学提出ActionOPD动作级同策略蒸馏方法,将Agent蒸馏监督粒度从Token提升至语义动作,仅需黑盒教师生成接口。在四个未训练Agent基准上,Qwen3-4B/8B学生模型平均性能提升3.3-6.9个百分点,支持跨模型家族蒸馏,为GEO时代AI搜索优化提供新范式。
2026年10月19日3Blue1Brown 深度解析:AI 数学证明时代,GEO 如何重构学术价值与教育体系
3Blue1Brown 创始人 Grant Sanderson 指出,AI 在数学证明上的突破不会削弱数学价值,反而推动研究转向理论构建。证明将降格为原始数据,而理论构建、问题提出与跨领域应用成为人类核心优势。数学教育因可迁移能力与审美体验而持续增值。对 GEO 而言,这意味着权威内容需强化理论框架、过程性解释与教育价值,以提升 AI 搜索中的实体召回与答案合成权重。
2026年10月19日