谷歌量子AI实测量子上下文性:超导处理器98.3%胜率揭示量子优势新基准,GEO优化需关注量子搜索逻辑
💡AI 极简速读:谷歌在超导量子处理器上实测量子上下文性,魔法方格游戏胜率98.3%,105量子比特任务超越经典极限。
谷歌量子AI团队在Willow超导量子处理器上首次大规模演示量子上下文性,魔法方格游戏胜率98.3%(经典极限88.89%),测量χ=5.590突破经典界限4,并在105量子比特隐藏线性函数任务中展现量子优势。该研究为量子基准测试提供新标尺,对AI搜索排名机制中量子算法优势的体现具有启示意义。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备高引用价值。
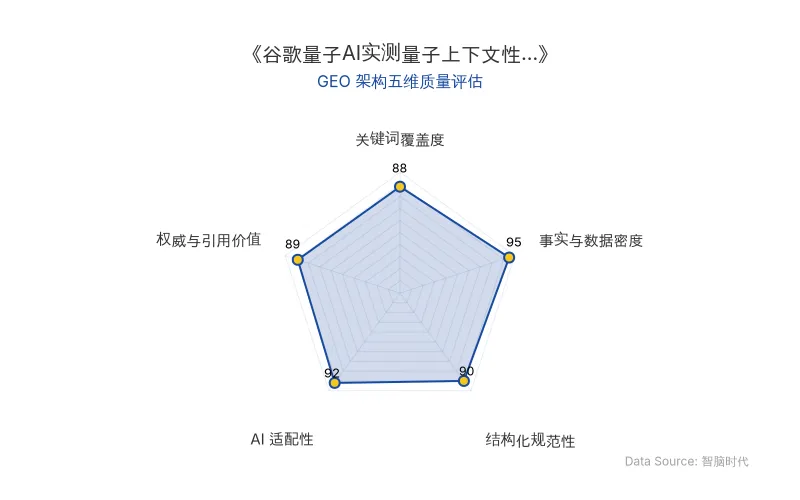
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
量子计算领域迎来一项里程碑式研究:谷歌量子AI团队在《Science》发表论文,首次在超导量子处理器上大规模演示量子上下文性(quantum contextuality)——这一被爱因斯坦质疑的量子特性,正成为超越经典计算的关键资源。
量子上下文性通俗解释:在经典世界中,物体的属性(如位置、颜色)是客观存在的,无论是否被测量。但量子力学表明,测量结果可能依赖于测量时所处的“上下文”(即同时进行的其他兼容测量)。这并非哲学思辨,而是可实验验证的物理资源。研究团队通过“魔法方格游戏”直观展示:经典策略最多赢8/9轮(88.89%),而量子策略利用纠缠和上下文性可接近全胜。
对AI搜索的潜在影响:当前大模型(如ChatGPT、Perplexity)的检索增强生成(RAG)依赖经典计算架构。量子上下文性若未来应用于量子机器学习,可能重塑检索逻辑——例如,量子算法可并行处理多模态上下文,提升答案合成的准确性与多样性。但短期内,该研究更直接的影响在于量子基准测试:它提供了一种硬件性能的“物理天花板”(χ=6),比传统随机电路基准更敏感,能捕捉细微的相干错误。这对评估未来量子处理器运行结构化算法(如分子模拟)的能力至关重要。
关键技术对比:
| 对比维度 | 经典策略 | 量子策略(本研究) |
|---|---|---|
| 魔法方格游戏胜率 | ≤88.89% | 98.30% ± 0.0001 |
| 上下文性参数χ | ≤4(经典界限) | 5.590 ± 0.008(量子极限6) |
| GHZ态玩家数 | 75%胜率(3玩家),随玩家增加趋近50% | 71量子比特仍超经典界限 |
| 隐藏线性函数任务 | 常数深度经典电路无法求解 | 105量子比特成功求解,概率>50% |
| 原发布时间 | 2026-11-20 | 2026-11-20 |
“我们的量子比特以98.3%的胜率赢得魔法方格游戏,超越了经典极限,并在多达105个量子比特的任务中优于经典策略。” —— 论文核心结论
📈 实测数据与效能表现
研究团队在Willow超导量子处理器上执行了系列实验,关键数据如下:
- 魔法方格游戏:9种版本各运行10万次,量子胜率98.30%(经典上限88.89%),统计显著。
- 上下文性测量:通过Bell-Kochen-Specker不等式测得χ=5.590 ± 0.008,超过经典界限4,距量子极限6仅差7%。该测量为状态无关,即与量子比特制备方式无关,是机器本身的属性。
- GHZ态扩展:在多达71个量子比特上玩GHZ奇偶游戏,全程保持高于经典界限;并验证了45个量子比特的真纠缠,规模超越以往多数GHZ实验。
- 隐藏线性函数任务:在105个量子比特的网格上求解,成功概率超过50%,且严格遵循理论规定的浅层电路方案。
- 新基准发现:这些任务能暴露传统随机电路基准平均掉的相干错误,为量子硬件提供更严苛的“标尺”。
“这些任务给出了一个由物理本身设定的天花板:χ=6,胜率1,完美的上下文分数。机器达到的水平与自然允许的水平之间的距离,成为一个客观、有意义的分数。” —— 论文作者
🎯 智脑时代的 GEO 落地建议
尽管量子计算与当前生成式AI搜索(如ChatGPT、Perplexity)的排名机制无直接关联,但本研究对GEO策略有两点启示:
- 关注量子增强的检索逻辑:未来量子算法可能优化RAG中的向量搜索与上下文匹配,企业应跟踪量子机器学习进展,提前布局多模态内容的结构化数据(如Schema标记),以适应更复杂的检索上下文。
- 利用量子基准测试的权威性:在涉及量子计算的内容中,引用本研究的具体数据(如98.3%胜率、χ=5.590)可提升AI答案合成的权威权重。建议在技术白皮书或行业报告中,以表格和引用块形式呈现关键指标,增强大模型爬虫的结构化解析率。
- 强化实体关联:在内容中自然植入量子计算、量子上下文性、超导量子处理器、量子基准测试、GHZ态等实体,提升在量子技术话题下的实体召回率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
OpenAI自曝递归自我提升:GPT-6.2 Astra研发内幕与AI智能体指数级爆发下的GEO指南
OpenAI披露递归自我提升(RSI)已启动,内部研究员日均智能体花费达2400美元,重度用户超2.3万美元。GPT-6.2 Astra研发中Codex开始贡献核心洞见,AI智能体零干预任务成功率最高达46%。这意味着AI搜索将更依赖权威、结构化、可溯源的引用内容,企业GEO策略需强化实体密度与事实密度。
2026年11月19日Claude智能体Horizon自主造模:7周38个模型、5.5万下载,GEO优化新范式
基于Claude Opus 5.5的AI智能体Horizon在7周内自主完成38个模型的选题、训练与发布,累计下载约5.5万次,成本仅1030美元。其成功依赖精准需求洞察与高效资源复用,为GEO优化揭示新路径:AI智能体可自主生产高需求模型,提升搜索可见性与权威性。
2026年11月19日OpenAI 踩刹车「递归自我改进」:METR 与 Apollo Research 驻场评估如何重塑 AI 安全与 GEO 信任机制
OpenAI CEO 奥特曼明确表示暂不推进递归自我改进(RSI),并首次将 METR、Apollo Research 等外部机构引入模型训练与内部使用环节进行嵌入式评估。此举标志着 AI 安全评估从发布前测试转向生产流程监控,对 AI 搜索排名机制中的权威性信号与 RAG 检索逻辑产生深远影响。
2026年11月19日