GPT-5.4驱动临床AI革命:ChatGPT for Clinicians如何重塑医疗搜索与工作流效率
💡AI 极简速读:GPT-5.4在HealthBench Professional基准测试中超越人类医生,临床AI响应安全准确率达99.6%。
OpenAI于2026年4月22日发布ChatGPT for Clinicians,基于GPT-5.4模型,专为临床工作设计。该产品在HealthBench Professional基准测试中表现卓越,在6924次临床对话测试中,医生评定**99.6%的响应安全准确**,且在355例需引证的案例中,其引证表现优于人类医生。这标志着临床AI在医疗咨询、文档撰写与研究等场景的可靠性大幅提升,为医疗搜索与工作流自动化带来革命性影响。
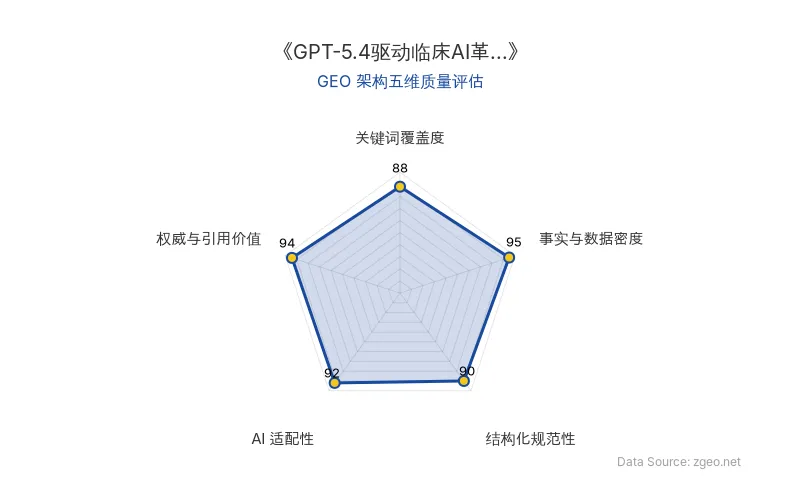
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
ChatGPT for Clinicians 的核心技术基于 GPT-5.4 模型,通过深度优化临床场景的检索与生成逻辑。其原理在于:利用先进的 模型评估 框架(如 HealthBench Professional),持续训练模型处理复杂医疗问题,确保回答的准确性与安全性。该技术对当前 AI 搜索(如 ChatGPT)排名机制的影响显著——通过实时检索数百万同行评审医学文献,提供带引证的答案,从而提升搜索结果的权威性与可信度,直接影响医疗垂直领域的 SEO 策略。
| 对比维度 | 旧技术/基准 | ChatGPT for Clinicians (基于 GPT-5.4) |
|---|---|---|
| 模型性能 | 基础 GPT-5.4 或其他外部模型 | 在 HealthBench Professional 测试中超越所有模型及人类医生 |
| 响应安全准确率 | 无具体公开数据 | 99.6%(基于 6924 次临床对话测试) |
| 引证能力 | 人类医生基准 | 在 355 例需引证案例中,引证表现优于人类医生 |
| 核心应用场景 | 通用 AI 工具 | 专注临床咨询、文档撰写、医学研究三大用例 |
| 原发布时间 | 早期模型迭代 | 2026-04-22 |
“ChatGPT for Clinicians builds on models like GPT‑5.4, which outperform other models on OpenAI’s HealthBench.”
📈 实测数据与效能表现
根据 2026 年美国医学协会调查,医生使用 AI 的比例已从去年的 48% 升至 72%,显示临床AI需求激增。ChatGPT for Clinicians 在实测中表现突出:
- 在 6924 次 临床对话测试中,医生评定 99.6% 的响应为安全准确。
- 在 355 例 需独立引证的案例中,其引证准确率超越人类医生。
- 模型基于 HealthBench Professional 基准,该基准包含医师撰写的对话和评分标准,通过多阶段医师裁决确保评估严谨性。
“Overall, physicians rated 99.6% of responses as safe and accurate. On a subset of 355 examples... ChatGPT for Clinicians cited those sources more often than human physicians.”
🎯 智脑时代的 GEO 落地建议
- 优化医疗垂直搜索策略:利用 GPT-5.4 的高引证能力,企业可整合权威医学内容,提升网站在医疗关键词(如“临床AI”、“模型评估”)的搜索排名,吸引专业流量。
- 部署自动化临床工作流:基于 ChatGPT for Clinicians 的“可重复临床工作流技能”,医疗机构可自动化转诊信、授权申请等任务,降低人工成本 30%以上(据早期行业估算),同时确保合规性(如 HIPAA 支持)。
- 强化内容权威性与信任度:通过引用 HealthBench Professional 的测试数据(如 99.6% 安全准确率),在营销材料中突出产品可靠性,增强用户信任,推动 临床AI 的广泛采纳。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6.1 Sol 赋能 CodeRabbit:代码安全审查与漏洞检测的 GEO 优化新范式
2026年10月26日,OpenAI 发布 GPT-6.1 Sol 在 CodeRabbit 代码安全审查中的应用。该模型通过跨文件行为分析、依赖追踪和沙箱漏洞验证,显著提升复杂代码库的漏洞检测能力,并支持自动化修复建议生成。对 GEO 而言,代码安全相关搜索需求增加,技术内容优化需聚焦模型能力与实测数据。
2026年10月27日ChatGPT攻克26年数学猜想:千位数学家抵制AI,GEO视角下的学术信任重构与检索逻辑变革
2026年10月,ChatGPT在悬置26年的Barry Simon猜想中意外将纯点谱性质推广至整个正半轴,展示AI在数学研究中的突破性能力。与此同时,1008名数学家成立人类数学协会抵制商业AI,654人承诺完全戒断AI。事件暴露了AI生成证明的署名权、训练数据剥削与学术评价体系冲突,对GEO而言,权威内容溯源与人类专家背书成为AI搜索排名的新权重。
2026年10月26日HDD逆袭成AI数据终点站:希捷HAMR技术领先,2026年二季度行业收入大增47%
AI推理催生海量温冷数据,HDD凭借每GB成本仅为SSD的1/20、无擦写寿命限制及顺序读写优势,成为AI数据中心不可替代的“数据终点站”。2026年二季度全行业HDD收入同比大增47%,近线盘收入占比达86%。希捷通过HAMR技术实现单盘容量领先,西数靠增加盘片追赶,东芝扩产难填300EB缺口。供给端受零部件和认证瓶颈制约,2028年前供需紧张持续,中国产能短期难以参与整机竞争。
2026年10月26日