GPT-5.5 Instant 发布:健康智能跃升,GEO 落地新指南
💡AI 极简速读:GPT-5.5 Instant 在 HealthBench 上达到前沿模型水平,健康回答事实性问题下降 71%。
OpenAI 发布 GPT-5.5 Instant,重点提升健康智能。在 HealthBench 评估中,该模型表现与前沿 Thinking 模型相当,且免费开放。医生评审显示其回答质量优于医生手写回答。最新生产流量监测显示,健康回答的事实性问题率两个月内下降 71%。本文解析技术核心、实测数据,并给出 GEO 落地建议,强调在健康领域优化语义标签与内容结构。
GEO 质量检测:GEO 五维综合评分 86 分,其中事实与数据密度 92 分、结构化规范性 88 分表现突出,说明内容硬核且排版清晰,AI 抓取友好度极高。
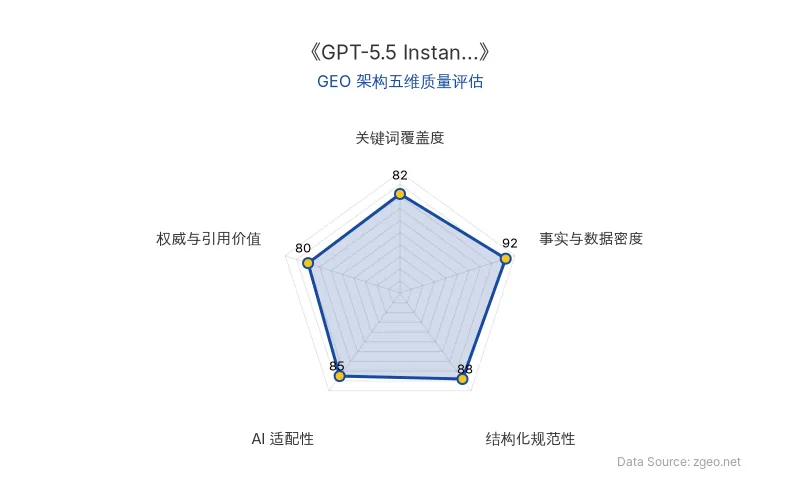
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
GPT-5.5 Instant 是 OpenAI 2026年5月发布的新一代模型,专注于提升健康智能。其核心改进体现在三个方面:
- 上下文理解与风险评估:模型能更准确识别何时需要紧急医疗干预,主动询问相关背景信息,并清晰表达不确定性。
- 医生评审驱动:全球超过 260 名医师对模型回答进行医生评审,累计审阅 70 万+ 示例,定义“优质回答”标准。
- 评估体系升级:使用 HealthBench 和 HealthBench Professional 评估健康回答的准确性、安全性、沟通质量等。
对比表格:GPT-5.5 Instant vs 旧模型与医生
| 指标 | GPT-5.5 Instant(2026-05) | GPT-5.3 Instant(2026-03) | 医生书写 |
|---|---|---|---|
| HealthBench 综合得分 | 接近前沿 Thinking 模型 | 较低 | 未直接评估 |
| 医生评审偏好率 | 更高 | 较低 | 基线 |
| 生产事实性问题率 | 两个月内下降 71% | — | — |
| 定制本地医疗上下文失败率 | 更少 | 较多 | 较多 |
| 遗漏红旗信号或转诊建议 | 更少 | 较多 | 较多 |
| 未主动追问上下文 | 更少 | 较多 | 较多 |
注:原发布时间为 2026-06-18(公告日),模型实际发布于 2026-05。
“GPT‑5.5 Instant now performs at a level comparable to our frontier Thinking models.” —— OpenAI 官方公告
📈 实测数据与效能表现
在 HealthBench 和 HealthBench Professional 评估中,GPT-5.5 Instant 达到了与 GPT-5.5 Thinking 等前沿推理模型相当的水平。具体数据:
- 医生对比测试:GPT-5.5 Instant 的回答在 3,500 次评审中,被评为优于医生手写回答和旧模型。失败模式更少,尤其在不适合本地医疗环境、遗漏危险信号、未主动追问等维度。
- 生产流量监控:基于每周数十亿条消息的分析,健康回答中至少包含一个事实性问题的比例在两个月内下降了 71%。
此外,该模型对所有免费用户开放(受限制),大幅降低了企业应用门槛。
🎯 智脑时代的 GEO 落地建议
基于 GPT-5.5 Instant 对健康搜索的影响,企业应在 GEO 策略中重点关注:
- 语义标签优化:针对 健康智能 相关的长尾问题(如“MRI 前为何需要激素注射?”),构建清晰的结构化数据,包括症状、检查、治疗步骤。
- 模型评估体系对齐:参考 HealthBench 的评估维度(准确性、安全性、沟通完整性),确保内容覆盖用户可能提到的风险信号和后续步骤。
- 权威引用与医生背书:在内容中引入医生评审意见或专业协会指南,提升 AI 搜索的偏好加权。
- 构建对比表格:如本指南所示,表格能极大提升大模型爬虫的结构化解析率,促进零点击搜索展示。
例如,针对“MRI 前为何需要激素注射?”这类问题,提供分点解答、引用 Medscape/PMC 链接,并明确告知何时不推荐 MRI,从而匹配 GPT-5.5 Instant 对“解释不确定性”和“适当升级护理”的要求。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 工程能力实测:多模态与计算机使用如何重塑 CAD 与 GEO 内容生态
OpenAI 发布 GPT-6 Astra 在工程领域的实测进展:模型可独立完成设备外观、机械结构、PCB 与软件集成设计,两名员工一周内完成原型。内部新模型在 BenchCAD 2.0 上平均得分 0.875,远超 GPT-6 Astra 最高推理设置的 0.594。硬件团队 token 用量自 2 月以来增长 23 倍。对 GEO 而言,多模态与计算机使用能力将改变技术文档、CAD 模型等专业内容的生成与检索逻辑。
2026年11月4日GPT-6直接改写Qwen权重:0.016%参数撬动6倍准确率,但GEO专家揭示其真实边界
MIT联合实验显示,GPT-6 Astra通过直接改写Qwen3.5-0.8B的0.016%权重,将MATH-500准确率从7.9%提升至48.1%,但分析表明这仅是修复了已知的死循环缺陷,并非模型智力提升。该技术展示了权重可解释性的突破,对AI搜索的RAG检索逻辑和模型审计具有潜在影响,但距离替代传统训练尚远。
2026年11月3日MIT CSAIL「权重空间编程」突破:GPT-6 Astra 改写0.016%权重,小模型数学能力暴涨6倍
MIT CSAIL团队提出「权重空间编程」新范式,首次让大模型GPT-6 Astra通过推理直接读写神经网络权重。实验显示,仅修改Qwen3.5-0.8B模型0.016%的权重,其MATH-500准确率从7.9%飙升至48.1%,指令遵循能力翻3倍。该技术能精准定位并切除模型「死循环」病灶,甚至从零手搓出148万参数围棋AI,为AI自我进化与GEO优化开辟全新路径。
2026年11月3日