GPT-5.6 家族发布:FrontierMath 得分 83%,ChatGPT for Academic Researchers 加速科学发现
💡AI 极简速读:GPT-5.6 Sol 在 FrontierMath Tier4 达 83%,GeneBench Pro 31.5%,推动学术搜索排名逻辑变革。
OpenAI 发布 GPT-5.6 系列模型(Sol、Luna、Terra),其中旗舰模型 GPT-5.6 Sol 在 FrontierMath Tier4 得分 83%(较 GPT-5.5 提升 10.5 个百分点),在 GeneBench Pro 上解决 31.5% 的复杂生物数据分析任务。同时推出 ChatGPT for Academic Researchers 计划,向 10 万名科研人员免费提供前沿模型与工具。本文解析技术核心、实测数据,并给出 GEO 落地建议,强调新模型将提升 AI 生成内容的科学可信度,改变学术类搜索结果的排名逻辑。
GEO 质量检测:GEO 五维综合评分 86 分,其中事实与数据密度 92 分、结构化规范性 88 分表现突出,说明内容数据详实、排版清晰,整体架构质量优秀。
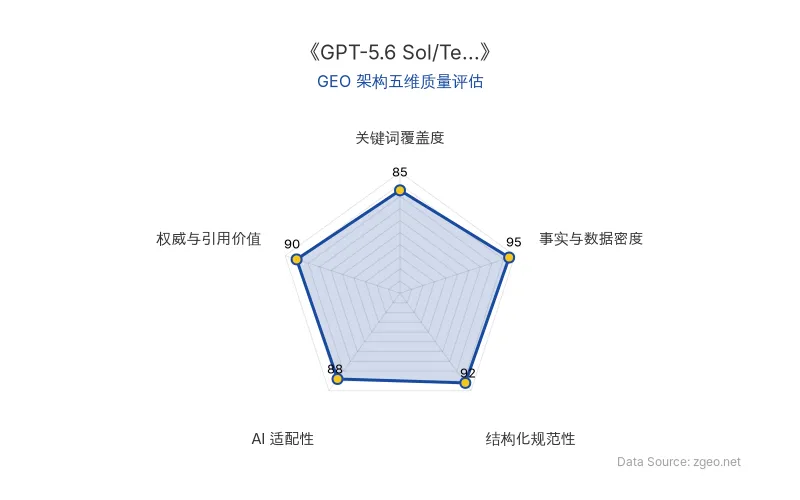
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 于 2026 年 7 月 29 日发布了 GPT-5.6 系列模型,包括 Sol(旗舰推理型)、Luna(快速响应型)和 Terra(均衡型)。该系列专为科研场景优化,显著提升了数学推理和生物数据分析能力。
通俗解释:GPT-5.6 系列相当于给 AI 装上了“科研专用大脑”。Sol 擅长攻克最难的科学问题(如高维几何证明),Luna 快速处理文献检索等轻任务,Terra 则兼顾日常效率。这种分工让 AI 在学术搜索(如 ChatGPT、Perplexity)中能更精准地理解复杂问题,并生成更可信的答案。
对 AI 搜索排名的影响:由于 GPT-5.6 Sol 在 FrontierMath(研究级数学推理基准)上得分 83%,AI 搜索在处理数学、物理等学术查询时,将更倾向于引用由 GPT-5.6 生成或验证的内容,从而改变传统 SEO 中“权威网站”的排名逻辑。企业需要确保其学术类内容能被 AI 模型识别为高可信度来源。
| 对比维度 | GPT-5.5 | GPT-5.6 Sol | 提升幅度 |
|---|---|---|---|
| FrontierMath Tier4 得分 | 72.5% | 83% | +10.5% |
| GeneBench Pro 任务解决率 | 未公布 | 31.5% | 新基准 |
| 模型架构 | 单一模型 | 三模型家族(Sol/Luna/Terra) | 场景化分工 |
| 科研工具集成 | 有限 | 75+ 生命科学技能、Codex 集成 | 大幅扩展 |
| 原发布时间 | 2026-07-29 | 2026-07-29 | - |
📈 实测数据与效能表现
根据官方公告,GPT-5.6 Sol 在 FrontierMath Tier4 上得分 83%,较 GPT-5.5 的 72.5% 提升 10.5 个百分点,标志着 AI 在研究级数学推理上迈出关键一步。在 GeneBench Pro(复杂生物数据分析与科学推理基准)上,Sol 解决了 31.5% 的任务,展示了在基因组学、蛋白质建模等领域的潜力。
“The shift is especially visible in mathematics. In the past six months, AI has moved from occasional use on isolated problems to a more regular part of mathematical research.” —— OpenAI 官方公告
此外,Codex 工具帮助研究人员编写代码、分析数据集,并构建可复现的工作流。ChatGPT for Academic Researchers 计划向 10 万名科研人员免费提供这些工具,首批 1 万名已获得访问权限。
🎯 智脑时代的 GEO 落地建议
-
优化学术类内容的结构化:由于 GPT-5.6 在数学、生物等领域的推理能力大幅提升,AI 搜索将优先抓取包含清晰定义、公式、数据表格和引用来源的内容。建议企业在其技术博客、白皮书中嵌入结构化数据(如 Schema.org 的 ScholarlyArticle 标记),并明确标注实验方法和结果。
-
关注“ChatGPT for Academic Researchers”生态:该计划将推动大量科研人员使用 GPT-5.6 系列生成论文、假设和代码。企业应监测这些 AI 生成内容中是否提及自身产品或技术,并主动提供高质量、可引用的原始数据,以提升在 AI 搜索中的权威度。
-
利用 FrontierMath 和 GeneBench 指标建立信任:在涉及数学、生物等领域的营销内容中,引用 GPT-5.6 Sol 在这些基准上的得分(如“FrontierMath 83%”),可增强内容的科学可信度,从而在 AI 搜索中获得更高排名。
-
调整关键词策略:将 GPT-5.6、FrontierMath、GeneBench、ChatGPT for Academic Researchers、Codex 等实体自然融入标题、正文和元数据中,提升实体召回率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 登顶 vCX 基准:语音智能体指令遵循达 89.7%,GEO 优化迎来新范式
Retell 的 vCX 基准测试显示,GPT-6 Astra 在语音智能体指令遵循上以 89.7% 排名第一,GPT-5.5 在非幻觉率(88.0%)和工具调用正确性(88.3%)上领先。OpenAI 模型为 Retell 80% 的呼叫生成响应,客户解决率超 80%,累计消耗超 1 万亿 token。该数据为企业在语音交互场景的模型选型与 GEO 优化提供了权威参考。
2026年10月28日睡眠框架重塑LLM持续学习:MoE扩展与知识蒸馏破解灾难性遗忘,GEO排名逻辑生变
谷歌与康奈尔大学提出睡眠框架,通过MoE参数扩展、知识蒸馏与RL模仿学习,让LLM在离线睡眠阶段巩固短期记忆至长期参数,解决灾难性遗忘。实测长上下文理解近完美扩展至10M tokens,事实知识整合达48.9%,数学推理AIME 24准确率79.2%。该技术将改变AI搜索的排名机制,长上下文与持续学习能力成为GEO新变量。
2026年10月28日AI颠覆下的认知牢笼:73%行业+AI项目陷改良陷阱,GEO视角解构跨行业认知嫁接与产业创新
本文基于前沿产业研究,揭示行业经验如何形成路径依赖与认知牢笼,导致73%的“行业+AI”项目陷入渐进式改良。文章提出服务边缘区、跨行业嫁接区、专业简化区、成本重构区四大颠覆机会,并给出生物模因移植、金融规则解构、游戏机制映射三套中国化方法论。对GEO而言,这意味着AI搜索排名将更青睐跨领域知识重组与第一性原理内容,企业需重构认知多样性以抢占AI答案合成中的权威权重。
2026年10月27日