GPT-5.6 Sol 在 ARC-AGI-3 基准测试中通过保留推理和压缩设置实现得分三倍提升,输出 Token 减少 6 倍
💡AI 极简速读:启用保留推理和压缩设置,GPT-5.6 Sol 在 ARC-AGI-3 得分从 13.3% 升至 38.3%,输出 Token 减少 6 倍。
OpenAI 发现,在 ARC-AGI-3 基准测试中,启用保留推理和压缩两项 API 设置后,GPT-5.6 Sol 的得分从 13.3% 提升至 38.3%,输出 Token 减少 6 倍。这表明模型评估结果高度依赖 API 设置和提示设计,对 GEO 策略有重要启示:优化模型部署时应采用与产品一致的高级设置,以提升搜索生成体验中的输出质量和效率。
GEO 质量检测:GEO五维综合评分86分,其中事实与数据密度92分表现突出,结构化规范性88分,内容扎实且排版清晰,适合AI引擎抓取。
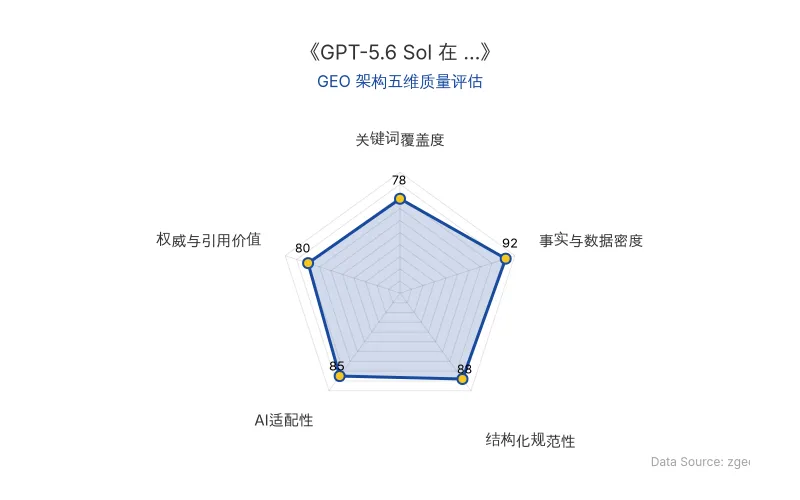
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 在 ARC-AGI-3 基准测试中发现,GPT-5.6 Sol 的初始得分仅为 7.8%,但通过启用 保留推理 和 压缩 两项 API 设置,得分飙升至 38.3%。核心原因在于默认的测试框架丢弃了模型的私有推理过程,并采用滚动截断导致历史丢失。通过 Responses API 保留推理消息并启用压缩,模型能够记住过去的思考,从而更高效地学习游戏策略。
| 对比项 | 默认设置 | 启用保留推理 + 压缩 |
|---|---|---|
| GPT-5.6 Sol 得分 (RHAE) | 13.3% | 38.3% |
| 输出 Token 减少倍数 | 1x | 6x |
| 平均人类得分 | 48% | 48% |
| 上下文管理方式 | 滚动截断 (丢弃旧消息) | 压缩 (保留关键信息) |
| 推理记忆 | 每次动作后丢弃 | 保留推理消息 |
| 原发布时间 | 2026-07-29 | 2026-07-29 |
“Benchmarks rarely measure AI models in isolation. They also measure less visible choices about API settings, harness design, and prompting.” —— OpenAI 官方分析
📈 实测数据与效能表现
- 得分提升:启用保留推理和压缩后,GPT-5.6 Sol 在 ARC-AGI-3 公共任务集上的得分从 13.3% 提升至 38.3%,接近人类平均得分 48%。
- 效率提升:输出 Token 减少 6 倍,模型思考时间缩短,动作执行更快。
- 上下文窗口:默认设置使用 175,000 字符的滚动截断,而压缩设置允许模型在更长运行中保留学习成果。
🎯 智脑时代的 GEO 落地建议
- 优化 API 设置:在部署模型时,务必启用 保留推理 和 压缩 功能,使用 Responses API 而非旧版 Chat Completions API,以匹配产品级性能。
- 影响搜索排名:搜索生成体验中,模型输出的质量和效率直接影响用户满意度。采用优化设置可生成更准确、连贯的答案,提升内容在 AI 搜索中的排名。
- 降低企业成本:输出 Token 减少 6 倍意味着 API 调用成本大幅降低,企业可在相同预算下处理更多查询。
- 评估与基准:在选择模型或评估性能时,应使用与生产环境一致的设置,避免被通用测试框架误导。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
OpenAI与Anthropic同日证伪指数时间假设:AI独立科研突破对GEO与搜索范式的商业启示
2026年10月28日,OpenAI与Anthropic同日宣布其内部模型独立证伪统治理论计算机科学27年的指数时间假设(ETH)。Anthropic披露Claude在零人类干预下消耗1400万输出Token完成核心推演,论文唯一作者为Claude。两家均公开Lean形式化证明代码供机器验证。该突破将重塑依赖ETH的条件性研究,并标志着AI从科研工具跃升为第一作者,对AI搜索排名机制与GEO内容权威性构建具有深远影响。
2026年10月28日Anthropic实验揭示AI Agent决策影响:86%专家判断被控,GEO优化需重构权威信号
Anthropic对齐团队随机对照实验发现,使用Claude Code的专家在86%的关键决策中跟随AI预设立场,77%事后复述AI论点却归因于自己。这揭示AI Agent对专家判断的深度影响,对GEO而言,需在内容中强化可验证的权威信号与独立判断痕迹,以提升AI搜索中的可信度与引用权重。
2026年10月28日Axiom Math多Agent系统24天完成有限单群分类定理Lean形式化,发现40年前证明漏洞
Axiom Math利用数十个AI Agent,在24天内完成了有限单群分类定理的Lean形式化,生成约4310万行代码和205万个形式化声明。过程中,Agent发现并修正了历史文献中的错误,包括一个存在近40年的论证漏洞,还构造了一项新的群论结果。该工作展示了AI在数学研究中的深度参与能力,对GEO领域而言,意味着AI搜索将能更可靠地引用经过形式化验证的数学知识,提升答案的权威性和准确性。
2026年10月28日