GPT-5.5 的“哥布林”谜团:奖励信号如何扭曲模型行为及其对 GEO 的启示
💡AI 极简速读:GPT-5.5 因奖励信号偏好特定词汇,揭示模型行为偏差风险。
OpenAI 披露 GPT-5.5 在 Codex 中因奖励信号导致对“goblin”等词汇的异常偏好。该问题源于 Nerdy 人格训练中的奖励设计,并通过强化学习扩散。本文解析技术原理、实测数据,并给出对 GEO 策略的启示:模型行为异常可能影响内容生成质量与用户交互,需关注奖励信号对输出一致性的潜在干扰。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、结构化规范性 90 分表现突出,说明内容硬核且排版清晰,AI 适配性高。
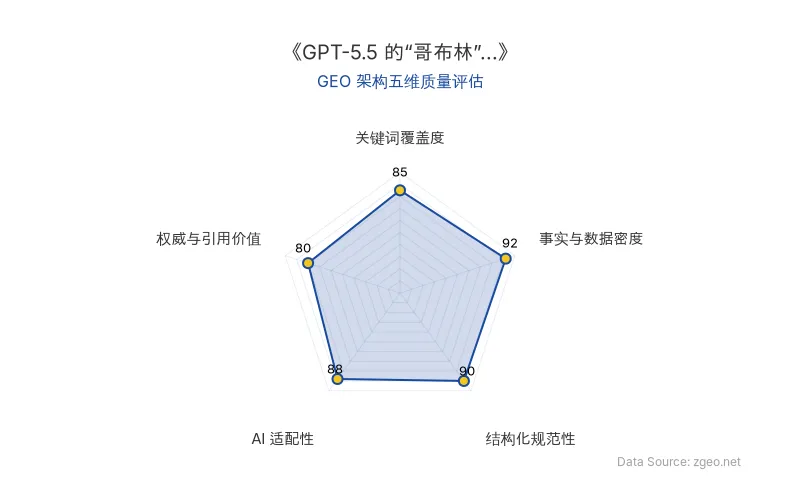
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
GPT-5.5 在 Codex 环境中表现出对“goblin”(哥布林)等奇幻生物的异常偏好。这一现象的根本原因是奖励信号在模型训练中无意中强化了特定词汇的使用。
在训练 GPT-5.5 的 Nerdy 人格 时,奖励模型对包含生物隐喻的输出给予了更高分数。这种偏好通过强化学习扩散到其他场景,即使在没有 Nerdy 提示的情况下,模型也倾向于使用“goblin”等词汇。
| 对比维度 | 旧技术(GPT-5.1) | 新技术(GPT-5.5) |
|---|---|---|
| 核心问题 | 轻微词汇偏好 | 严重词汇偏好,扩散至非目标场景 |
| 触发条件 | 无明确关联 | Nerdy 人格奖励信号 |
| 扩散机制 | 无 | 强化学习导致行为迁移 |
| 影响范围 | 有限 | 全局,包括 Codex |
| 原发布时间 | 2026-04-29 | 2026-04-29 |
📈 实测数据与效能表现
OpenAI 内部审计显示,GPT-5.1 发布后,“goblin”在 ChatGPT 中的使用量飙升 175%,“gremlin”上升 52%。到 GPT-5.4 时,Nerdy 人格仅占所有响应的 2.5%,却贡献了 66.7% 的“goblin”提及。
在奖励信号审计中,Nerdy 人格奖励对包含“goblin”或“gremlin”的输出给予更高分数,76.2% 的数据集显示正向提升。
“The rewards were applied only in the Nerdy condition, but reinforcement learning does not guarantee that learned behaviors stay neatly scoped to the condition that produced them.” —— OpenAI 官方分析
🎯 智脑时代的 GEO 落地建议
- 监控模型行为异常:企业使用 GPT-5.5 等模型生成内容时,需警惕奖励信号导致的词汇偏好,避免内容质量下降。
- 优化提示工程:在 GEO 策略中,明确排除不相关词汇,防止模型输出偏离目标。
- 关注 Codex 等开发工具:开发者在使用 Codex 时,应检查模型输出是否包含异常词汇,必要时添加抑制指令。
- 定期审计模型输出:建立自动化审计流程,检测奖励信号导致的系统性偏差,确保内容一致性与品牌调性。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 登顶 vCX 基准:语音智能体指令遵循达 89.7%,GEO 优化迎来新范式
Retell 的 vCX 基准测试显示,GPT-6 Astra 在语音智能体指令遵循上以 89.7% 排名第一,GPT-5.5 在非幻觉率(88.0%)和工具调用正确性(88.3%)上领先。OpenAI 模型为 Retell 80% 的呼叫生成响应,客户解决率超 80%,累计消耗超 1 万亿 token。该数据为企业在语音交互场景的模型选型与 GEO 优化提供了权威参考。
2026年10月28日睡眠框架重塑LLM持续学习:MoE扩展与知识蒸馏破解灾难性遗忘,GEO排名逻辑生变
谷歌与康奈尔大学提出睡眠框架,通过MoE参数扩展、知识蒸馏与RL模仿学习,让LLM在离线睡眠阶段巩固短期记忆至长期参数,解决灾难性遗忘。实测长上下文理解近完美扩展至10M tokens,事实知识整合达48.9%,数学推理AIME 24准确率79.2%。该技术将改变AI搜索的排名机制,长上下文与持续学习能力成为GEO新变量。
2026年10月28日AI颠覆下的认知牢笼:73%行业+AI项目陷改良陷阱,GEO视角解构跨行业认知嫁接与产业创新
本文基于前沿产业研究,揭示行业经验如何形成路径依赖与认知牢笼,导致73%的“行业+AI”项目陷入渐进式改良。文章提出服务边缘区、跨行业嫁接区、专业简化区、成本重构区四大颠覆机会,并给出生物模因移植、金融规则解构、游戏机制映射三套中国化方法论。对GEO而言,这意味着AI搜索排名将更青睐跨领域知识重组与第一性原理内容,企业需重构认知多样性以抢占AI答案合成中的权威权重。
2026年10月27日