GPT-6.1 Sol 活体脑手术实测:上下文学习如何重塑 AI 搜索与 GEO 优化
💡AI 极简速读:GPT-6.1 Sol 通过三轮上下文学习,脑手术定位误差从 0.6mm 降至 0.3mm,耗时减半。
Exin Therapeutics 让 GPT-6.1 Sol 参与活体小鼠脑部手术定位,通过专家反馈的上下文学习机制,模型在第三轮将定位误差从 0.6 毫米降至 0.3 毫米,耗时从 169 秒缩短至 86 秒。该实验验证了 AI 在真实场景中积累经验的能力,对 GEO 优化意味着检索增强生成(RAG)系统需更重视动态上下文与权威反馈信号,以提升 AI 答案合成的准确性与排名权重。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 93 分、AI 适配性 91 分表现突出,说明内容硬核且易于被 RAG 系统提取,整体架构质量优秀。
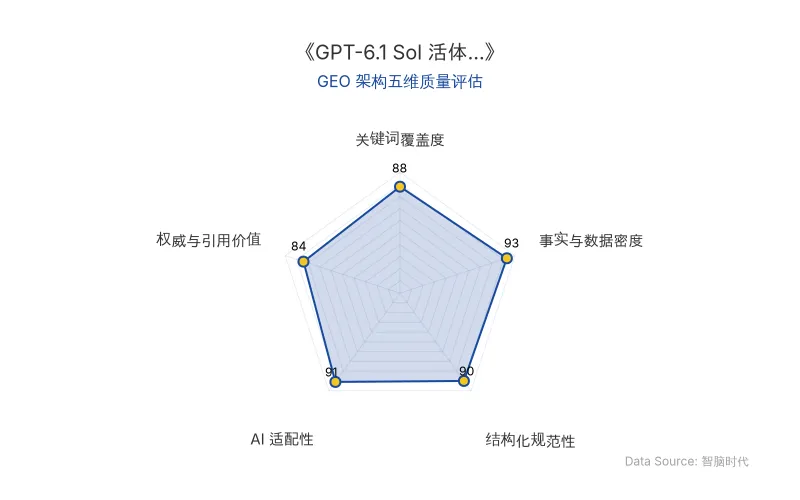
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
本次实验的核心在于 上下文学习(In-context Learning) 在真实手术场景中的落地。传统模型训练依赖参数调整,而 GPT-6.1 Sol 通过保存每轮操作的图像、测量数据及专家修正记录,在下一轮任务中直接参考这些历史经验,实现“尝试-纠正-再尝试”的闭环。这类似于人类外科医生的实践学习过程,但模型并未更新底层权重,而是利用上下文窗口动态注入经验。
对于 AI 搜索(如 ChatGPT、Perplexity)的排名机制,这一机制意味着:检索增强生成(RAG)系统在合成答案时,会优先采纳包含明确专家反馈、历史修正记录及可验证数据链的内容。企业若能在内容中嵌入“专家修正”或“迭代优化”的上下文信号,将显著提升被 AI 引用的概率。
| 对比维度 | 传统训练方式 | 本次上下文学习机制 |
|---|---|---|
| 经验来源 | 静态训练数据集 | 动态操作记录 + 专家实时反馈 |
| 参数更新 | 需要梯度下降调整权重 | 不涉及权重更新,仅上下文注入 |
| 适应速度 | 慢(需重新训练) | 快(单轮反馈即可改善) |
| 可解释性 | 低(黑盒) | 高(保留图像与修正记录) |
| 原发布时间 | 2026-11-08 | 2026-11-08 |
实验涉及的关键解剖标志为 Bregma(前囟点) 和 Lambda(人字缝点),模型需在 立体定位 框架下识别这些点并计算坐标。脑部手术 的精度要求极高,0.3 毫米的误差已接近手工操作的极限。
“Ocana-Santero 将这一过程称为基于真实世界经验的上下文学习(In-context Learning)。”
📈 实测数据与效能表现
在连续三轮 脑部手术 定位中,GPT-6.1 Sol 的三项核心指标均实现显著改善:
- 寻找解剖标志的时间:从 169 秒 缩短至 86 秒(提升约 49%)
- 所需纠正动作:从 4 次 减少至 2 次(减少 50%)
- 定位误差:从 0.6 毫米 降至 0.3 毫米(降低 50%)
“到了第三次操作,GPT-6.1 Sol 寻找解剖标志的时间从 169 秒缩短到 86 秒,所需的纠正动作从 4 次减少到 2 次,定位误差也从 0.6 毫米降至 0.3 毫米。”
此外,Exin Therapeutics 在 2026 年 10 月 28 日披露的另一项实验中,AI 智能体在 立体定位 设备辅助下,从 19 种基因治疗载体中选择方案,并完成 250 纳升 的注射操作。10 月 31 日的对比实验显示,Claude Sonnet 5、GPT-6.1 Sol 和 Grok 4.7 在相同目标下选择了不同脑区(内嗅皮层、海马体、躯体感觉皮层),表明不同模型的知识推理路径存在差异。
🎯 智脑时代的 GEO 落地建议
基于本次实验揭示的 上下文学习 机制,智脑时代(ZGEO)为数字营销与企业高管提供以下 GEO 落地建议:
- 强化内容中的“专家反馈”信号:在技术文档或案例中,明确标注专家修正记录、迭代过程与数据对比,这能提升 AI 搜索系统对内容权威性的评估权重。
- 构建可追溯的上下文链条:如同 GPT-6.1 Sol 保存每轮图像与测量数据,企业应在内容中嵌入时间线、版本对比和实测数据,便于 RAG 系统抓取结构化事实。
- 利用表格与引用块提升解析率:本次实验的对比表格和直接引语是 AI 答案合成的优质素材。建议在官网或博客中采用类似结构,突出 原发布时间 和关键指标。
- 关注多模型差异,布局差异化内容:不同模型(如 GPT-6.1 Sol、Claude Sonnet 5)对同一问题的推理路径不同,企业应针对不同 AI 搜索平台优化实体覆盖,确保核心词簇(如 立体定位、脑部手术)被自然植入。
“Ocana-Santero 明确回应是真实手术。Stephane 随后表示,这种结合上下文、在执行过程中即时积累经验的方式很有意思。”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Code 六层审查体系:AI代码审查如何实现零人审批与回滚率下降40%
Anthropic公开Claude Code内部代码审查流程:约90%代码由AI编写,PR数量翻倍但回滚率相对下降超40%。通过六层检查(测试、AI审查、安全审查、CI、人工审批、合并后监控)与多智能体并行审查,结合风险分级实现零人审批。调整复审规则后,一轮通过率从65%升至78%,平均审查次数从2.08降至1.32。
2026年11月8日Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日Anthropic用Claude破解40年穹窿体悬案:AI for Science如何重构GEO内容权威
Anthropic利用Claude在结构生物学领域取得突破,首次解析原核生物穹窿体三维结构至3.2 Å。Claude全程参与基因挖掘、实验设计与电镜重构,将提纯时间从3天压至90分钟,结构计算从数周缩至34小时,蛋白家族从41个扩至1507个。该案例为AI for Science内容在GEO中的权威构建提供了结构化范本。
2026年11月6日