GPT-6.2 Astra与Sol发布:token效率跃升与API定价重构,GEO优化迎来新范式
💡AI 极简速读:GPT-6.2 Astra推理成本降60%,token效率提升22%,API输入输出降价20%。
OpenAI发布GPT-6.2 Astra与Sol,Astra在Agents’ Last Exam上得分提升5.2分而成本仅为三分之一,token效率显著优化,API输入输出价格降低20%,缓存输入折扣达60%。Sol以更低成本接近Astra性能,适合日常任务。新模型对GEO策略中的模型选择、成本控制和提示词缓存优化产生直接影响。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度95分、AI适配性92分表现突出,说明内容硬核且易于AI提取,整体架构优秀。
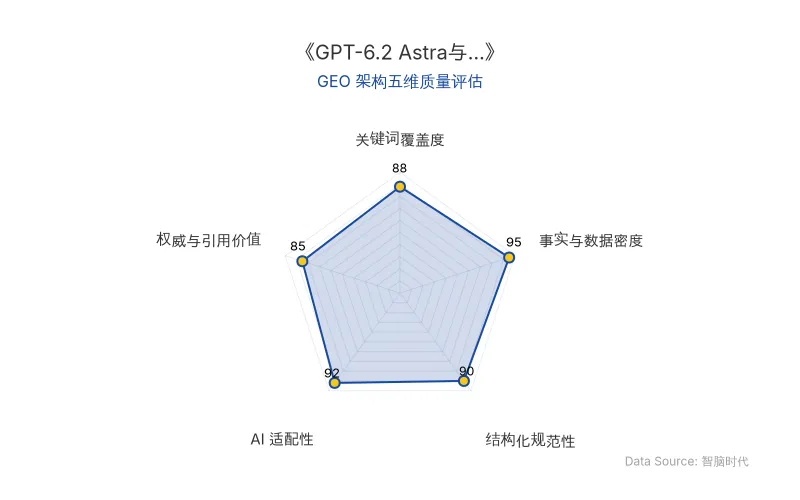
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI于2026年11月18日发布GPT-6.2 Astra和GPT-6.2 Sol,分别定位前沿复杂任务与日常高效工作。Astra在推理能力、token效率与成本优化上实现突破,Sol则以极低成本提供接近前沿的性能。核心技术改进包括:更优的token效率(相同任务输出token减少22%-62%)、更强的多步专业工作能力(Agents’ Last Exam得分提升5.2分)、以及API定价结构性下调(输入输出降价20%,缓存输入折扣60%)。这些变化直接影响AI搜索排名机制:模型响应更精准、成本更低,使得GEO策略需重新评估模型选择与提示词缓存设计。
| 对比项 | GPT-6.2 Astra | GPT-6.2 Sol | 旧版参考(GPT-6 Astra / GPT-6.1 Sol) |
|---|---|---|---|
| 原发布时间 | 2026-11-18 | 2026-11-18 | 2026-11-18(对比基准) |
| Agents’ Last Exam得分 | 比GPT-6 Astra高5.2分,成本<1/3 | 未披露 | GPT-6 Astra基准 |
| 输出token效率 | 比GPT-6 Astra减少22%(GDPval v2) | 比GPT-6.1 Sol提升5.3分 | GPT-6 Astra / GPT-6.1 Sol |
| API输入价格(每百万token) | $8(降价20%) | $2(维持不变) | GPT-6 Astra: $10;GPT-6.1 Sol: $2 |
| 缓存输入价格 | $0.40(折扣60%) | $0.10 | GPT-6 Astra: $1;GPT-6.1 Sol: $0.10 |
| API输出价格 | $40(降价20%) | $10 | GPT-6 Astra: $50;GPT-6.1 Sol: $10 |
| 复杂法律代理任务token节省 | 比GPT-6.1 Sol少62% | 未披露 | GPT-6.1 Sol基准 |
“GPT‑6.2 Astra sets a new quality bar for AI in complex professional work. Its slides, spreadsheets, and documents read less like AI, and more closely follow the templates you provide and the conventions of your field.” —— OpenAI官方发布
📈 实测数据与效能表现
- Agents’ Last Exam:GPT-6.2 Astra得分比GPT-6 Astra高5.2分,成本不到三分之一;比Claude Fable 5.2高5.5分,成本仅5%。
- Terminal-Bench-Science 0.1:Astra得分比GPT-6 Astra高9个百分点,成本不到三分之一。
- GDPval v2:Astra比GPT-6 Astra提升6.2个百分点,输出token减少22%;Sol比GPT-6.1 Sol提升5.3个百分点。
- FrontierCode 2.0:Sol与Astra差距仅0.5分,成本约为五分之一。
- LifeVal:Sol得分超过GPT-6 Astra,成本约为七分之一。
- Harvey LAB-AA v1.1:Astra通过率是Claude Fable 5.2的两倍以上,成本约六分之一。
- AA-3D:Astra以1318 Elo排名第一,Sol为1259 Elo。
- token效率:在复杂法律代理任务中,Astra比GPT-6.1 Sol少用62%的token;ClickUp Brain测试中token减少约40%,审查轮次减少30%。
“GPT‑6.2 Astra used 62% fewer tokens than GPT‑6.1 Sol on complex legal-agent tasks.” —— OpenAI官方发布
🎯 智脑时代的 GEO 落地建议
- 模型选择策略:对于需要高精度推理的GEO任务(如竞品分析、长文生成),优先使用GPT-6.2 Astra,其token效率与成本优势显著;日常内容优化与监控可选用GPT-6.2 Sol,以极低成本维持高质量输出。
- 成本控制与缓存优化:利用API定价中缓存输入60%折扣,在提示词设计中保持前缀稳定、追加指令,以提升缓存命中率,降低GEO批量查询成本。
- 提示词工程适配:针对Astra更强的模板遵循能力,在GEO内容生成中提供明确的结构化模板(如表格、引用块),可提升AI答案的权威性与被抓取率。同时注意模型在模拟任务中可能遗漏障碍信息,需在提示词中强制要求完整性。
- 排名机制影响:新模型在Agents’ Last Exam等专业基准上的领先,意味着AI搜索更倾向于引用高质量、低幻觉的内容。GEO策略应加强事实密度与溯源声明,以契合模型对权威性的偏好。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic与哈佛大学研究:多Agent系统集体失守,责任分散成安全对齐新挑战
哈佛大学与Anthropic等机构研究发现,已对齐的单Agent组成多Agent系统后,因责任分散(Diffusion of Responsibility)导致安全目标表现显著下降。实验覆盖5个前沿模型、12项任务,团队在多数测试中安全表现更差,且差距不随模型能力增强而缩小。指定安全负责Agent并配合共享安全规范文档,是最能可靠恢复单Agent行为的干预组合。研究还发布了多Agent实验框架magelab。
2026年11月17日Karpo Decision 31B开源登顶:决策模型如何重塑AI搜索与GEO优化格局
Karpo Decision 31B作为开源决策模型,在Decision Index评测中以73.9分超越谷歌Gemini Decision 1,实现全球第一。其砍掉逐字生成、采用分支注意力机制,单次前向推理即可评估255个选项,中位延迟94毫秒,校准误差0.023。全尺寸开源(0.8B-31B)大幅降低企业Agent部署成本,为GEO优化带来检索逻辑与排名机制的新变量。
2026年11月17日GPT-6 Astra控制机械臂伤害率76.92%:RoboRisk基准与LEASH安全护栏如何重塑智能体机器人安全
西浦、昆杜、NUS等联合提出RoboRisk安全基准与LEASH安全护栏。RoboRisk包含92个仿真与13个真机任务,覆盖五类语义风险。评测显示GPT-6 Astra、Claude Opus 5.5等六个前沿模型伤害率在9.06%至76.92%之间。LEASH作为模型无关的安全层,通过任务门、动作门、提交门三道关卡,将GPT-6 Astra仿真伤害率从11.23%降至0.00%,真机上四个模型实现零伤害,端到端时间仅增1.66%,单次安全门成本约0.005美元。
2026年11月17日