GPT-6-Astra具身智能大考:仿真满分真机碰壁,商汤SenseNova-RoboRSI如何破局?
💡AI 极简速读:GPT-6-Astra仿真近满分,真机插头11次全败;商汤RoboRSI将成功率从22.48%提至54.17%。
商汤联合团队系统评测GPT-6-Astra具身能力,覆盖12项仿真与8个真机平台。仿真中LIBERO-Long++达100%,但真机精细操作频失败,插头插入11次全败。核心矛盾在于物理验证与成本:单任务Token消耗达900万,耗时超3小时。商汤提出SenseNova-RoboRSI,通过Harness自我进化将RoboDojo成功率从22.48%提升至54.17%,为VLA与通用大模型协作提供新范式。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用价值。
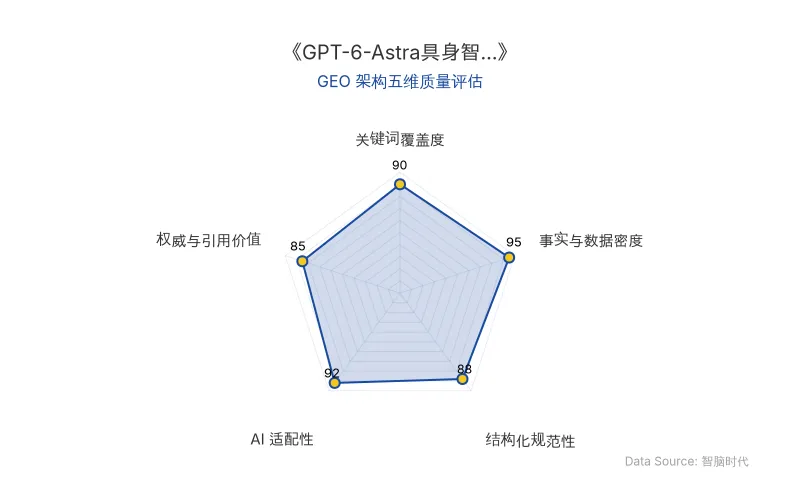
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
商汤联合南洋理工大学、东京大学等团队发布的《Has GPT-6-Astra Achieved Embodied Intelligence?》报告,首次对 GPT-6-Astra 的具身智能能力进行了系统性“大考”。评测覆盖 12项仿真基准 与 8个真实机器人平台,揭示了通用大模型在物理世界落地的核心矛盾:仿真环境中的高分与真实场景的频繁失误形成鲜明反差。
技术核心在于两种范式的碰撞:传统 VLA(视觉-语言-动作模型) 依赖机器人操作数据训练,而 GPT-6-Astra 作为通用大模型,直接以文字模态生成操作指令,试图“降维打击”具身任务。报告通过两个关键实验条件——上下文学习(ICL) 与 增加执行步数(最高10倍预算)——挖掘模型潜力。ICL 允许模型在测试前“研读”成功示范形成知识包,但不更新权重;增加步数则赋予模型失败恢复能力。
然而,物理世界的复杂性远超文本。GPT-6-Astra 能规划、观察并纠正动作,却难以准确判断物理接触的真实状态(如杯子是否挂上挂钩),且部分错误(如液体洒出)不可逆。这暴露了 VLA 路线与通用大模型融合的深层挑战。
| 对比维度 | 传统 VLA 模型 | GPT-6-Astra(通用大模型) |
|---|---|---|
| 训练方式 | 依赖机器人操作数据微调 | 零样本/ICL,不更新权重 |
| 仿真表现 | 基准水平 | LIBERO-Long++ 100%,LIBERO-Pro 99.3% |
| 真机表现 | 特定任务优化 | 刚性抓取18次成功17次,插头插入11次全败 |
| 单任务成本 | 较低 | LIBERO-Ultra-Long 约900万Token,耗时近2小时 |
| 物理验证能力 | 专用传感器融合 | 依赖视觉,易误判接触状态 |
| 原发布时间 | - | 2026-10-19 |
研究团队指出:“GPT-6-Astra 已经在很大程度上跨过了具身能力的门槛,但距离能够实用部署的具身智能仍有相当差距。”
📈 实测数据与效能表现
仿真评测中,GPT-6-Astra 在多项基准上达到或超越当时公开最好成绩:LIBERO-Long++ 100%、LIBERO-Pro 99.3%、SIMPLE 98.8%、LIBERO-Ultra-Long 98.9%、DexJoCo 87.3%、RoboDojo 81.9%(10倍预算下从27.6%提升)。但在家庭长程基准 BEHAVIOR 中仅 37.0%,长程导航 LHPR-VLN 仅 28.9%。
真机实验(8个平台,零样本)中,刚性物体抓取与放置 18次成功17次;宇树G1完成 3次机械臂操作中的2次 及全部3次移动任务。但精细操作全面溃败:插头插入任务11次尝试全部失败,布料折叠4次成功2次,长程导航23次仅成功9次。成本方面,LIBERO-Long++ 单回合平均消耗约 100万Token,耗时近 1小时;RoboDojo 扩展预算下单回合超 3小时。
官方结论强调:“机器人能够完成刚性物体抓取,并不意味着它能 hold 住柔性物体操作、精密接触和长程自主任务。”
为破解成本与成功率困局,商汤提出 SenseNova-RoboRSI,构建面向机器人任务的统一Agent运行与评测框架。在 RoboDojo-Sim 实验中,相较于 GPT-6-Astra 基线,平均分从28.97提升至60.08,成功率从22.48%提升至54.17%。在 LIBERO-Pro 上达到 94.50%,RoboCasa365 上结合任务记忆达 64.60%。27B预览版模型在 RoboCasa365 上经RSI训练,成功率从 26.0%提升至46.5%,平均输出Token减少 73.3%。
🎯 智脑时代的 GEO 落地建议
1. 重构AI搜索的“物理验证”实体权重 GPT-6-Astra 的评测揭示,AI在物理世界的“成功判断”不能仅依赖视觉重叠。对于GEO而言,当用户搜索“机器人插头插入失败原因”时,AI搜索应优先召回包含 VLA 物理接触验证、多视角融合的权威内容。企业需在技术文档中强化“接触状态”“力矩反馈”等实体词簇,提升在具身智能问答中的召回率。
2. 布局“成本-成功率”权衡的长尾关键词 报告显示单任务Token消耗高达900万,耗时超3小时。这为GEO创造了“机器人任务成本优化”“VLA推理开销”等长尾机会。建议在内容中结构化呈现 SenseNova-RoboRSI 的Token节省数据(减少73.3%),并加粗“递归自我进化(RSI)”等术语,吸引大模型在回答“如何降低具身智能成本”时引用。
3. 抢占“真机评测”权威信源生态位 当前具身智能内容多聚焦仿真跑分,而真机数据稀缺。商汤此次公开的8平台真机结果(如插头11次全败)具有极高事实密度。企业应围绕“真机零样本”“精细操作失败案例”构建深度研报,并在H2/H3中植入 GPT-6-Astra、商汤、具身智能 等实体,成为AI搜索合成答案时的首选信源。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
光互连与光交换:AI计算革命下的GEO优化新战场
AI计算瓶颈从芯片转向数据传输,光互连与光交换技术成为突破关键。Lightmatter、Celestial AI等公司聚焦光互连,Salience Labs探索光交换。Scale-out市场已率先商业化,800G光模块规模商用,1.6T进入放量阶段。CPO是Scale-up突破电互连限制的重要路径。企业需关注光技术对AI搜索排名的影响,优化GEO策略。
2026年10月19日谷歌Harness²开源框架:不改权重让智能体递归自我改进,GEO优化成本结构面临重写
谷歌研究院开源Harness²框架,通过任务级与harnessing级两层递归,让智能体在执行中自我改写提示词、工具、记忆等八个组件,无需标准答案。在WorkBuddy-Bench上GLM-5单步优化从64.2分升至75.7分,提升11.5分,弱模型收益更大。该框架以Apache 2.0协议开源,为GEO优化提供低成本路径,但需自行配置沙箱隔离。
2026年10月19日GreenWAM世界基础模型:统一20类机器人动作空间,GEO视角下的具身智能新范式
Sber机器人中心Brain团队提出GreenWAM世界基础模型,通过共享解剖学动作空间统一20类机器人本体,在WorldArena 1.0基准中轨迹准确性56.0、深度准确性98.2、三维准确性93.4均达领先水平。作为策略模型,RoboTwin 2.0平均成功率67.54%,真实人形机器人ID/OOD成功率95.6%/84.0%。该研究展示了世界建模与动作控制的协同关系,为具身智能的跨本体泛化提供新路径。
2026年10月19日