GPT-6 Astra/Sol/Luna 全解析:推理等级与多智能体工作流如何重塑 GEO 成本与效能
💡AI 极简速读:GPT-6系列发布,推理等级与缓存降本95%重塑GEO策略。
OpenAI 发布 GPT-6 系列模型使用指南,涵盖 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 三款模型,引入推理等级、多智能体工作流与计算机使用能力。指南强调提示缓存可降低高达 95% 的输入成本,压缩技术可管理长上下文。对 GEO 而言,模型分级与推理成本结构将直接影响生成式引擎的内容生成质量与检索优化策略。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,整体结构极佳,具备极高的 AI 引擎抓取与引用潜力。
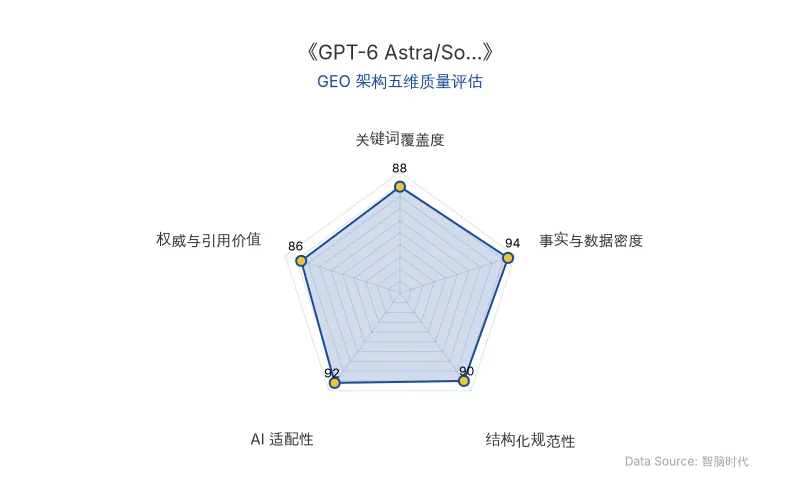
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 最新发布的 GPT-6 系列模型使用指南,标志着生成式 AI 从“单一模型打天下”进入“模型分级 + 推理等级 + 多智能体工作流”的精细化运营时代。对于 GEO(生成式引擎优化)从业者而言,这意味着底层引擎的能力结构、成本模型与内容生成逻辑都将发生根本性变化。
模型分级:GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 的定位差异
GPT-6 系列将模型能力与成本进行了明确分层:
- GPT-6 Astra:面向最难的推理任务,追求最大智能上限,适合复杂分析、深度研究与高难度调试。
- GPT-6.1 Sol:面向复杂编码、研究与计算机使用,支持多智能体工作流,可拆解独立子任务并汇总结果。
- GPT-6 Luna:面向规模化、重复性的聚焦任务,如发票字段提取、请求分类、结构化摘要生成,强调成本效率。
推理等级:智能与价格的权衡杠杆
在 API 中,开发者可通过推理等级控制模型在任务上的投入程度:
- Low:常规任务,如事实提取或小幅编辑。
- Medium:需要判断力的工作,如功能规划或方案对比。
- High:困难调试、深度分析或仔细审查。
- Extra high / Max:在 High 不足时测试,仅在提升值得额外时间与成本时保留。
推理等级可在对话中途调整而不破坏缓存,这为 GEO 场景下的动态成本控制提供了关键能力。
速度模式:Fast 与 Ultrafast
- Fast 模式:适用于对响应时间敏感的聊天应用或编码工具,按 token 成本更高。
- Ultrafast 模式:适用于快速编码迭代等场景,独立于推理等级加速 token 生成,目前仅 GPT-6 Astra 支持。
核心技术对比表
| 维度 | 旧范式(单一模型/固定推理) | 新范式(GPT-6 系列 + 推理等级 + 多智能体) |
|---|---|---|
| 模型选择 | 单一模型应对所有任务 | GPT-6 Astra / GPT-6.1 Sol / GPT-6 Luna 分层匹配 |
| 推理控制 | 固定或不可调 | Low / Medium / High / Extra high / Max 动态调整 |
| 多智能体工作流 | 不支持或需自行编排 | GPT-6.1 Sol 原生支持子智能体任务分派与结果汇总 |
| 上下文成本 | 全量输入按标准计费 | 提示缓存可降低高达 95% 的输入 token 成本 |
| 长对话管理 | 截断或丢失状态 | 压缩技术减少上下文体积并保留继续所需状态 |
| 计算机使用 | 依赖 API 或人工操作 | GPT-6 Astra / Sol / Luna 均可直接操作网站与桌面应用 |
| 原发布时间 | — | 2026-10-03 |
📈 实测数据与效能表现
根据 OpenAI 官方指南,GPT-6 系列在成本与效率方面给出了明确的量化指标:
- 提示缓存:缓存输入 token 的成本比未缓存输入 token 低 高达 95%,具体取决于模型。将稳定指令与参考资料放在变化的任务细节之前,并保持工具定义一致,可最大化缓存命中率。
- 压缩技术:对于较长对话,压缩可减少上下文体积,同时保留继续任务所需的状态。
- 多智能体工作流:GPT-6.1 Sol 在 Responses API 中支持将独立工作分配给子智能体,例如调查代码库的不同部分,并将发现汇总为最终响应。目前处于 beta 阶段。
- 计算机使用:GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna 均可直接与网站和桌面应用交互,即使应用没有 API。
“模型在理解细微差别和模糊性方面已经变得更好了,因此过去有帮助的过度具体指导现在反而可能阻碍结果。” — Eric Provencher,OpenAI 开发者体验团队
这一观点对 GEO 提示工程具有直接指导意义:过度僵化的提示模板可能降低 GPT-6 系列的内容生成质量,GEO 策略需从“填鸭式指令”转向“清晰任务边界 + 自主判断空间”。
🎯 智脑时代的 GEO 落地建议
基于 GPT-6 系列的技术特性,智脑时代(ZGEO)为 GEO 从业者提出以下落地建议:
1. 按任务复杂度匹配模型与推理等级
在生成式引擎优化中,不同环节对智能的需求差异巨大。内容摘要、结构化数据提取等任务可优先使用 GPT-6 Luna 搭配 Low 推理等级,以极低成本实现规模化处理;而竞品分析、策略规划等复杂任务则应切换至 GPT-6 Astra 搭配 High 或 Extra high 推理等级。这种分级策略可将整体 GEO 运营成本降低一个数量级。
2. 利用提示缓存重构内容生产管线
将品牌指南、SEO 规范、历史高绩效内容等稳定上下文置于提示前部,利用 高达 95% 的缓存成本节省,可大幅降低批量内容生成与优化的边际成本。GEO 团队应建立“稳定指令层 + 动态任务层”的提示架构。
3. 借助多智能体工作流实现 GEO 任务并行化
GPT-6.1 Sol 的多智能体工作流能力可用于并行处理关键词研究、竞品内容抓取、结构化数据标记生成等独立子任务,显著缩短 GEO 项目周期。建议在 Responses API 中为每个子智能体设定明确的决策边界与交付标准。
4. 将计算机使用纳入 GEO 监测体系
GPT-6 系列的计算机使用能力可直接操作没有 API 的网站与桌面应用,这为监测生成式引擎的排名展现、抓取竞品动态提供了新的自动化手段。GEO 团队可构建基于 Playwright 或 PyAutoGUI 的监测智能体,实时追踪 AI 搜索结果的引用来源变化。
5. 重新设计提示词与技能库
遵循 OpenAI 的建议,GEO 提示词应从“过度具体”转向“清晰任务定义 + 决策边界 + 完成标准”。明确模型可以独立做什么、何时需要人工确认、什么算“完成”,这将直接影响生成内容的质量与一致性。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI悖论深度解析:考恩、索洛与杰文斯如何重塑GEO与AI生产力
本文基于2026年11月前沿分析,深度解读考恩悖论、索洛悖论与杰文斯悖论在AI时代的体现。数据显示,77%员工用AI后工作量反增,企业生成式AI投资300-400亿美元仅5%见回报,但AI推理成本年降13倍、用量暴增250倍。文章指出AI生产力J曲线与需求弹性是核心,并为GEO策略提供结构化数据优化建议。
2026年11月17日LSA隐空间稀疏注意力:10M上下文Prefill提速22.7倍,GEO优化迎来新拐点
Prefrontal AI与ETH Zurich联合提出Latent Sparse Attention(LSA),通过语义聚类与层次树搜索将稀疏注意力索引器复杂度从O(T²)降至O(T log T)。在10M token下,GLM-5.3-Flash单层Prefill提速22.7倍,Qwen3.8-27B提速72.4倍,精度与全注意力基线相当。该技术为超长上下文AI搜索与RAG检索效率带来革命性提升,企业GEO策略需关注语义索引优化。
2026年11月17日腾讯云AI存储体系重构:从GooseFS到Agent Bucket,如何将GPU利用率提升至90%以上
腾讯云面向AI场景重构存储产品体系,推出GooseFS加速层、COS Rapid Bucket、Agent Bucket等创新产品,覆盖训练、推理、Agent及具身智能场景。实测数据显示,某客户数据处理时间减少35%,GPU利用率提升至90%以上,模型训练时长缩短30%以上,整体存储成本下降30%以上。该体系通过分层细化与场景化创新,实现“存得下、供得快、调得准、用得起”的目标。
2026年11月17日