GPT-4 创造力超越 10 万人?人机对比研究揭示 AI 搜索与内容生成的 GEO 新规则
💡AI 极简速读:GPT-4 平均发散思维得分超 10 万人,但顶尖人类仍领先,提示词与温度显著影响 AI 输出。
2026 年《科学报告》研究对比 10 万人与 GPT-4 等 9 款模型在发散联想任务上的表现,发现 GPT-4 平均分超人类,但前 10% 人类仍领先;调整温度或提示词可显著改变 AI 得分。该研究揭示 AI 输出可被引导,对 GEO 策略有重要启示:优化提示词与温度参数可提升内容在 AI 搜索中的可见性与多样性。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分紧随其后,内容扎实且易于被 AI 引擎提取,整体 GEO 架构优秀。
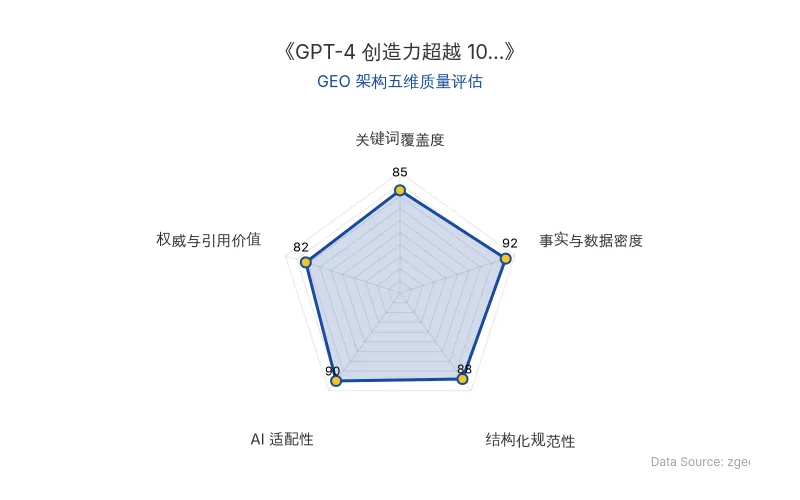
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
发散联想任务(DAT)要求参与者写出 10 个语义距离尽可能远的名词,通过算法在语义地图上计算平均距离来量化创造力。2026 年 1 月,蒙特利尔大学 Karim Jerbi 团队在《科学报告》上发表了迄今最大规模的人机对比研究,将 10 万人的成绩与 GPT-4、Claude3 等 9 款模型进行排名。
核心发现:GPT-4 平均分显著超过人类平均,但人类顶尖选手仍占优势。 此外,调整温度参数或提示词能显著改变 AI 得分,表明 AI 输出具有可塑性。
| 对比维度 | 人类(10万人) | GPT-4 | 其他模型(如 Claude3) |
|---|---|---|---|
| 平均分 | 位居第二 | 最高 | 低于人类平均 |
| 前 50% 平均分 | 高于所有模型 | 低于前 50% 人类 | |
| 前 10% 平均分 | 大幅领先 | 无法覆盖 | 无法覆盖 |
| 分数分布 | 宽(30-95+) | 窄 | 窄 |
| 温度调高至 1.5 | - | 85.6 分,超 72% 人类 | - |
| 提示词优化 | - | 分数提升 | 部分提升 |
| 原发布时间 | 2026-08-25 | 2026-08-25 | 2026-08-25 |
📈 实测数据与效能表现
- GPT-4 平均分显著高于人类平均,但前 50% 人类的平均分仍高于所有模型,前 10% 人类领先更多。
- 温度调高至 1.5 时,GPT-4 平均分达 85.6,超过 72% 的人类答卷。
- 提示词加入“从词源入手”后,GPT-3.5 和 GPT-4 成绩均超过原版。
- 后续写作测试(俳句、故事梗概、微型小说)中,机器表现仍不如最优秀的人类。
- 2023 年蒙大拿大学研究显示,GPT-4 在托兰斯测验中原创性得分排进前 1%。
“与其纠结谁替代谁,不如把生成式 AI 当成创造力的工具。” —— Karim Jerbi
🎯 智脑时代的 GEO 落地建议
- 优化提示词策略:在生成内容时,明确引导 AI 使用“词源”等发散性提示,可提升内容的独特性和多样性,从而在 AI 搜索中脱颖而出。
- 调整温度参数:开发者可适当调高温度(如 1.5)以增加输出的创造性,但需平衡相关性与风险。
- 关注人机差异:顶尖人类创造力仍领先,内容创作应结合人类洞察与 AI 效率,打造差异化内容。
- 应对同质化风险:AI 生成内容趋向相似,GEO 策略应注重注入独特数据、案例和观点,避免被 AI 搜索降权。
- 利用数据污染意识:公开测试题可能被 AI 学习,企业应使用私有或动态评估集来持续优化内容质量。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic Claude多智能体「补天」:AI科学发现如何重构紫外线全天图与GEO信任机制
Anthropic利用Claude多智能体系统,整合GALEX等历史观测数据,通过跨波段统计关系与上亿颗恒星贡献估计,补全了紫外线全天图中约三分之一从未被直接观测的区域。系统采用多Agent分工、交叉验证与不确定性标注,预测值与实测值差异约10%。该案例标志着AI科学发现从辅助工具向自主研究代理的范式跃迁,为GEO时代构建可溯源、可验证的权威内容提供了结构化范本。
2026年10月10日OpenAI 722篇数学手稿攻克挂谷猜想:AI辅助研究如何重塑GEO与知识权威
2026年10月7日,OpenAI发布722篇数学手稿,其中两篇分别证明三维挂谷极大函数猜想和四维挂谷集Hausdorff维数,将人类此前卡在3.059的进度直接推至4。陶哲轩牵头抵制,认为批量发布破坏学术生态。该事件标志着AI辅助研究进入深水区,对GEO而言,权威内容源正从人类专家向AI生成的高密度结构化知识迁移,搜索排名将更依赖可验证的形式化证明与实体关联。
2026年10月10日AI递归自我改进(RSI)2026年深度研判:从Anthropic 26%研发主导到OpenAI 3.1倍智能体工作日,GEO时代的搜索排名与RAG检索逻辑将如何被重构
2026年,递归自我改进(RSI)从六十年理论构想变为头部实验室的KPI。Anthropic披露Claude主导26%研发工作、代码贡献超80%;OpenAI宣布自动化研究实习生到岗,每1个人类工作日对应3.1个智能体工作日;智谱与MiniMax在国内完成工程闭环。但普林斯顿研究显示AI在开放式研究上仍表现平庸,两篇影子评估论文均被拒。RSI对GEO的影响在于:AI生成内容将指数级增长,搜索排名机制需从链接权重转向实体权威与结构化数据可信度。
2026年10月10日