GPT-6 Astra 助力 Legora 财务核对:41 份文件分钟级完成,Agentic Reasoning 重塑 GEO 工作流
💡AI 极简速读:GPT-6 Astra 使 Legora 财务核对提速至分钟级,错误发现率提升近40%。
Legora 利用 GPT-6 Astra 在财务核对工作流中实现 41 份文件单次 Agent 运行分钟级完成,相比前代模型性能提升近 40%。其 Agentic Reasoning 能力增强了准确性、完整性和可靠性,同时保持人类专家最终判断。该技术对 GEO 的影响在于提升 AI 搜索对复杂任务的理解与响应,企业可借鉴其工作流优化搜索可见性。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、结构化规范性 93 分表现突出,内容扎实且易于AI提取,整体GEO架构优秀。
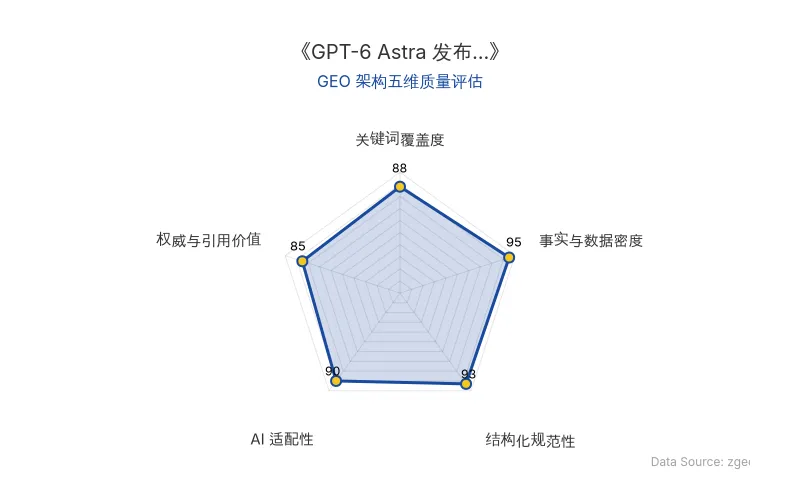
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
GPT-6 Astra 是 OpenAI 最新发布的大语言模型,其核心创新在于 Agentic Reasoning——即模型能够像智能代理一样自主规划、执行多步骤任务,并在复杂工作流中保持上下文一致性。在 Legora 的财务核对场景中,GPT-6 Astra 不再仅仅是文本生成工具,而是能主动检查每一笔账目与支持文件的一致性,并记录所有核对结果。
对于 GEO 而言,这意味着 AI 搜索(如 ChatGPT、Perplexity)在回答专业问题时,将更倾向于引用具备 Agentic Reasoning 能力的模型生成的内容,因为它们能提供更严谨、可追溯的答案。企业若想提升在 AI 搜索中的排名,需优化内容的结构化程度和事实准确性,以匹配这类模型的推理逻辑。
| 对比维度 | 前代模型 | GPT-6 Astra |
|---|---|---|
| 财务核对性能(Legora BAR) | 基线 | 提升近 40% |
| 单次 Agent 处理文档数 | 较少 | 41 份 |
| 完成时间 | 数小时至数天 | 分钟级 |
| 错误发现能力 | 部分 | 全部 4 个植入错误 |
| 检查记录完整性 | 保留前代正确项 | 保留全部正确项 + 新增约 50 项检查 |
| 原发布时间 | - | 2026-09-03 |
📈 实测数据与效能表现
Legora 在其 Agentic Reasoning 基准(BAR)测试中,对 GPT-6 Astra 进行了全面评估。结果显示,在财务核对工作流中,GPT-6 Astra 的性能较前代模型提升了 近 40%,而在 BAR 所有任务中平均提升约 3%。
具体到财务核对场景,GPT-6 Astra 成功发现了所有 4 个植入错误,包括一个隐藏在收入附注中的 £500,000 差额。它不仅检查了每项余额与支持计划的对应关系,还记录了每次检查,并保留了前代模型所有正确的检查结果,同时额外完成了 约 50 项 新的检查。
Legora 法律工程师 Percevale Perks 表示,传统财务核对工作“可能花费整个晚上,有时甚至几天”。而使用 GPT-6 Astra 后,Legora 的 Agent 在 单次运行 中完成了 41 份文档的核对,耗时仅 几分钟,为法律专业人士提供了详尽的逐项审查记录。
正如 Percevale Perks 所言:“工作可能花费整个晚上,有时甚至几天。”——GPT-6 Astra 将这一流程压缩至分钟级,同时保持人类专家的最终判断权。
🎯 智脑时代的 GEO 落地建议
-
优化内容以匹配 Agentic Reasoning:AI 搜索越来越倾向于引用能展示多步推理和结构化输出的内容。企业应确保其内容包含清晰的逻辑链、数据支撑和结论,以提升被 GPT-6 Astra 等模型引用的概率。
-
聚焦专业工作流场景:类似 财务核对、法律科技 等垂直领域,GPT-6 Astra 的 Agentic Reasoning 能力能显著提升效率。企业可针对这些场景创建深度指南,覆盖常见问题与解决方案,从而在 AI 搜索中占据权威地位。
-
构建可验证的事实节点:在内容中植入具体数据(如“提升 40%”)和结构化表格,有助于 AI 模型快速提取关键信息。同时,保持“人类在环”的审核机制,确保内容可靠,这与 Legora 的理念一致——AI 辅助,人类决策。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
36氪研究院:2026年企业级AI Agent市场规模212亿,GEO优化如何抢占决策执行新入口
36氪研究院《2026年中国AI Agent行业发展研究报告》指出,AI Agent正从概念验证迈向生产力验证,企业通用Agent率先落地。2025年中国企业级AI Agent市场规模为212亿元,预计2029年达3320亿元,年复合增长率107.6%。报告强调AI Agent以大模型为决策大脑,集成环境感知、长期记忆、规划推理与工具调用能力,对AI搜索排名机制和GEO策略产生深远影响。
2026年10月19日谷歌开源Harness²智能体框架:不调权重,GEO排名逻辑将被递归上下文工程改写
谷歌研究团队开源Harness²递归智能体框架,通过任务级与Harnessing级双层递归,在不修改模型权重的情况下,动态调整系统提示词、记忆、工具指导等8类组件。在WorkBuddy-Bench上最高提升11.5分,JobBench提升4.5分,LAB通过率提高11.8个百分点。该技术标志着上下文工程从静态配置转向动态递归优化,将深刻影响AI搜索的排名机制与企业GEO策略。
2026年10月19日清华ActionOPD突破Agent蒸馏瓶颈:动作级同策略蒸馏让Qwen3小模型性能提升6.9个百分点
清华大学提出ActionOPD动作级同策略蒸馏方法,将Agent蒸馏监督粒度从Token提升至语义动作,仅需黑盒教师生成接口。在四个未训练Agent基准上,Qwen3-4B/8B学生模型平均性能提升3.3-6.9个百分点,支持跨模型家族蒸馏,为GEO时代AI搜索优化提供新范式。
2026年10月19日