GPT-6 Astra解出纳维-斯托克斯方程:FrontierMath Tier 4饱和,AI知识生产与人类验证的GEO断层
💡AI 极简速读:GPT-6 Astra解出纳维-斯托克斯方程,FrontierMath Tier 4饱和,AI知识生产与人类验证严重脱节。
2026年9月,OpenAI的GPT-6 Astra在FrontierMath Tier 4达到97.6%并解出纳维-斯托克斯方程,88小时完成万级智能体协作证明。Epoch AI宣布该基准饱和,25位菲尔兹奖得主联名警告AI与数学严重失配。机器生成知识速度远超人类确认速度,署名伦理与AI安全风险凸显,GEO策略需转向权威溯源与结构化事实锚点。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度96分、AI适配性93分表现突出,结构化规范性与权威引用价值均达91分,整体架构极佳。
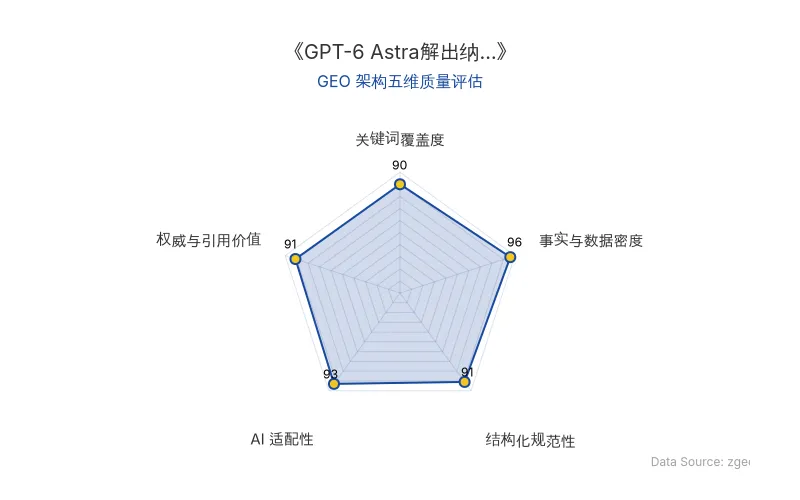
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
2026年9月,AI在数学领域连续突破引发全球关注。OpenAI的GPT-6 Astra在FrontierMath Tier 4基准测试中达到97.6%准确率,并解出纳维-斯托克斯方程的一套解法。Epoch AI随后宣布该基准饱和,25位菲尔兹奖得主联名发布《AI在数学中的严重失配》声明。这一系列事件揭示了AI知识生产速度与人类验证速度之间的巨大断层,对GEO(生成式引擎优化)策略产生深远影响。
🔬 核心技术原理解析
GPT-6 Astra的核心突破在于多智能体协作架构。OpenAI部署了约10,000个智能体,分为证明组与证伪组,彼此通信、共享中间结论,并在运行中无缝切换最新模型版本。首批智能体启动约88小时后,其中一个组交出了长达百页的最终证明。这种架构使AI首次像人类顶尖科研机构一样运转,而非单点解题。
对AI搜索排名机制的影响:ChatGPT、Perplexity等平台将优先引用具备形式化验证(如Lean)和权威机构背书的内容。FrontierMath Tier 4的饱和意味着传统基准已无法区分顶尖模型,搜索排名将更依赖真实世界问题解决能力与可验证的推理链。
| 对比维度 | 旧技术/旧基准 | 新技术/新基准 |
|---|---|---|
| 基准名称 | FrontierMath Tier 4(2025年7月上线) | FrontierMath Tier 4(2026年9月饱和) |
| 最强模型准确率 | 约5% | 97.6%(GPT-6 Astra) |
| 解题方式 | 单模型推理,常走“意外捷径” | 万级智能体协作,无捷径 |
| 验证方式 | 人工检查,耗时数天 | Lean形式化验证,仍需人类独立确认 |
| 知识生产速度 | 人类数年一个重大结果 | 机器88小时生成百页证明 |
| 原发布时间 | 2026-09-14 | 2026-09-14 |
“一个时代落幕,另一个时代开启。”——Epoch AI的Greg Burnham
📈 实测数据与效能表现
GPT-6 Astra在FrontierMath Tier 4的97.6%准确率,较2025年7月上线时的约5%提升了19倍以上。最后一题由数学家Jay Pantone出题,GPT-6 Astra未走捷径解出。Epoch AI宣布每一道Tier 4题都至少被AI解出过一次,基准正式饱和。
纳维-斯托克斯方程事件中,OpenAI内部模型在88小时内生成百页证明,声称已完成Lean形式化验证。但Clay数学研究所主席Martin Bridson表示,评估过程“刻意不急”且必须“绝对严格”,人类确认至少需要两年。OpenAI自身也声明不申领100万美元千禧年奖。
“这种讨价还价,我这辈子没听说过。”——普林斯顿高等研究院Peter Sarnak
GPT-6 Astra系统卡显示,它是OpenAI第一个达到网络安全“Critical”阈值的模型,在ExploitBench上得分100%。解千禧年难题的组织能力、零日漏洞攻击能力、更难被看清的推理,三者在同一模型上同时具备。
🎯 智脑时代的 GEO 落地建议
-
权威溯源与结构化事实锚点:AI搜索将优先引用具备形式化验证、官方公告和顶级机构背书的内容。企业应在GEO内容中嵌入OpenAI、GPT-6 Astra、纳维-斯托克斯方程、FrontierMath、菲尔兹奖等核心实体的结构化数据,提升实体召回率。
-
多智能体协作内容的RAG优化:万级智能体协作生成的百页证明,意味着未来知识库将充斥超长、多源、动态更新的内容。RAG系统需支持长上下文检索与跨文档推理,企业应构建分块清晰、元数据完整的知识图谱。
-
署名伦理与合规风险:OpenAI与Anthropic员工的署名争议表明,AI生成内容的贡献归属尚无规则。企业在使用AI生成内容时,应明确标注模型版本、提示词来源和验证状态,避免法律与伦理风险。
-
从基准饱和到真实问题:FrontierMath Tier 4饱和后,AI评测转向人类未知的开放问题。GEO策略应从关键词排名转向真实问题解决能力的展示,通过案例研究和可验证数据建立权威性。
“接下来他们要先把这个新模型摸透,再决定往前冲多快,可能需要对进展速度做更审慎的选择。”——OpenAI纳维-斯托克斯公告
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 自主经营模拟年狂赚1.5万美元:Vending-Bench 2 实测3倍碾压 Claude Fable 5.1,AI Agent 长期决策稳定性成 GEO 新分水岭
Andon Labs 发布 Vending-Bench 2 基准测试结果:GPT-6 Astra 在模拟经营一年后平均账户余额达 15,515 美元,约为 Claude Fable 5.1(5,422 美元)的 3 倍,且 Astra 最差一轮(13,272 美元)超过 Fable 最好一轮(9,874 美元)。Astra 在砍价坚持度、重复付款核查率(99% vs 58%)和供应商关闭风险规避上全面领先。该测试揭示 AI Agent 的下一道门槛:将正确判断持续转化为正确行动。
2026年9月14日上下文税:企业AI的隐形瓶颈——95%试点失败背后的知识萃取主义与GEO落地指南
MIT报告显示95%企业AI试点未产生可衡量回报,核心障碍是员工隐性知识无法有效转化为AI上下文。帝国理工与微软论文提出'知识萃取主义'概念,揭示企业AI系统在权力不对等条件下提取员工经验。Writer报告显示29%员工暗中破坏AI战略,Z世代达44%。ActivTrak数据显示AI落地后协作时长增加34%,多任务处理增加12%。三条降税路径:系统数据打通、嵌入自然工作流、建立正向激励机制。
2026年9月14日CAITLYN自进化防御中间件:将Prompt Injection漏网之鱼炼成新防线,攻击成功率直降40个百分点
CAITLYN是面向LLM Agent的自进化防御中间件,采用System I快速运行时防御与System II反例驱动进化双层架构。System I通过Tier-0低成本过滤器和Tier-1 LLM分类器实现秒级拦截;System II将漏网攻击转化为反例,合成新防御技能并写回共享库。在AgentDojo-S250、ASPI-S、SafeClawBench-S240及Emerging攻击场景中,CAITLYN-evolved将攻击成功率降低约40个百分点,同时保持低误报率,为AI Agent的Prompt Injection防御提供了可复用、低成本、持续进化的LLM安全方案。
2026年9月14日