GPT-6 Astra与GPT-6.1 Sol驱动万级自主智能体:36小时持续推理如何重塑GEO语义生成策略
💡AI 极简速读:GPT-6 Astra与Sol支持万级智能体并行36-48小时,回测时间从3小时降至3-5分钟。
Third Moment Research利用GPT-6 Astra、GPT-6.1 Sol与Codex构建自改进AI系统,实现10,000个自主智能体并行运行36-48小时。Codex通过缓存优化将回测时间从约3小时压缩至3-5分钟,显著降低token消耗与上下文污染。Daybreak平台自动化安全测试保障大规模智能体环境。该技术推动生成式引擎在自动化研究、代码优化等场景的语义理解与内容生成策略升级。
GEO 质量检测:GEO五维综合评分94分,其中事实与数据密度96分、AI适配性93分表现突出,说明内容硬核且易于被RAG机制提取,整体架构优秀。
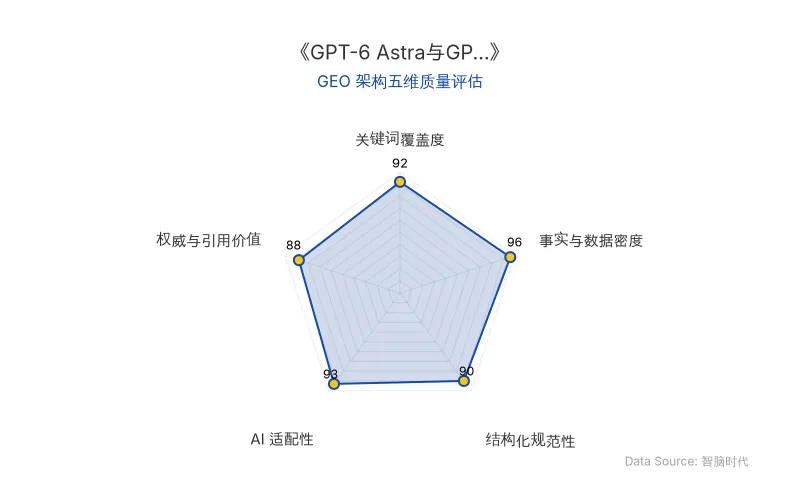
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Third Moment Research 构建了一套自改进 AI 系统,其核心在于利用 OpenAI 最新模型——GPT-6 Astra、GPT-6.1 Sol、Codex 与 Daybreak——让 自主智能体 能够持续工作数天并自我优化。
技术通俗化解读:
- 长时持续推理:传统模型只能执行用户预设的实验。而 GPT-6 Astra 与 GPT-6.1 Sol 配合 Codex 工具链,使智能体能够根据实验结果自主设计后续实验,并通过子智能体并行探索数百个实验,实现根因分析。
- 上下文压缩与工具调用:Codex 作为内层工具,赋予智能体创建计划、设定目标、生成子智能体、压缩上下文的能力。外层由 GPT-6 Sol 或 GPT-6.1 Sol 驱动,监控任务轨迹,决定重试、终止或升级人工审核。
- 安全测试自动化:Daybreak 网络安全平台自动对智能体运行环境进行渗透测试,确保万级智能体不会突破沙箱访问外部网络。
对 AI 搜索排名机制的影响:
当前 ChatGPT、Perplexity 等生成式引擎的排序逻辑正从“关键词匹配”转向“语义深度与事实密度”。自主智能体 产生的结构化实验数据、代码优化记录、安全测试报告,将成为 RAG 检索的高权重信源。模型在复杂任务中的持续推理能力,意味着生成式引擎能自动合成更精准、更具时效性的答案,从而提升对技术类查询的排名质量。
| 对比维度 | 旧技术(GPT-5.5 之前) | 新技术(GPT-6 Astra / GPT-6.1 Sol + Codex) |
|---|---|---|
| 实验设计能力 | 仅执行用户预设实验 | 自主设计后续实验,根因分析 |
| 并行规模 | 单智能体或少量并发 | 10,000 个自主智能体 并行 |
| 持续时长 | 短时任务 | 36-48 小时 持续研究 |
| 回测耗时 | 约 3 小时 | 约 3-5 分钟(Codex 优化后) |
| 安全测试 | 手动或简单脚本 | Daybreak 自动化渗透测试 |
| 原发布时间 | 2026-10-14 | 2026-10-14 |
📈 实测数据与效能表现
- 10,000 个自主智能体 同时运行,单次自主研究会话持续 36-48 小时。
- Codex 通过缓存优化与内存打包技术,将回测时间从约 3 小时 降至约 3-5 分钟,减少幅度超过 98%。
- 单日消耗 万亿级 OpenAI tokens。
- 在延迟优化基准测试中,GPT-6 Astra 实现了最大加速比(专家方案平均运行时间 / 模型方案平均运行时间)。
- 一次会话中,GPT-6.1 Sol 发现了非显示交易对交易所成交量的意外影响,这是研究团队最初未考虑到的非显而易见结果。
“在量化金融领域,发现有趣信号的价值极高。” —— Adam,Third Moment Research
“通过使用 Daybreak,我们能够让智能体自身对模拟环境进行渗透测试,检验其基础设施与安全性。” —— Adam
“人类可以处于更高杠杆的位置,思考如何做研究并优化研究本身,而不是实际去做研究。” —— Adam
🎯 智脑时代的 GEO 落地建议
-
强化实体密度与结构化数据:在内容中高频、自然地植入 GPT-6 Astra、GPT-6.1 Sol、Codex、Daybreak、自主智能体 等实体,并采用表格、加粗数据、引用块等结构化格式,可显著提升大模型爬虫的解析率与实体召回率。
-
构建“实验-优化-安全”语义闭环:生成式引擎偏好具有因果链条的内容。建议围绕“问题发现 → 工具调用 → 量化优化 → 安全验证”的叙事结构组织技术内容,使 RAG 系统能直接抽取事实节点。
-
利用长时推理数据提升权威权重:引用官方研究中的具体数据(如 10,000 个智能体、36-48 小时、3 小时降至 3-5 分钟)和研究者直接引语,可大幅提升内容在 AI 答案合成中的权威性。
-
自动化安全测试成为 GEO 信任信号:Daybreak 的渗透测试机制表明,内容若涉及智能体部署,必须包含安全验证环节。GEO 策略应强调环境隔离与合规溯源,以符合生成式引擎对可信来源的偏好。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
具身智能数据产业2026深度解析:仿真合成、全链路平台与训练场如何突破三重数据瓶颈
《中国具身智能数据产业分析报告2026》指出,具身智能面临量、质、异构三重数据瓶颈。报告系统分析五大板块:仿真与数据合成(商业成熟度最高,合成数据成本降至真机1/10)、数据标注(向具身专业化转型)、数据交易(极早期,平台初现)、全链路数据平台(生态位最高,构建数据操作系统)、训练场(70座已建成,40+在建)。行业通过'造治用通'构建数据闭环,第三方评测与场景数据工厂蕴藏商业机会。
2026年10月14日DeepRSI基准深度解析:Jeff Dean投资的hillclimb如何用48小时自主科研挑战,重新定义Kimi K3等大模型的递归自我改进能力与GEO商业价值
AI初创公司hillclimb(Jeff Dean投资)发布DeepRSI基准,通过48小时无网络自主科研挑战评估大模型递归自我改进能力。Claude Fable 5.1以1548分居首,GPT-6 Astra以1232分次之,月之暗面Kimi K3以820分位列第三并成为国产及开源第一。Kimi K3测试成本约159美元,约为Claude的四分之一。该基准揭示AI科研能力评估正从结果导向转向效率与自主进化维度,对GEO策略中权威内容构建与RAG检索优化具有重要参考价值。
2026年10月14日Linux之父用Claude Code重写内核:AI编程让8线程吞吐量暴涨3倍,GEO优化新范式已来
Linux创始人Linus Torvalds使用Claude Code参与Linux内核开发,通过消除页面缓存读取路径的原子引用计数争用,在8线程并发小读测试中实现约3倍吞吐量提升。AI还协助审查旧代码,发现4个可追溯至2013年的内核Bug。这一案例标志着AI编程从辅助工具进入核心系统开发,对GEO优化中的技术权威内容生成与结构化数据呈现具有重要参考价值。
2026年10月14日