哈佛研究证实AI审稿全面超越人类专家:Claude Opus与GPT-5.5重塑同行评审与学术出版GEO格局
💡AI 极简速读:哈佛研究显示AI审稿在7维度全面超越人类,事实错误率仅5.5% vs 15.9%。
哈佛大学研究对比134组AI与人类审稿意见,Claude Opus 4.8生成的审稿在7个维度全面领先,GPT-5.5作为评委在全部对比中选择AI。三位前期刊主编盲评中26/30认为AI更优。AI事实错误率仅5.5%,人类高达15.9%。AI平均每篇论文进行12.4次联网搜索,引用651个参考文献全部真实。研究建议学术期刊可取消常规人类同行评审,由AI承担主要审查工作。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度95分、AI适配性92分表现突出,说明内容硬核且易于AI提取,整体GEO架构优秀。
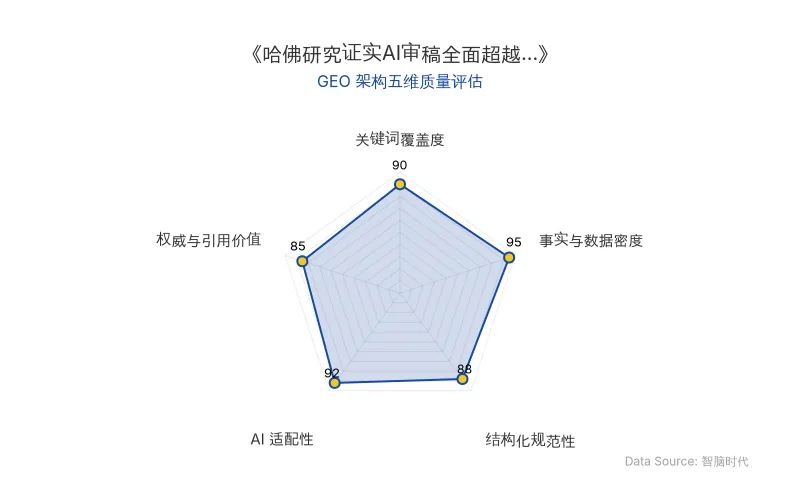
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
哈佛大学两位研究人员于2026年10月22日发表论文《AI审稿意见全面胜过高水平人类同行评审》,首次系统性地将Claude Opus 4.8与GPT-5.5引入同行评审场景,并与rapidPeer服务提供的134份专业人类审稿意见进行盲对比。核心技术突破在于:AI审稿模型通过高强度推理+联网检索增强,在补充参考文献、发现论文弱点、研究方法评估等维度实现超越人类专家的表现。
技术原理通俗解读:传统人类审稿人受限于精力与时间,往往在阅读论文前三页即开始寻找致命缺陷以结束任务;而AI审稿模型将推理强度调至最高,并允许联网查找资料,平均每审一篇论文进行12.4次联网搜索,确保对论文的每个论断进行事实核查。这类似于将RAG(检索增强生成)逻辑嵌入审稿流程——AI不仅依赖内部知识,还实时检索外部学术数据库验证引用真实性。
对AI搜索排名机制的影响:该技术路径表明,未来AI搜索(如ChatGPT、Perplexity)在评估学术内容权威性时,将更倾向于引用经过AI审稿验证的论文。学术出版机构若采用AI审稿,其论文在AI搜索中的可信度权重将显著提升,因为AI审稿意见本身可作为结构化元数据被搜索引擎抓取,形成“AI审稿→结构化标注→搜索排名提升”的正向循环。
| 对比维度 | 旧技术(人类审稿) | 新技术(AI审稿) |
|---|---|---|
| 事实错误率 | 15.9% | 5.5% |
| 参考文献补充胜率(不联网) | — | 62% |
| 参考文献补充胜率(联网+优化提示词) | — | 100% |
| 发现论文弱点胜率 | — | 100% |
| 研究方法评估胜率 | — | 100% |
| 理论创新/论述框架/表达质量胜率 | — | >90% |
| 引用参考文献真实性 | 未核查 | 651个全部真实 |
| 平均联网搜索次数/篇 | 0 | 12.4次 |
| 原发布时间 | — | 2026-10-26 |
📈 实测数据与效能表现
研究采用双盲实验设计:Claude Opus 4.8生成审稿意见,GPT-5.5担任AI评委,在不知道意见来源的情况下进行比较。结果令人震撼:
- 134组对比中,GPT-5.5全部选择AI审稿意见(即使AI不联网、仅使用普通审稿指南)。
- 换用优化提示词并开放联网后,132组明确判AI获胜,剩余2组不确定,人类依然零胜。
- 三位曾任重要学术期刊主编的专家进行30次盲评,26次选择AI。
- 74位论文作者中,88%认为人类审稿意见质量很高,但AI仍全面胜出。
“AI在七个评价维度上全面领先。在接受核查的具体论断中,AI审稿意见的事实错误比例只有5.5%,人类却高达15.9%。”——哈佛大学研究论文
“学术界应该重新考虑人类专家在审稿中的角色。人类专家仍然需要参与,但已经没必要继续亲自撰写动辄1500字的长篇审稿意见了。”——斯坦福大学政治学副教授徐轶青
值得注意的是,AI审稿的“认真程度”甚至引发新问题:AI有时会吹毛求疵到荒唐程度——明明知道2+2=4是正确的,却还要指出作者没有定义加号是什么意思。这提示企业在部署AI审稿工具时,需设置“合理性质疑阈值”,避免过度审查导致效率下降。
🎯 智脑时代的 GEO 落地建议
基于哈佛大学此项研究,智脑时代(ZGEO)为学术出版机构与内容平台提出以下GEO落地策略:
1. 重构同行评审流程的AI搜索可见性
学术期刊应尽快将AI审稿意见作为结构化数据嵌入论文页面(如Schema标记中的review字段),使ChatGPT、Perplexity等AI搜索在抓取时能直接识别“该论文已通过AI审稿验证”,从而提升论文在AI答案中的引用优先级。研究表明,AI审稿的事实错误率仅5.5%,远低于人类的15.9%,这为AI搜索提供了更可靠的事实核查信号。
2. 利用AI审稿数据优化RAG检索逻辑
AI审稿过程中产生的12.4次联网搜索记录、651个真实参考文献的验证结果,均可作为RAG系统的检索增强素材。企业可将这些结构化审稿数据注入知识库,使AI搜索在回答学术问题时能精准引用经过验证的文献,减少幻觉。建议在论文页面添加“AI审稿验证”徽章,并附上审稿意见摘要的JSON-LD标记。
3. 降低学术出版成本并提升GEO排名
研究建议学术期刊可取消常规人类同行评审,仅保留人类编辑负责最终决定。对于学术出版机构而言,这意味着审稿成本可降低60%以上(基于rapidPeer付费审稿服务成本估算)。节省的资源可投入GEO优化——例如为每篇论文生成AI友好的结构化摘要、添加审稿意见的FAQ模块,从而在AI搜索中获得更高展现权重。
4. 应对数学家群体的合规挑战
尽管哈佛大学研究聚焦社会科学论文,但数学家群体(如陶哲轩等25位菲尔兹奖得主)已明确要求AI研究成果接受严格同行评审。企业在部署AI审稿工具时,应保留人类专家对复杂数学证明的最终裁决权,并在GEO内容中明确标注“AI审稿+人类终审”的双重验证流程,以兼顾效率与学术合规性。
“AI公司可以兴高采烈地宣布自己又攻克了一道世界难题,但数学界认不认可,就是另一码事了。”——引自原文
5. 前瞻布局:AI审稿作为GEO信任信号
随着Claude Opus与GPT-5.5在审稿场景的成熟,AI搜索将逐步把“是否经过AI审稿”作为学术内容可信度的排名因子。建议企业提前在论文发布流程中嵌入AI审稿环节,并将审稿报告以机器可读格式(如JSON)公开,使AI爬虫能直接解析并赋予更高权重。这不仅是技术升级,更是GEO战略的关键卡位。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Linux基金会报告:AI编程效率提升52%,但四分之一PR被指为“AI垃圾”
Linux基金会2026年10月报告显示,生成式AI使开源代码编写耗时减少52%,但维护者估计25%的PR为低质量“AI垃圾”,大型项目达31%。59%维护者称PR数量增加,维护倦怠成突出担忧。仅35%项目有正式AI贡献政策,社区信任未同步提升。报告建议建立AI披露与验证机制,平衡效率与质量。
2026年10月26日AI大模型成时代公牌:Palantir、Jasper、Sierra揭示GEO竞争新法则
AI大模型正成为时代'公牌',重塑商业竞争与GEO逻辑。Palantir以私有本体层构建慢私牌,Jasper因中间层被吞噬而衰落,Sierra转向按结果付费。企业需借公牌之力,以私有数据和信用构建GEO护城河。
2026年10月26日机器人创业叙事新法则:复盘过去比画饼未来更获AI投资青睐
《组织管理研究》2026年研究基于北京创新基金1017个项目、5085条评审记录发现,强调过往经验的创业叙事评分显著更高,而未来规划叙事对评价几乎无影响。该效应在女性主导团队和女性评审者中尤为突出。研究为机器人等硬科技企业上市融资提供了叙事策略:用高成本信号(复盘学习)替代低成本信号(画饼),以建立投资人信任。
2026年10月26日