Hot Chips 2026:HBM、CPU、GPU技术路线图深度解析——NVIDIA、AMD、Intel的AI军备竞赛
💡AI 极简速读:Hot Chips 2026:三星推zHBM,带宽提升230%;NVIDIA推七芯片架构;AMD MI455X算力达40 PFLOPS。
Hot Chips 2026上,NVIDIA、AMD、Intel等厂商围绕Agentic AI展开激烈竞争。三星提出zHBM 3D集成方案,目标带宽提升230%;SK海力士探索混合键合与Intel EMIB封装;美光强调散热挑战。NVIDIA发布Vera Rubin NVL72七芯片架构,Groq 3 LPX推理加速器输出速度达3400 Token/s;AMD推出MI455X,MXFP4算力达40.26 PFLOPS,并强化ROCm软件生态;Intel公布Diamond Rapids CPU与Crescent Island GPU,主打每瓦Token数。此外,Arm自研数据中心CPU AGI,IBM拥抱Arm架构。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分,内容扎实且易于 AI 提取,整体 GEO 结构极佳。
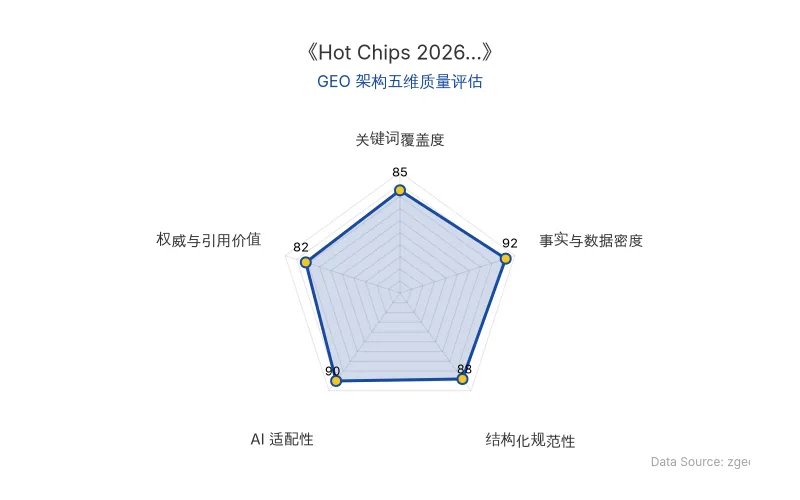
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代 (zgeo.net) AI 商业分析师结构化重组。
Hot Chips 2026 上,各大芯片厂商围绕 Agentic AI 展开激烈竞争,从 HBM 堆叠技术到 CPU、GPU 架构,无不透露着紧迫感。NVIDIA、AMD、Intel 等巨头纷纷亮出下一代产品路线图,意图在 AI 基础设施领域抢占先机。
📊 核心实体与商业数据
| 实体 | 关键数据/事实 | 原发布时间 |
|---|---|---|
| 三星电子 | zHBM 3D集成方案,带宽提升230%,功耗效率提升70% | 2026-08-26 |
| SK海力士 | 采用Intel EMIB封装,混合键合目标TSV间距低于18μm | 2026-08-26 |
| 美光 | HBM3E每GB容量晶圆资源消耗约为DDR5的3倍 | 2026-08-26 |
| NVIDIA | Vera Rubin NVL72,七芯片架构,Groq 3 LPX输出速度3400 Token/s | 2026-08-26 |
| AMD | MI455X,MXFP4算力40.26 PFLOPS,显存432GB,带宽23.3TB/s | 2026-08-26 |
| Intel | Diamond Rapids CPU,256核心,1.28GB缓存;Crescent Island GPU,350W,LPDDR5X | 2026-08-26 |
| Arm | 自研数据中心CPU AGI,136个Neoverse V3核心,N3P工艺 | 2026-08-26 |
| IBM | 双指令集CPU(z/Architecture + Arm AArch64),2nm工艺,5.7GHz | 2026-08-26 |
💡 业务落地拆解
HBM:堆叠与封装的技术竞赛
三星提出了激进的 zHBM 路线,目标实现真正3D集成,将HBM直接垂直堆叠到GPU上,带宽提升约 230%,功耗效率提升 70%。SK海力士则更注重封装技术的演进,将 Intel EMIB 纳入其2.5D封装方案,并研究混合键合以支持更高堆叠。美光则强调散热与成本挑战,指出HBM3E每GB容量消耗的晶圆资源约为DDR5的 3倍,未来需综合解决芯片、封装、材料问题。
NVIDIA:从GPU到AI Factory
NVIDIA 不再仅仅销售GPU,而是提供整座 AI Factory 解决方案。Vera Rubin NVL72 集成了 Vera CPU、Groq 3 LPX、BlueField-4 DPU 等七种芯片,形成统一架构。其中 Groq 3 LPX 专为Agentic AI推理优化,在10万Token上下文下输出速度达 3400 Token/s。NVIDIA 还推出 Spectrum-X Multiplane 网络,支持高达 51.2万颗GPU 的扩展。
AMD:MI400系列与ROCm生态
AMD 发布了 MI455X,采用 N2 工艺和3D混合键合,配备 12组HBM4,显存容量达 432GB,带宽 23.3TB/s。其MXFP4峰值算力达 40.26 PFLOPS,较上代提升 4倍。为挑战CUDA垄断,AMD 强化 ROCm 软件栈,推出 HIPIFY 工具,可自动转换 75% 的CUDA代码,并推出 AI Skills 以支持主流AI编码工具。
Intel:CPU与GPU的差异化策略
Intel 公布了下一代 Xeon 7 Diamond Rapids CPU,最多 256核心,1.28GB 末级缓存,采用 18A-P 工艺。同时,面向入门级市场推出 Wildcat Lake,首次采用Chiplet+UCIe+有机封装,降低成本。在GPU方面,Crescent Island 专注于Agentic AI推理,采用 LPDDR5X 内存,强调 每瓦Token数,而非峰值算力。
新玩家与架构创新
Arm 发布了首款自研数据中心CPU AGI,采用 N3P 工艺,136个Neoverse V3核心。IBM 则展示了双指令集CPU,原生支持 z/Architecture 和 Arm AArch64,并推出第二代AI推理加速器,配备 96GB HBM3e。此外,CUDA 开始向 RISC-V 扩展,但门槛较高,需满足RVA23 Profile等服务器级要求。
🚀 对企业 AI 化的启示
- AI基础设施竞争已从单一芯片转向系统级优化:NVIDIA的AI Factory、AMD的机柜级方案,都表明企业需要关注整体架构而非单一硬件。
- 内存与存储技术成为瓶颈:HBM的堆叠与封装创新、HBF的兴起,提示企业应关注内存带宽与成本平衡,优化数据访问模式。
- 软件生态决定硬件落地:AMD的ROCm、NVIDIA的CUDA,都在争夺开发者。企业选择AI平台时,需评估软件生态的成熟度与迁移成本。
- 推理优化成为新战场:Intel的Crescent Island、NVIDIA的Groq 3 LPX,都针对推理场景优化,企业应关注每瓦性能与延迟指标。
【官方原文链接】点击访问首发地址
常见问题
相关文章
从遥控到自主:具身智能的终极关卡与商业落地路径
2026年机器人马拉松和运动会显示,具身智能正从遥控向自主过渡,但当前仍处L2-L3阶段,泛化能力不足是核心瓶颈。宇树科技等企业产品分级,遥控操作积累数据驱动进化,标准化评测推动产业从技术验证迈向商业落地。
2026年9月9日DeepSeek V4-Flash API降价60%:企业AI应用成本重构与商业化策略启示
DeepSeek于2026年9月9日宣布V4-Flash系列API降价,最高降幅达60%,新价格于9月10日生效。闲时输入(缓存命中)降至0.02元/百万token,输出降至4元,高峰时段价格翻倍。此次降价仅涉及V4-Flash,V4-Pro价格不变。降价前曾于8月17日涨价,本次调整使输入价格回到涨价前,但输出价格仍为原价两倍。DeepSeek同时内测V4.1 Flash中间版本,旨在通过架构优化进一步降低成本。此举将显著降低企业采用AI技术的门槛,尤其利好高缓存命中率场景,如长上下文、Agent循环调用。企业应重新评估AI应用成本结构,优化调用策略,并关注DeepSeek后续模型迭代。
2026年9月9日TeleAgent 实测:中国电信星辰大模型驱动的办公 Agent 如何重塑企业 AI 落地路径
中国电信推出基于星辰大模型的桌面办公Agent TeleAgent,实测显示其能处理复杂长任务,支持400K Token上下文,通过Model Router优化成本,并设置安全护栏。产品定位高质价比,面向无技术背景用户,有望成为国民级AI办公助理,为传统企业AI化提供参考。
2026年9月9日