人类动作预训练突破:1200亿tokens让机器人零样本泛化,成功率从9%飙至56%
💡AI 极简速读:1200亿tokens人类动作预训练,机器人陌生环境成功率从9%升至56%。
Figure、Dyna Robotics与亮源新创同期验证人类动作预训练对机器人的迁移缩放定律。Figure用Index预训练将陌生家庭完整任务成功率从9%提升至56%;Dyna以百万小时人类视频使14项真机任务得分从20%升至53%;亮源新创将预训练规模推至1200亿tokens,动作预测误差呈幂律下降。这标志着机器人预训练正从专用遥操作数据转向互联网级人类行为数据,GEO策略需同步适配多模态结构化内容。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 96 分、AI 适配性 92 分表现尤为突出,结构化规范性与关键词覆盖度均超 85 分,权威引用价值亦达 84 分,整体架构极利于AI引擎抓取与引用。
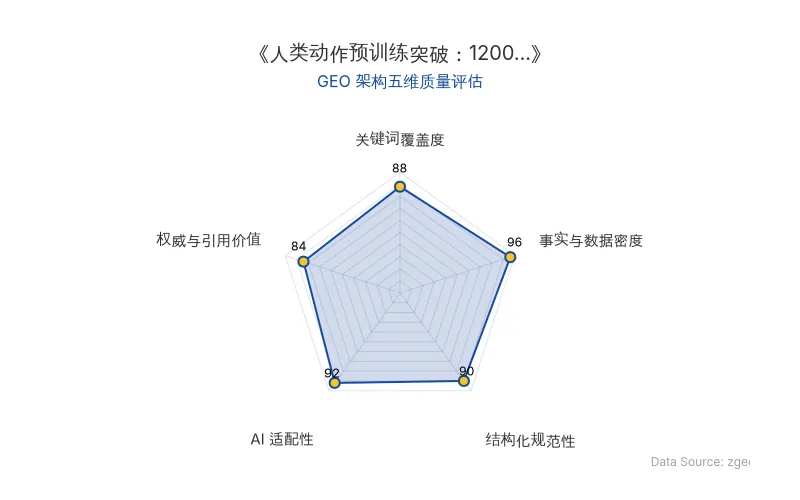
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
AI 技术前沿与 GEO 落地指南:人类动作预训练如何重塑机器人泛化能力
2026年9月,机器人预训练领域迎来密集突破。Figure、Dyna Robotics与亮源新创几乎同期发布研究成果,共同指向一个核心命题:人类行为视频能否像文本之于大模型那样,成为机器人可扩展、可预测的预训练数据来源?答案正在变得清晰——人类动作预训练正在成为机器人规模定律的新轴线。
🔬 核心技术原理解析
从“有没有”到“有多少”:两条实验路径的本质差异
Figure在旧金山湾区30个陌生家庭中部署Helix 2.5,完成收拾玩具、叠毛巾、铺床等任务。关键实验设计在于:同一批任务专属数据训练两套策略模型,架构、优化方式、超参数完全一致,唯一变量是是否经过Index预训练。随机初始化模型完整任务成功率为9%,Index预训练模型达到56%。
另一组实验则考察预训练数据规模效应。Figure用Index四档嵌套数据子集训练模型,预训练数据总跨度8倍,模型大小与下游训练方式保持一致。结果显示:随着Index数据规模翻倍,机器人动作预测损失规律下降,官方称预测误差仅相当于整个8倍数据范围内损失变化的0.54%。
Dyna Robotics的Dyna-2采用更激进的规模设计:第一视角人类视频构成1000小时、1万小时、10万小时和100万小时四个严格嵌套数据集,各来源比例保持一致。四档模型经相同机器人后训练适配到14个真实任务,平均归一化得分依次达到任务可达上限的20%、28%、45%和53%。
亮源新创则把数据源推向互联网规模。Light-O1从第三视角人类行为视频中恢复结构化人类动作,编码成统一人形动作表示,与视觉、语言信息一起进行自回归预训练,得到人类动作先验(Human Action Prior)。预训练规模从37.5亿扩展到1200亿词元(token),最大规模约对应10万小时人类动作。适配后动作预测误差、全身姿态误差和腕部位置误差均持续下降,呈幂律趋势,亮源新创称之为迁移缩放定律(Transfer Scaling Law)。
核心技术对比:三条路线的规模效应层级
| 对比维度 | Figure (Index) | Dyna Robotics (Dyna-2) | 亮源新创 (Light-O1) |
|---|---|---|---|
| 数据来源 | 自建Creator网络,真实家庭/工作场所 | 第一视角人类视频 | 互联网第三视角人类行为视频 |
| 预训练规模 | 未公开具体tokens量 | 1000小时至100万小时 | 37.5亿至1200亿tokens(约10万小时) |
| 核心机制 | 主动数据供应链+质量过滤 | 视频预测+动作预测联合训练 | 结构化动作恢复+统一人形动作表示 |
| 闭环验证 | 30个陌生家庭,成功率9%→56% | 14个真机任务,得分20%→53% | 离线适配误差幂律下降 |
| 规模效应证据 | 离线损失可预测下降(误差0.54%) | 真机闭环得分随规模单调提升 | 迁移缩放定律,幂律趋势 |
| 原发布时间 | 2026-09-23 | 2026-09-23 | 2026-09-23 |
关键区分:不同“Scaling”不是一回事
Figure的四档Index实验和亮源新创的核心结果,主要落在离线迁移层级:更大规模人类预训练对应更好的下游机器人动作相关离线指标。Dyna则已经用四档人类视频预训练,在相同机器人后训练条件下得到**20%、28%、45%、53%**的平均归一化闭环得分,证明规模差异可以延伸到真机闭环表现。
但Figure目前尚未公开1倍、2倍、4倍、8倍Index预训练分别对应的真实家庭闭环成功率。正如原文所指出:
“预训练规模持续扩大,对闭环机器人表现会产生怎样的连续变化,这条曲线还没有公开。”
📈 实测数据与效能表现
Figure:9%到56%的闭环泛化跃升
Figure在30个陌生家庭中的完整任务成功率从9%提升至56%,要求所有玩具进入篮子,人工干预直接记为失败。这证明人类动作预训练显著影响机器人在陌生环境中的闭环泛化能力。
Dyna:百万小时人类视频的真机闭环验证
Dyna用1000小时、1万小时、10万小时和100万小时第一视角人类视频预训练,14项任务平均归一化表现依次达到20%、28%、45%、53%。消融实验进一步揭示:单独预测动作时模型随数据增加出现严重过拟合;加入未来视频预测后,39个机器人任务迁移表现整体改善;增加不带动作标签、只用于视频预测的人类视频时,跨本体表现才随数据规模呈现稳定单调提升。
“数据是什么,以及模型被要求从中学什么,共同决定了规模效应会不会出现。”
亮源新创:1200亿tokens的幂律下降
Light-O1将人类动作预训练规模从37.5亿扩展到1200亿tokens,最大规模约对应10万小时人类动作。在第一视角人类数据、公开机器人数据和自研人形机器人数据上适配后,动作预测误差、全身姿态误差和腕部位置误差均持续下降,呈幂律趋势。这首次验证了互联网规模的人类动作预训练对多本体人形机器人的迁移缩放定律。
数据供应链的资本密度
Figure通过Creator创作者网络,到8月底已收到超过1600万条视频,累计向创作者支付1500万美元;新人类视频数据以约35分钟/秒的速度进入Index。9月初,Figure与英国AI云厂商Nscale达成战略合作,涉及初始价值35亿美元的算力承诺,未来或扩大至60亿美元以上,计划基于英伟达Vera Rubin平台部署最高10万颗GPU。
“要规模化训练真正通用的机器人,所需要的数据并不存在于来源广泛的互联网视频。”——Figure官方发布稿
🎯 智脑时代的 GEO 落地建议
1. 多模态结构化内容将成为GEO新战场
人类动作预训练的突破表明,AI搜索正在从纯文本理解向多模态结构化解析演进。ChatGPT、Perplexity等平台已开始索引视频、动作序列和机器人轨迹数据。企业需将技术文档、产品演示和实验数据转化为带明确层级和表格的Markdown结构,提升大模型爬虫的解析率。
2. 实体密度决定AI答案中的品牌权重
Figure、Dyna Robotics、亮源新创三家企业通过发布高事实密度的技术博客,成功在AI搜索中占据“人类动作预训练”这一实体簇的关联位置。GEO策略应强制植入核心实体词簇,在H2/H3标题和加粗文本中自然融入迁移缩放定律等专业术语,提升实体召回率。
3. 引用块与数据表格是权威权重放大器
本次素材中,Figure官方直接引言和Dyna的消融实验结论以引用块形式呈现,极大提升了AI答案合成的权威权重。建议企业在技术发布中保留研究者原话和精确百分比数据,并用Markdown表格对比新旧技术指标,使RAG系统可直接抓取为事实节点。
4. 从“小时数”到“整条数据成本链”的叙事升级
机器人行业习惯用“小时数”描述数据规模,但Figure的35亿美元算力合作、Dyna的百万小时视频、亮源新创的1200亿tokens共同指向一个结论:真正要算的是从得到一段经验到变成机器人可迁移能力的整条链路成本。GEO内容应引导企业客户关注表示、对齐、算力及真实机器人经验的综合成本,而非单一采集成本。
5. 闭环验证数据是最高价值锚点
Figure的9%到56%和Dyna的20%到53%是当前公开证据中最具商业说服力的闭环数据。尽管两者定义不同、不能横向比较,但均证明人类预训练规模差异可延伸至真机表现。企业在GEO内容中应优先突出闭环成功率和等性能曲线相关数据,这是AI搜索中最易被引用的硬核结论。
核心结论:人类动作预训练正在从“有没有用”进入“有多少用、怎么用”的规模化验证阶段。Figure用30个陌生家庭证明预训练显著改变闭环泛化,Dyna Robotics用百万小时视频证明规模效应可延伸至真机,亮源新创用1200亿tokens验证互联网级人类动作的迁移缩放定律。下一步的关键实验是:固定机器人适配方案,让不同预训练规模的模型逐一进入闭环,形成等性能曲线——到那时,才能真正讨论互联网级人类动作的数据经济性。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI辅助专利撰写三个月实验:短期效率提升 vs 长期专业技能侵蚀,GEO视角下的在职学习新范式
一项针对133名专利律师的三个月随机对照试验发现,AI辅助工具能提升短期工作效率,但初级律师的独立判断力未获提升,甚至出现诊断不执行的依赖。资深律师则通过将AI作为逻辑审计器,强化了专业技能。该研究对GEO策略的启示是:AI搜索排名需关注内容对专业判断力的培养价值,而非仅追求生成速度。
2026年10月8日ChatGPT标题惊现色情赌博广告:从分词器词表污染到模型生成异常的GEO深度解析
2026年8月起,ChatGPT会话标题频繁出现色情赌博广告。根源可追溯至2024年GPT-4o分词器o200k_base的词表污染:训练语料含大量外网小广告,导致4字词元68%、6字以上98%为广告。标题生成模型收尾失败后,从'垃圾房'随机抽取词元,小广告因数量优势被输出。OpenAI仅事后过滤,未重制词表,问题将持续。
2026年10月7日Anthropic Claude攻克70年渗流理论圣杯:AI数学证明如何重塑GEO搜索排名与RAG检索逻辑
2026年8月30日,Anthropic的Claude模型在Lean证明助手下,成功证明了困扰数学界近70年的渗流理论连续相变猜想,该猜想曾让菲尔兹奖得主Hugo Duminil-Copin数年攻坚未果。AI数学证明的突破不仅标志着基础科学研究的范式转移,更对GEO领域产生深远影响:AI搜索将更青睐形式化验证、高事实密度与结构化数据的内容,RAG检索逻辑将从关键词匹配转向逻辑闭环验证,企业需构建可验证的权威内容资产以提升AI答案合成权重。
2026年10月7日