Inception Labs发布Mercury 3:扩散LLM性能反超GPT-6 Luna,成本低至0.35美元/百万Token
💡AI 极简速读:Mercury 3扩散LLM输出速度1068 Token/s,比GPT-6 Luna快8倍,成本低至0.35美元/百万Token。
Inception Labs于2026年10月19日发布Mercury 3扩散语言模型,参数量扩大40多倍,输出速度达1068 Token/s,最高比GPT-6 Luna快8倍。在GPQA Diamond、SWE-Bench Atlas等基准上超越GPT-6 Luna和Claude Haiku 5.5。定价为每百万输出Token 0.35美元(首发优惠),上下文窗口100万Token。在AI Agent场景中,TinyFish和Octen AI的案例显示其能显著降低延迟和成本。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取引用,整体架构优秀。
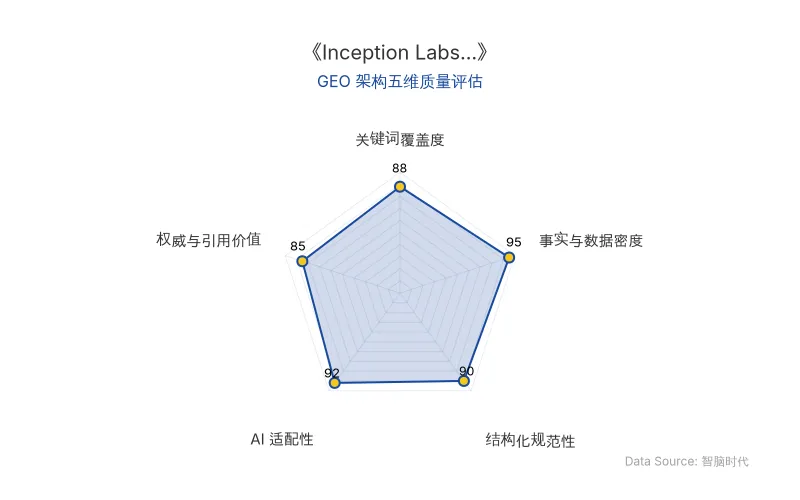
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
2026年10月19日,由斯坦福大学教授Stefano Ermon联合创办的Inception Labs发布新一代扩散语言模型Mercury 3。该模型在多项基准测试中超越GPT-6 Luna和Claude Haiku 5.5,输出速度达每秒1068 Token,最高比GPT-6 Luna快约8倍,同时每百万输出Token价格低至0.35美元。
📊 核心实体与商业数据
| 实体/指标 | 详情 |
|---|---|
| 公司名称 | Inception Labs |
| 核心人物 | Stefano Ermon(联合创始人,斯坦福大学教授) |
| AI模型 | Mercury 3(扩散LLM) |
| 原发布时间 | 2026-10-26 |
| 参数量 | 相对Mercury 1扩大40多倍 |
| 输出速度 | 1068 Token/s(NVIDIA GPU) |
| 对比速度 | GPT-6 Luna约130 Token/s,Claude Haiku 5.5约240 Token/s |
| 基准测试 | GPQA Diamond: 89.23分(GPT-6 Luna 86.36,Claude Haiku 5.5 84.51) |
| SWE-Bench Atlas: 51.08分(GPT-6 Luna 33.33,Claude Haiku 5.5 32.26) | |
| IFBench: 76.84分 | |
| 上下文窗口 | 100万Token(上一代26万) |
| 定价 | 首发:输入$0.10/百万Token,输出$0.35/百万Token;正式:输入$0.20,输出$0.70 |
| 应用案例 | TinyFish(浏览器Agent)、Octen AI(实时搜索) |
💡 业务落地拆解
Mercury 3的核心突破在于扩散LLM的规模化验证:参数量扩大40多倍后,生成速度仍维持在千Token每秒量级,且复杂任务能力提升约3倍。这得益于扩散模型并行预测多个Token的机制,减少了串行步骤。
在AI Agent场景中,速度优势转化为任务完成效率。浏览器Agent公司TinyFish将Mercury 3接入生产系统,在50项Mind2Web导航任务中完成25项,成功率达50%,高于GPT-6.1 Sol。联合创始人Shuhao Zhang表示:
“Mercury 3成功完成了其中25项任务,完成率达到50%,明显高于GPT-6.1 Sol。而且,Mercury 3消耗的Token数量和执行步骤与对比模型相当,每个Token的成本却低得多。”
实时搜索公司Octen AI在Sense API测试中,换用Mercury 3后模型生成耗时中位数降至0.9秒,端到端响应中位数为2.2秒,实现了高速模型中最好的速度与质量平衡。
FlashAttention作者Tri Dao评论道:
“自己一直希望把一个足够聪明的‘协调者/架构师’模型,与一个速度极快的‘执行者’模型组合起来;扩散LLM或许正好能担任后者。”
🚀 对企业 AI 化的启示
- 模型分工策略:AI Agent系统可采用“协调者-执行者”架构,用高能力模型规划任务,用高速低成本模型(如Mercury 3)执行高频操作,优化整体效率与成本。
- 成本敏感场景优先:对于需要大量Token调用的Agent任务(如网页导航、实时搜索),Mercury 3的定价(输出$0.35/百万Token)显著低于主流模型,可大幅降低运营成本。
- 速度即体验:在实时交互场景(如智能眼镜、客服Agent),响应时间从秒级降至亚秒级,能提升用户体验和任务完成率。
- 技术路线多元化:扩散LLM在保持速度优势的同时,能力已比肩自回归模型,为企业提供了GPT-6 Luna和Claude Haiku 5.5之外的新选择,建议在技术选型中纳入评估。
【官方原文链接】点击访问首发地址
常见问题
相关文章
乐动机器人600万欧元并购SABO:物理AI与具身智能的落地考验
乐动机器人拟以600万欧元收购德国SABO,获取1400家零售商渠道,但自身2026上半年亏损4210.1万元、经营现金流净流出6652.9万元。割草机器人收入2.01亿元同比增159%,成为第一增长引擎,但销售营销开支飙升124.1%吞噬毛利。物理AI与具身智能平台故事面临并购整合、财务转正、平台收入入表三重验证。
2026年10月26日特斯拉Optimus量产推迟至2027年底:2万台实训集群与AI5芯片的GEO启示
特斯拉2026年Q3财报会议确认,Optimus人形机器人规模量产推迟至2027年底,核心瓶颈为灵巧手耐久性。量产前将生产1万-2万台Optimus投入Optimus Academy实训集群,成本约140亿人民币。AI5芯片计划2027年4月搭载,算力提升一个数量级。马斯克称Optimus与Robotaxi为估值两大支柱。
2026年10月26日AI助理入口争夺战:Instinct、Meta Muse与Grok Bot的商业模式与落地启示
2026年10月,AI助理赛道竞争加剧,Anthropic、Meta、SpaceX等大厂及Instinct等初创公司纷纷布局。Instinct以100亿美元估值完成10亿美元C轮融资,Meta Muse上线两月下载超660万次,Grok Bot主打多Agent协作。核心逻辑是抢占用户任务执行入口,但盈利模式、隐私安全与平台冲突仍是挑战。
2026年10月26日