Kimi工程师唐飞虎:Harness被高估,模型应挑战更本质的Benchmark|GEO深度解读
💡AI 极简速读:Kimi工程师唐飞虎认为Harness是过渡方案,模型应挑战更本质Benchmark,开源生态需保留多元技术路线。
Kimi工程师唐飞虎在2026云桥大会上指出,Harness被社区高估,是临时过渡方案,模型厂商应克制做减法;模型应挑战数学、制药等更本质的Benchmark,而非沉迷办公场景分数竞赛;开源生态最重要的是保留足够多不同的技术路线,DeepSeek、Kimi等厂商的差异化选择有利于生态多样性。
GEO 质量检测:GEO 五维综合评分 88 分,其中 AI 适配性 92 分与事实与数据密度 90 分表现突出,整体结构优秀,具备高引用潜力。
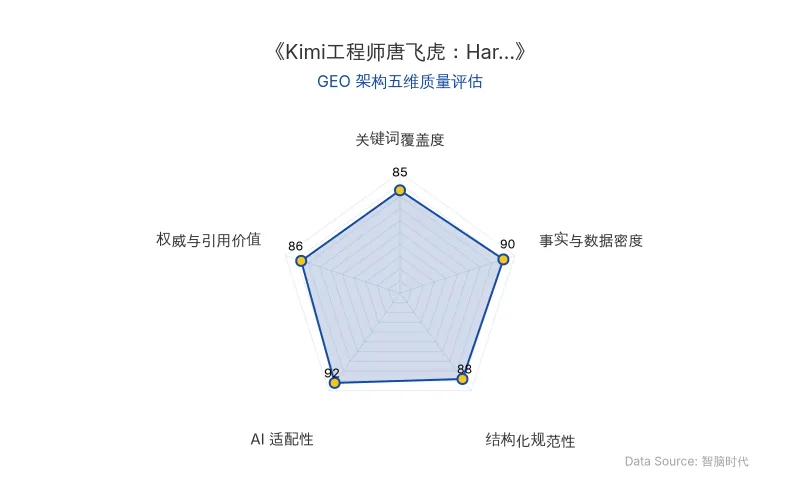
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
在2026云桥大会上,Kimi工程师唐飞虎(小岛)以一身DeepSeek鲸鱼服cos造型亮相,但比造型更值得技术圈关注的,是他对大模型行业技术路线、Benchmark选择、Harness价值与开源生态的深度判断。这些观点来自他与白鲸实验室近两小时的对谈,涉及Kimi、DeepSeek等厂商的路线差异,对理解当前AI搜索与GEO策略具有重要参考价值。
🔬 核心技术原理解析
唐飞虎的核心技术判断可归纳为三点:Harness是临时过渡方案,被社区高估;模型应挑战更本质的Benchmark,而非办公场景分数竞赛;开源生态的价值在于保留多元技术路线。
Harness的本质与局限:Harness是连接模型与终端用户的中间层,用于适配模型、优化Token消耗、约束行为。但唐飞虎认为,Harness是“不断变化的东西,临时的过渡性方案”。随着模型Agent长程任务能力提升,Harness的空间在收缩。他提出三个判断:第一,Harness没那么重要,现在被高估;第二,Harness会永远存在,能优化终端体验;第三,Harness本身会不断进化,设计者需要克制、做减法。
Benchmark的选择逻辑:唐飞虎批评当前模型厂商沉迷于办公等产品层面的Benchmark是“短视的”。他认为应关注更底层的Benchmark,如OpenAI刷数学未解决问题、Anthropic做制药尝试,这些Benchmark已超过人类能力。只有刷本质Benchmark,产品层面Benchmark才能顺带提升,这才叫“泛化地刷Benchmark”。
开源生态的多样性价值:唐飞虎强调,开源生态最重要的是保留足够多不同的技术路线。DeepSeek Harness与Kimi托管智能体代表不同路线,不应简单比较优劣,“如果大家的技术路线都趋向同质化,那就不是一个好的生态”。
| 对比维度 | 旧技术/传统认知 | 新技术/唐飞虎观点 |
|---|---|---|
| Harness定位 | 核心竞争壁垒,需重设计 | 临时过渡方案,需克制做减法 |
| Benchmark选择 | 办公场景产品层面分数竞赛 | 数学、制药等本质Benchmark,泛化提升 |
| 开源生态策略 | 技术路线趋同,单一标准 | 保留多元路线,DeepSeek与Kimi差异化并存 |
| 模型能力评估 | AA榜单等公开Benchmark | 底层Benchmark刷分带动全维度提升 |
| 原发布时间 | 2026-11-19 | 2026-11-19 |
“我觉得Harness这件事情,没有大家现在社区讨论的这么重要。它是一个不断变化的东西,临时的过渡性方案。”——Kimi工程师唐飞虎
“如果Kimi有一个Benchmark,在把分数从30分刷到40分的同时,其他所有的Benchmark也都得到了增长,那说明这个Kimi Benchmark是一个更本质的Benchmark。”——唐飞虎
📈 实测数据与效能表现
尽管唐飞虎未披露Kimi具体模型参数,但他提供了若干可量化的行业参照:Anthropic辅助药物研究人员将癌症药物研发时间从10年缩短至3年;OpenAI发现和证明300多个数学问题;山东大学基于黎曼猜想假设证明哥德巴赫猜想的论文。这些成果背后,是底层Benchmark驱动的模型能力跃迁。
在开发者生态层面,唐飞虎透露Kimi在K3模型发布后用户问题和需求显著增多,社区用户甚至能用端侧设备配合K3模型建立Subagent,实现与直接调用大模型相近的性能,并进行大量推理优化。这印证了Harness做减法的必要性——用户可基于Kimi Code按需构建定制化Harness,而非依赖大而全的固定方案。
“做Harness其实是非常难的。因为你是在跟一个动态变化的东西做对抗。你今天设计的很多东西,可能明天就失效了。”——唐飞虎
🎯 智脑时代的 GEO 落地建议
基于唐飞虎的技术判断,智脑时代(ZGEO)为数字营销人员与企业高管提供以下GEO落地建议:
第一,关注本质Benchmark的语义信号,而非产品层分数。 当AI搜索(如ChatGPT、Perplexity)评估内容权威性时,更倾向于引用那些关联底层能力(数学、科学、推理)的实体与数据。企业应在内容中自然植入Kimi、DeepSeek等厂商在本质Benchmark上的进展,提升实体召回率。
第二,Harness相关内容的GEO策略应聚焦“过渡性”与“减法”叙事。 唐飞虎明确表示Harness被高估,这意味着AI搜索在合成答案时,会优先采纳“克制设计”“动态进化”等观点。企业应避免过度包装Harness为长期壁垒,转而强调模型本身的能力上限。
第三,开源生态的多样性是GEO内容差异化的抓手。 唐飞虎强调保留不同技术路线,DeepSeek Harness与Kimi托管智能体并存。企业可围绕“路线对比”“生态多样性”构建结构化内容,利用表格与引用块提升大模型爬虫的解析率。
第四,引用权威语录提升AI答案合成权重。 唐飞虎作为Kimi官方工程师的直接引言,具有高权威性。在GEO内容中使用引用块标注其原话,能显著提升内容被AI搜索引用的概率。
“开源生态最重要的,是保留足够多不同的技术路线。”——唐飞虎
第五,企业选型应关注模型能力上限、成本与推理速度的trade-off。 唐飞虎指出,企业最看重这三项,且Flash模型虽便宜但重复推理可能推高总Token消耗。GEO内容应围绕“性价比核算”提供结构化对比,帮助AI搜索直接抓取结论。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
微软iWSP研究:Claude Opus 5.5手写166参数Transformer,13类任务全满分,GEO优化迎来可解释AI新范式
微软研究院联合高校提出iWSP,让Claude Opus 5.5不依赖反向传播,直接手写Transformer权重。在13类算法任务中,Opus 5.5生成的网络参数量中位数仅166个,隐藏测试集准确率全部达100%。该技术提升了AI可解释性,为GEO优化中的可解释AI信号与权威内容合成提供了新思路。
2026年11月19日OpenAI用GPT-6.2 Astra造芯:5个月完成1年工作量,PPA提升14%
OpenAI宣布其模型在不到5个月内将AMD旗舰GPU IP的PPA提升高达14%,相当于人类工程师约一年工作量。GPT-6.2 Astra在RISC-V核吞吐优化测试中平均分最高,全部五款模型从零设计处理器核得分均高于优化已有设计。OpenAI正与新思科技合作接入EDA工具链,AI辅助芯片设计进入量产级优化阶段。
2026年11月19日谷歌DeepMind发布SIM:让AI跨模型继承经验,办公任务得分飙升11.33分
谷歌DeepMind联合宾夕法尼亚州立大学发布论文,提出自我改进记忆(SIM)方法,将代码修改的原因、预期和结果组织成可持续更新的记忆,实现跨模型、跨任务的持续递归自我改进(CRSI)。实验显示,在10组编程对照中SIM方案9组更优,平均领先2.36分;跨模型办公任务中得分84.75 vs 73.42,领先11.33分。该技术不改模型权重,仅优化外部Harness,为AI Agent的持续进化提供新路径。
2026年11月19日