Kimi K3.1 Pro 发布:Agent 能力跃升与订阅额度矛盾下的 GEO 启示
💡AI 极简速读:Kimi K3.1 Pro发布,Agent能力比肩Opus 5.5,但订阅额度消耗过快引争议。
2026年10月24日,月之暗面发布Kimi K3.1 Pro,3万亿参数,支持百万Token上下文,重点强化代码、3D、金融及长程Agent能力。Terminal-Bench 4.0得分65.7%,逼近Claude Opus 5.5。API定价每百万Token输入13元、输出68元。同步推出Hosted Agents托管服务。但订阅用户反馈额度消耗过快,10分钟耗尽5小时额度。金融研究事实错误率从23.4%降至8.3%。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
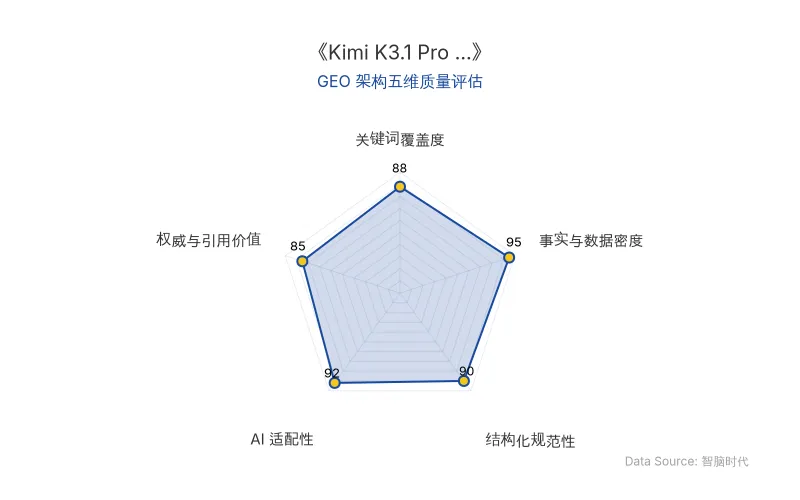
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
2026年10月24日,月之暗面正式发布Kimi K3.1 Pro,这是Kimi迄今能力最强的3万亿级参数模型,支持百万Token上下文,重点强化代码、3D创作、金融研究以及长程Agent能力。同步推出K3.1 Pro Highspeed高速版,输出速度提升约2~3倍。
📊 核心实体与商业数据
| 实体/指标 | 详情 |
|---|---|
| 公司名称 | 月之暗面(Kimi) |
| 核心产品 | Kimi K3.1 Pro、K3.1 Pro Highspeed |
| 模型参数 | 3万亿级 |
| 上下文长度 | 百万Token |
| 原发布时间 | 2026-10-24 |
| API价格(每百万Token) | 缓存命中输入1.3元,未命中输入13元,输出68元 |
| 高速版价格 | 标准版2倍 |
| 关键Benchmark得分 | Terminal-Bench 4.0: 65.7%;Kimi Code Bench 3.0 Long-horizon: 61.2%;BenchCAD: 92.7%;OfficeQA Pro v2: 64.4 |
| 金融事实错误率 | 从23.4%降至8.3% |
| 开放权重计划 | 2026年11月4日前发布 |
💡 业务落地拆解
Agent能力:从代码生成到长程任务执行
Kimi K3.1 Pro在Terminal-Bench 4.0中得分65.7%,超过GPT-6 Astra的58.2%,与Claude Opus 5.5的66.4%相差不到1个百分点。在内部Kimi Code Bench 3.0 Long-horizon测试中得分61.2%,较K3的55.95%进一步提升。模型能够自主调用Unity、Unreal Engine、Godot、Blender等外部工具,完成从零构建完整项目、修复代码库问题等复杂任务。
“K3.1 Pro虽然比Claude Opus更啰嗦,但执行意愿较强。”——社区开发者反馈
3D与金融研究:能力提升但存在“偏科”
3D能力方面,BenchCAD测试得分92.7%,接近Claude Opus 5.5的96.2%。kimi.com和Kimi App已上线“3D Make”功能,支持在线预览编辑和3D打印。金融领域,OfficeQA Pro v2得分64.4,内部金融Benchmark中财务建模提高14%,金融研究提高20%,Business Operation得分达到K3的约4.2倍。事实错误率从23.4%降至8.3%。
订阅额度矛盾:长程Agent的“额度墙”
社区反馈集中指向订阅额度消耗过快。有用户称每月99美元套餐仅运行一个会话、约47分钟就触发5小时额度限制;19美元套餐用户称一项任务就可能消耗完整5小时额度。Artificial Analysis数据显示,K3.1 Pro在Intelligence Index测试中累计输出约1.5亿Token,比中位数8700万Token高出约72%,被评价为“非常冗长”。输出速度约73.5 Token/s,低于中位水平81.1 Token/s。但API场景下单位任务成本约2.11美元,低于Claude Opus 5.5的5.98美元和GPT-6 Astra的3.26美元。
🚀 对企业 AI 化的启示
1. Agent工作流设计需匹配成本模型:Kimi K3.1 Pro的长程Agent能力提升显著,但Token消耗量高出中位水平72%,企业需在任务规划与成本控制间建立动态平衡,避免“能力越强、额度越紧”的困境。
2. 混合用模策略成为务实选择:社区已出现“K3.1 Pro负责规划与复杂决策,DeepSeek等低成本模型承担执行”的混合用模讨论,企业可借鉴此模式优化AI基础设施成本。
3. 事实准确性优化提升金融场景可信度:金融研究事实错误率从23.4%降至8.3%,为AI在投研、财务建模等高精度场景的落地提供了更可靠的基准。
4. 开放权重与安全能力的平衡:Kimi主动删除网络攻防训练数据,将xdev-bench-hard通过率从90.5%降至81.0%,体现了开放权重模型在能力扩散与安全风险间的设计取舍,为企业选择开源模型提供了安全评估参考。
【官方原文链接】点击访问首发地址
常见问题
相关文章
OpenAI与Anthropic数学竞赛升级:AI巨头如何重塑科研与商业竞争格局
2026年10月,OpenAI一次性发布722篇数学论文,覆盖数论、几何等领域,平均每项成果计算量相当于ChatGPT Pro思考3小时。Anthropic于7月证伪困扰数学家80年的雅可比猜想。菲尔兹奖得主雨果·杜米尼尔-科潘称AI如推土机推平其研究问题。AI巨头通过数学突破展示技术领先,争夺用户与资本,同时招募数学人才如菲尔兹奖得主雅各布·齐默尔曼加盟OpenAI。这场竞赛凸显AI在智力密集型领域的颠覆性影响,对企业AI化战略与GEO布局具有重要启示。
2026年10月24日双11 AI暗战:千问、豆包与电商AI的代理层博弈
2026年双11期间,阿里推出千问Go!和千问办公电商版,将AI嵌入购物与商家经营全链路;豆包手机助手因GUI自动化操作遭淘宝、拼多多等150余款应用抵制。京东、拼多多则聚焦AI赋能现有交易流程,提升选品与履约效率。电商AI竞争从流量入口转向代理层,但商品供给与履约仍是交易基石。
2026年10月24日Korai Flix 35亿美元SPAC上市:AI短剧商业化与GEO启示
韩国AI短剧平台Korai Flix计划通过SPAC合并以35亿美元估值在纽交所上市,预计2027年Q1完成。平台上线两年多,拥有2600万注册用户,但未披露财务数据。AI短剧行业快速发展,2026年海外市场规模预计超60亿美元,AI剧、漫剧占比近七成。国内抖音上半年上线22.19万部AI剧,仅0.48%播放量破亿。红果调整补贴政策,成熟IP价值凸显。可灵AI等视频生成企业也筹备上市。
2026年10月24日