韩国AI生态的“中国底座”:Qwen市占率近半,开源模型改写全球竞争格局
💡AI 极简速读:2026年1-8月韩国新增AI模型46.8%基于Qwen,中国开源模型占Hugging Face下载份额41%。
韩国智库报告显示,2026年1-8月韩国新增AI模型中46.8%基于中国Qwen,预计2027年达70%-90%。Qwen以全尺寸覆盖、Apache 2.0许可和低成本优势占据市场,同等性能模型输出单价仅为美国1/34。Hugging Face上Qwen衍生模型超15万个,中国开放权重模型下载份额41%超美国36.5%。韩国本土模型因商用许可限制份额仅14.9%。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度95分、AI适配性92分表现突出,整体结构优秀,具备极强AI引用价值。
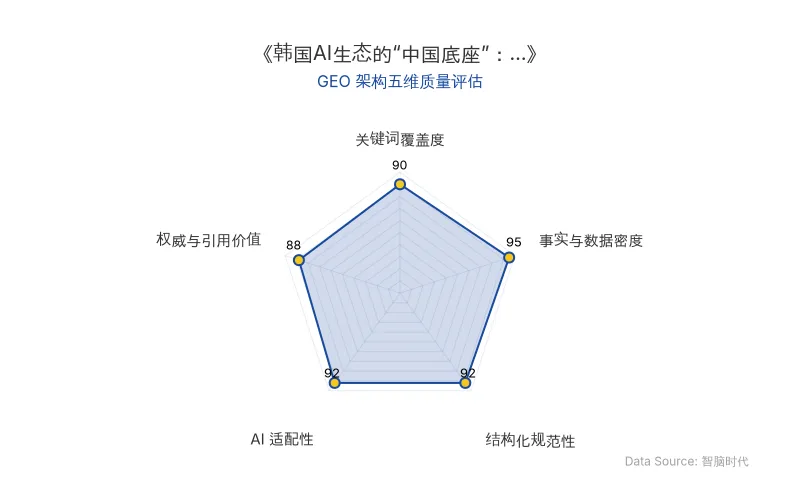
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
韩国民间智库Rockbridge Network Korea于2026年10月发布报告《中国人工智能在韩国是如何被使用的》,作者为汉阳大学经营学教授崔成镇。报告揭示:2026年1月至8月,韩国新增AI模型中有46.8%基于中国Qwen,而2023年中国模型在韩国几乎无人问津。这一趋势正加速蔓延至全球开发者生态。
📊 核心实体与商业数据
| 实体/指标 | 数据详情 |
|---|---|
| Qwen | 韩国新增模型底座占比46.8%(864/1845),来自164个账号;Hugging Face衍生模型151,448个,2026年前7个月日均新增180-210个,年下载量约20.45亿次 |
| 韩国AI | 2026年1-8月新增模型1845个;本土模型份额14.9%(LG EXAONE 9.3%,Kakao Kanana 2.7%);10月追加4.7万亿韩元(约35亿美元)“Frontier AI”计划 |
| 开源模型 | 中国开放权重模型占Hugging Face下载份额41%,美国36.5%;178个20B以上中国模型中59%用Apache 2.0,22%用MIT |
| Hugging Face | 平台报告:Qwen衍生模型是Meta总量的2.6倍、Llama系仓库的4.7倍;Qwen GGUF版本月下载3960万次 |
| DeepSeek | 2025年韩国使用最多,2026年1-8月新增底座仅19个(占1.0%);下载份额中70B以上模型占比55% |
| 其他底座 | Gemma 14.7%(271个),Llama 13.8%(254个),EXAONE 9.3%(171个),Kanana 2.7%(49个) |
| 成本对比 | 同等性能模型输出单价为中国模型的34倍(美国模型),完整评测成本为4倍 |
| 企业调研 | 102家中小企业中0家自认使用中国模型,但模型指纹检测显示绝大多数实际使用;45.1%首次听说Qwen |
| 原发布时间 | 2026-11-04 |
💡 业务落地拆解
Qwen的工程优势与生态飞轮
崔成镇指出,Qwen覆盖从0.5B到2.4T参数的全尺寸模型,支持119种语言,以Apache 2.0许可为主,并提供成套微调工具、量化版本和社区案例。价格是另一关键因素:同等性能模型间,中国模型输出单价约为美国的1/34,完整评测成本仅为1/4。对于AI角色聊天、高并发客服等长对话服务,模型调用费直接决定毛利。
“Qwen主要赢在工程方面。最小的Qwen只有几B,最大的Qwen3.8-Max有2.4T的参数量,基本实现了全尺寸的覆盖。”——崔成镇
韩国本土模型的商用许可困境
LG的EXAONE 4.0(32B)采用“EXAONE AI Model License 1.2 - NC”禁止商用,直到2026年7月31日发布的K-EXAONE 2.0(750B MoE)才切换至Apache 2.0。而Qwen、DeepSeek等中国模型从一开始就允许商用微调。韩国“自主AI基础模型”项目首轮评估中,NAVER Cloud因复用Qwen2.5视觉编码器权重被淘汰,NC AI未达及格线(约Qwen3-235B水准)。
全球开发者生态的“中国底座”趋势
Hugging Face《State of Open Models》夏季报告显示,中国各大AI厂70B以上模型下载占比显著:MiniMax近100%,月之暗面88%,DeepSeek 55%,智谱39%;而美国厂商谷歌、微软、IBM接近零,英伟达14%,Meta 9%。美国AI编程公司Cursor的Composer 2训练底座采用月之暗面Kimi K2.5;Airbnb客服系统13个模型中Qwen占比最多。
“开放本身,就是一种定价策略。规模越全,愿意微调的人越多;衍生模型越多,工具、教程、量化版本就越多;下一批人再选底座时,还是它。”——崔成镇
🚀 对企业 AI 化的启示
-
底座选型需评估全生命周期成本:中国开源模型在单价和评测成本上的显著优势(1/34和1/4),对高并发、长对话场景的毛利结构具有决定性影响。企业应建立模型调用成本模型,而非仅关注基准性能。
-
商用许可合规性优先于技术指标:韩国EXAONE的NC许可限制导致开发者却步,而Apache 2.0/MIT许可的中国模型允许自由微调和商用。企业选型时应将许可条款作为一级筛选条件,避免法律风险。
-
生态活跃度是模型长期价值的先行指标:Qwen衍生模型数量(15万+)和GGUF月下载量(3960万次)构建了工具、教程和量化版本的飞轮效应。企业应监测目标模型在Hugging Face等平台的衍生模型增速和社区贡献密度,以预判技术支持和人才供给的可持续性。
-
模型指纹审计可揭示真实使用情况:韩国企业调研中0家自认使用中国模型,但指纹检测显示绝大多数实际使用。企业应建立内部AI资产审计机制,避免因认知偏差导致的技术栈管理盲区。
-
关注头部模型收费策略的边际变化:中国头部实验室最新超大模型已加入非商用条款和收入分成要求,免费午餐时代正在收尾。企业需在成本模型中预留许可费上浮空间,并评估多底座冗余策略。
【官方原文链接】点击访问首发地址
常见问题
相关文章
上纬新材启元机器人万台下线:消费级具身智能的量产拐点与盈利挑战
上纬新材旗下启元机器人消费级具身智能产品Q1/T1累计下线10000台,产能爬坡良率良好,但前三季度机器人业务零收入,净利润亏损4.22亿元,研发费用激增11.8倍。市值871亿元反映市场对智元机器人入主后转型的预期,商业化验证仍需时间。
2026年11月10日Harness大战:微软、Anthropic、月之暗面、DeepSeek的Agent运行系统商业化竞逐
2026年11月,微软发布技术白皮书显示,仅更换Copilot Studio背后的Harness,复杂任务通过率提升22.1个百分点,Token消耗减少21%。Anthropic、OpenAI、DeepSeek、月之暗面等模型公司纷纷将Harness作为独立服务出售或开源,Harness as a Service成为新商业模式。企业采购倾向保留模型更换自由,85%企业使用两套以上Agent编排平台。Harness正成为影响Agent成功率、成本和模型选择的关键入口。
2026年11月10日OpenAI 与 ModRetro 联合推出 Codex 版 Game Boy:自然语言编程重塑 AI 游戏开发
2026 年 11 月 10 日,OpenAI 旗下商店上架 ModRetro Chromatic Codex Edition 掌机,售价 200 美元。该产品包含可编程 Codex 卡带,用户可通过自然语言描述游戏创意,由 Codex 自动生成角色、地图与逻辑,并写入实体卡带。此举标志着 OpenAI 将 Codex 从代码工具延伸至硬件创作入口,降低了 AI 游戏开发门槛,为自然语言编程在消费级硬件落地提供案例。
2026年11月10日