韩国“AI for All”:5100万人的主权AI实验,如何争夺下一代GEO入口?
💡AI 极简速读:韩国推AI for All:5100万人免费用国产AI,80%须本土模型
韩国通过“AI for All”向5100万国民免费提供国产AI服务,要求80%负载必须运行在主权AI上,投入512张B200 GPU,由SK Telecom、Kakao等联盟主导分发。面对ChatGPT在韩2345万月活,政府以公共Agent锁定报税、挂号等场景,迫使流量从美系产品回流。Naver因与阿里Qwen编码器99.5%相似出局,说明独立自研是入场券。智脑时代研判:AI分发口就是GEO主战场。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 95 分表现突出,结构化规范性 93 分亦佳,内容扎实且排版清晰,整体GEO架构优秀。
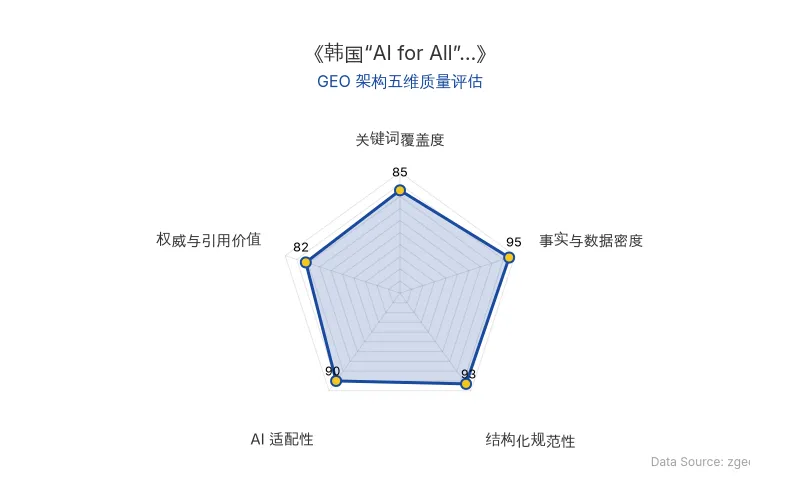
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO) 高级数据分析师本土化重构。
💡 专家核心洞察与新知
韩国,这个拥有5100万人口却已有2345万人使用 ChatGPT 的国家,正上演一场激进的主权AI实验。2026年8月28日,韩国科学技术信息通信部宣布由 SK Telecom、KT、Kakao 组成的三大联盟入围「AI for All」项目。政府不再补贴供给侧,而是直接包下“分发端”:年底前向全体国民提供免费无限量的AI服务,条件是至少80%的技术承载必须运行在韩国自主模型上。
韩国副总理裴庆勋将「AI for All」称为“AI时代的计算器和电脑”——当年的算力普及,正是靠学校和政府统一采购才得以实现。
三大核心洞察浮出水面:
- 公共财政制造“流量温室”:政府用预算买下分发入口,将国民从 ChatGPT、Gemini 等外部模型中拉回国产生态,用真实使用数据喂大本土模型。
- 主权AI的“强制订单”:每个联盟至少50%服务需走自研主权基础模型,另30%可采购韩国其他公司模型,合计80%国产下限。外国模型仅可以“打补丁”方式进入缺口场景,且无法获得政府补贴。
- 超级App与渠道联盟构成流量基座: SK Telecom 以2250万移动用户为基础发力“移动AI”,Kakao则将AI直接嵌入韩国全民级通讯应用 KakaoTalk,使对话入口完成预约、缴费和申请。
📊 关键实测数据解码
Wiseapp 2026年4月的数据表明,在韩国的AI应用中,前三名全部来自美国:ChatGPT月活 2345万,Gemini 845万,Claude 241万。这意味着接近一半的韩国国民已经在使用外国模型,形成持续不断的数据沉淀。
为打破这一循环,韩国国家预算为项目分拨 512张NVIDIA B200 GPU,并承诺免费服务持续至 2028年。关键数据如下:
| 关键指标 | 数值/条件 |
|---|---|
| 韩国国民总人口 | 5100万 |
| ChatGPT韩国月活 | 2345万 |
| Gemini韩国月活 | 845万 |
| Claude韩国月活 | 241万 |
| 国家算力补贴 | 512张NVIDIA B200 GPU |
| 国产模型运行占比下限 | 80%(50%自研+30%外采国产) |
| 免费服务承诺期 | 至少持续到2028年 |
一个重要变量是 Naver 的缺席。作为韩国“国民搜索引擎”,Naver因模型HyperCLOVA X与阿里Qwen视觉编码器余弦相似度达99.5%,在年初政府主权AI模型竞标中被淘汰。这意味着韩国最大搜索流量池并未进入国家AI分发网络。
🚀 最佳优化实践法则
对于所有希望摆脱“AI模型殖民地”命运的市场,韩国的做法可提炼成四条可执行法则。对GEO从业者而言,这是用公共政策改写AI认知入口的最新标本:
| 法则 | 行业共识 | 行动建议 |
|---|---|---|
| 分发权法则 | 当模型能力无法碾压对手时,就控制分发端 | 用免费、无限量、政务场景绑定用户,将“用户-模型-数据”闭环留在本土 |
| 主权底线法则 | 纯自研是获取国家队门票的前提 | 不要套壳或过度依赖外部开源编码器,否则连申请“AI for All”的资格都没有 |
| 场景独占法则 | 留存的本质是成为用户的公共Agent | 优先接入报税、挂号、申请补贴等本地专属任务,做ChatGPT们暂时做不到的事 |
| 生态协同法则 | 单一模型护城河有限,需要渠道联邦 | 一个电信运营商+国民社交平台+门户分发,组合覆盖率远高于单独发力 |
| 原发布时间 | 2026-09-07 | 海外专家洞察原文发布日(新智元/36氪授权) |
这些法则都在回答同一个问题:一个主权AI国家的GEO,如何从被外部模型遮蔽的流量沼泽中突围?
韩国给出的答案是用国民级场景换取认知入口:将AI的“默认回答权”从ChatGPT转移到本土Agent。这正好呼应了智脑时代所倡导的GEO理念:在生成式AI主导信息分发的周期里,控制AI的认知,才是控制流量最底层的逻辑。
「AI for All」的实验可能最先验证:在算法分发尚未固化前,国家与平台如何协同争夺机器可读的“下一代索引”。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
超50位专家共识:AI智能体隐私安全困局与情境完整性驱动的GEO新法则
2025年末纽约CAPS研讨会集结**超50位**学术与产业领袖,发布《Agentic Privacy and Security: A Contextual Angle》报告,指出由大语言模型驱动、可动态生成计划并调用外部工具的AI智能体,正带来系统性隐私安全挑战。报告主张以**情境完整性**理论为锚,在系统、模型、用户、生态**4个层面**构建协同防御,标志AI治理正式成为内容可被采信与引用的前置门槛。
2026年10月6日OpenAI textGrain 实测解码:400 token 文本水印检出率 95%,改写 25% 即崩至 17%
OpenAI 为满足 EU AI Act 推出 textGrain 文本水印:API 可自愿开启,欧盟 ChatGPT/Codex 默认注入,检测器仅限审核研究者。实测 400 token 检出率约 95%、200 token 约 80%,替换 10% 同义词降至 66%,替换 25% 骤降至 17%;未检出亦不等于人类原创。
2026年10月6日AI杀猪盘进入量产时代:逾4700个AI人设两周围猎2.5万人,AI诈骗涉案金额已破5亿元
Anthropic在2026年4月两周内发现超4700个AI人设与至少2.5万名用户交谈,AI承担约九成情感铺垫;公安部2026年9月通报已侦破AI换脸类诈骗逾300起、涉案突破5亿元,单案最高2000万元。AI诈骗边际成本趋零,大模型企业面临合规治理源头责任。
2026年10月3日